Dec 15, 2024 | LLM (AI)
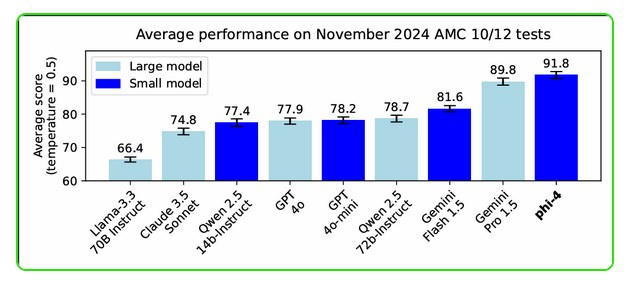
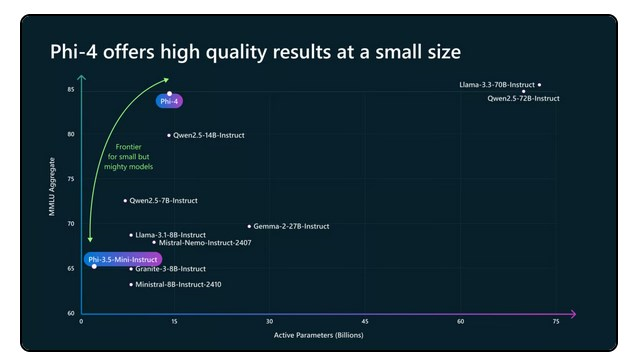
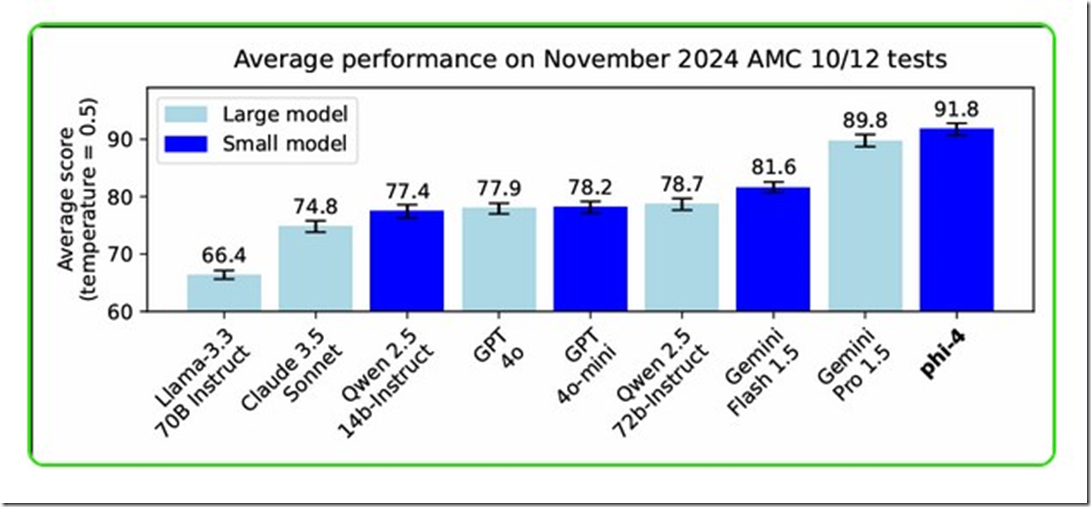
Microsoft je pravkar predstavil Phi-4, kompaktni jezikovni model z le 14 milijardami parametrov, ki se lahko kot profesionalec loti zapletenega razmišljanja.
V čem Phi-4 izstopa:
Matematične spretnosti: Prekaša veliko večje modele in je celo boljši od Gemini Pro 1.5 pri matematičnih tekmovalnih nalogah.
Učinkovita zasnova: Zaradi skrbno izbranih naborov podatkov in izboljšav po usposabljanju je majhen, vendar ima veliko moč.
Varnost : Vključuje orodja, kot so ščitniki za pozive in filtri vsebine, ki poskrbijo za odgovorne in kakovostne rezultate.
Phi-4 je zdaj na voljo v Azure AI Foundry pod Microsoftovo raziskovalno licenco, v kratkem pa bo na voljo v aplikaciji Hugging Face.
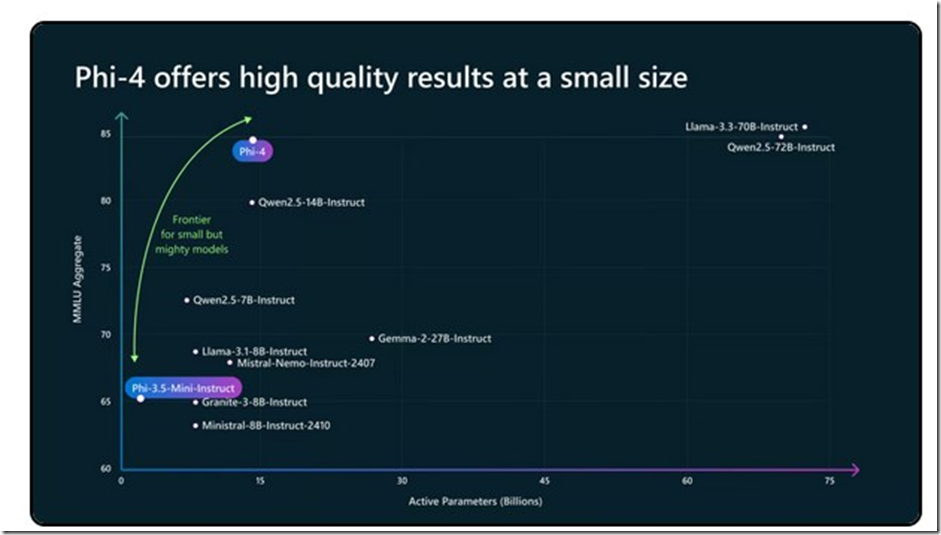
- To je Microsoftov najnovejši član družine generativnih umetnih inteligenc, ki ima 14 milijard parametrov. Zaradi boljših podatkov za učenje in pametnejšega razvoja je odlična pri nalogah, kot je reševanje težkih matematičnih problemov.
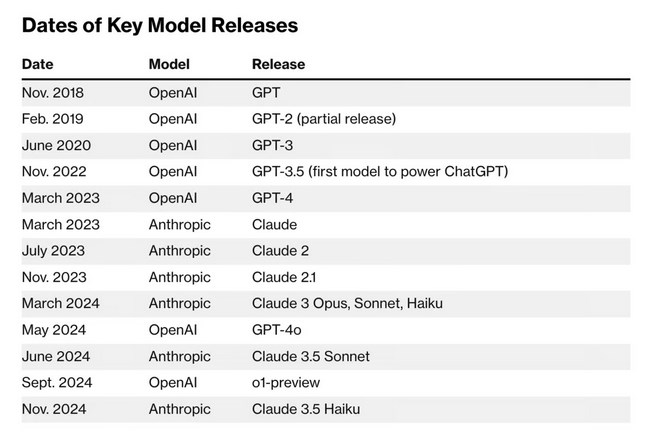
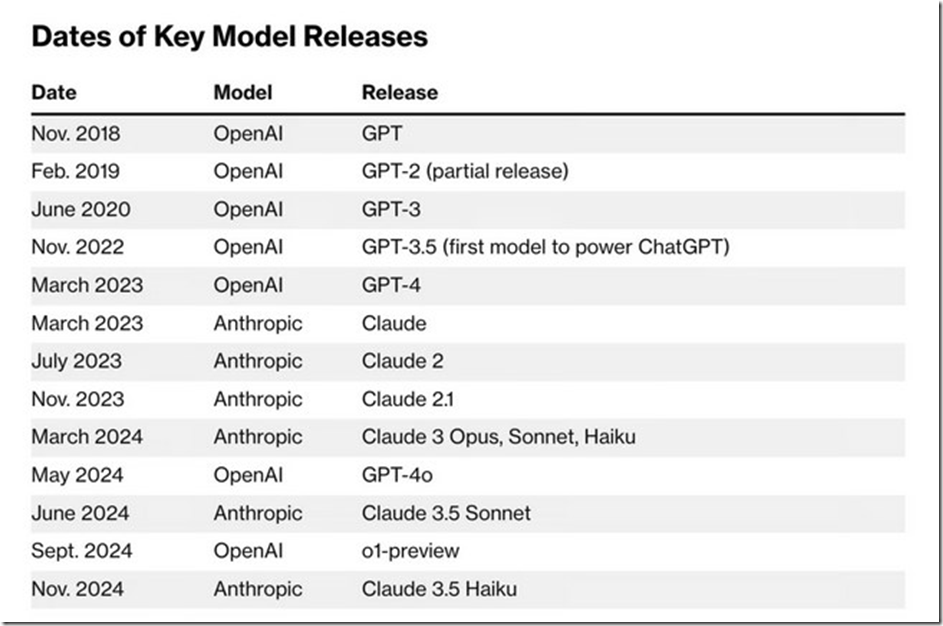
- Manjši modeli, kot je Phi-4 (poleg konkurentov, kot sta GPT-4o mini in Claude 3.5 Haiku), so vzhajajoče zvezde, saj so cenejši in hitrejši, hkrati pa še vedno zagotavljajo dobro zmogljivost.
- Model Phi-4 je pridobil podporo z visokokakovostnimi sintetičnimi in s strani ljudi ustvarjenimi podatkovnimi nizi ter nekaj skrivnostne omake pri popravkih po usposabljanju.
- Za zdaj je Phi-4 zaklenjen in na voljo le na Microsoftovi platformi Azure AI Foundry za raziskovalno uporabo.
- To je prvi model serije Phi, ki je bil predstavljen, odkar je oktobra Sébastien Bubeck, eden najboljših Microsoftovih strokovnjakov za umetno inteligenco, zapustil podjetje in odšel v OpenAI.
Nov 17, 2024 | PPC
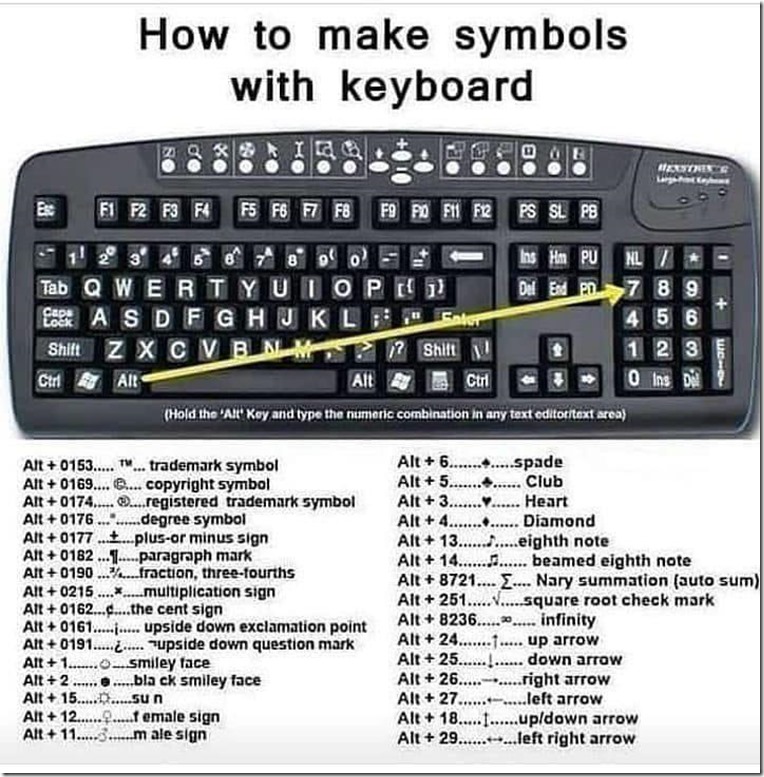
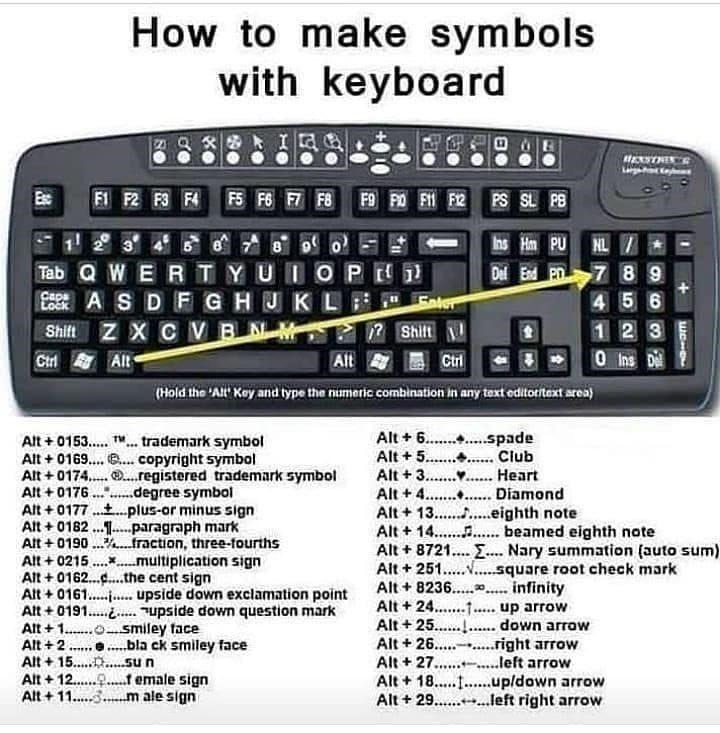
⍟℗%+*☁♥⬛#@!⍟★☆✦
✧✠✚☩⁜▲▼►◄⧬⧭○
⦾⦿✓©° ℃∞♲♼
♺♪♫®❆☻☺✆☏™☼☉
☁♠♥♣♦♡ №
Nov 4, 2024 | PPC
- Kateri dejavniki so vplivali na vašo odločitev za ustanovitev tega podjetja? Ali obstaja kakšen poseben razlog ali zgodba, ki vas je pripeljala do tega?
- Kako bi svoje podjetje opisali nekomu, ki ga ne pozna?
- Ali lahko opišete izdelke ali storitve, ki jih ponuja vaše podjetje?
- Kaj vas je spodbudilo, da ste se osredotočili na svoj glavni izdelek ali storitev? Kakšno posebno željo ali potrebo izpolnjuje?
- Po čem se vaša storitev in izdelek razlikujeta od alternativnih, vključno z možnostjo, da sploh ne uporabljate nobene podobne ponudbe?
- Kateri so vaši ključni kazalniki uspešnosti (KPI)?
- Kateri so najpogostejši razlogi, zaradi katerih stranke prenehajo uporabljati vašo storitev?
- Ali obstajajo kakšni sezonski trendi, na katere je potrebno biti pozoren?
- Ali v prihodnjem letu razmišljate o prenovi, migraciji ali preoblikovanju spletnega mesta?
- Ali imate uveljavljene smernice ali preference glede blagovne znamke, ki bi jih morali poznati? Kakšne so vaše zahteve in pričakovanja glede vsebine?
- Ali so z vašo storitvijo, izdelkom ali poslovnim modelom povezane kakšne omejitve ali slabosti?
- Ali se med prodajnim postopkom pogosto srečujete s kakšnimi pogostimi pomisleki ali ugovori potencialnih strank?
- Ali obstajajo kakšne pogoste napačne predstave ali nesporazumi, ki jih imajo stranke pogosto o vaši panogi ali rešitvah, ki jih ponujate?
- Kakšna je ciljna demografska skupina vašega podjetja?
- Kakšen je starostni razpon vašega ciljnega občinstva?
- V katero raven dohodka se običajno uvršča vaša ciljna skupina?
- Ali vaša ciljna skupina vključuje določen spol ali je bolj raznolika?
- Katere panoge ali poklicne vloge so značilne za vašo ciljno skupino?
- Kateri poklici ali panoge so običajno zastopani v vaši ciljni skupini?
- Kateri so glavni psihološki dejavniki, ki vplivajo na nakupne odločitve vaše idealne stranke?
- Kakšne koristi imajo vaše stranke od uporabe vaše storitve/izdelka?
- Katere posebne prednosti ali izboljšave imajo vaše stranke zaradi uporabe vaše storitve?
- Kako vaša storitev obravnava boleče točke oziroma težave vaših strank ali rešuje njihove izzive?
- Koliko prihodkov letno ustvari vaše podjetje? Kakšen je odstotek dobička, ki ga običajno ustvarite?
- Ali lahko navedete dodatne podrobnosti o svojih najbolj priljubljenih izdelkih ali storitvah?
- Katere druge spletne trženjske kanale trenutno uporabljate poleg PPC in SEO?
- S kakšnimi izzivi ste se srečali pri svojih trženjskih prizadevanjih? Ali lahko poveste o preteklih strategijah, ki niso bile uspešne, in pojasnite, zakaj menite, da so bile neuspešne?
- Ali lahko navedete seznam svojih glavnih konkurentov?
- Kakšna je stopnja konverzije vašega spletnega prometa?
- Kolikšna je povprečna vrednost naročila (AOV) pri vaši prodaji?
- Kolikšna je povprečna življenjska vrednost vaših strank?
Nov 2, 2024 | LLM (AI)
Prvi korak je razumevanje vašega cilja. Ali se ukvarjate z ustvarjanjem besedil, ustvarjanjem slik, klasifikacijo, regresijo ali čim drugim? Različni modeli umetne inteligence so optimizirani za različne naloge:
Modeli GPT GPT-4o IN GPT-4.0 Turbo:
Idealni so za vsestranske besedilne naloge, kot so ustvarjanje vsebine, prevajanje, povzemanje, odgovarjanje na vprašanja itd.
Za bolj zapletene poizvedbe in natančne, niansirane odgovore bo najboljša izbira model GPT-4.0 Turbo. Ta model je odličen pri sledenju navodilom po korakih, sklepanju in prepoznavanju logičnih napak.
Za hitre in človeku podobne odgovore uporabite GPT-4o, saj je ta model optimiziran za zmogljivost in učinkovitost.
Claude Haiku in Claude Sonet:
Claude 3 se odlikujeta po razširjenem kontekstualnem oknu, ki znatno izboljša njuno sposobnost za razumevanje zapletenih in dolgih informacij. Trenutno sta najboljša za naloge ustvarjalnega pisanja (pripovedovanje zgodb, dosleden ton glasu, gradnja likov itd.).
Claude Sonnet uravnoteženo usklajuje inteligentnost in hitrost.
Tako kot GPT-4o je tudi Claude Haiku kompakten model, ki omogoča skoraj takojšnje odgovore.
Claude Opus:
Claude Opus je zasnovan za opravljanje zelo zapletenih nalog (kot so interaktivno kodiranje, odkrivanje zdravil, napredna analiza financ in tržnih trendov, napovedovanje itd.) in se ponaša z izjemno zmogljivostjo, inteligenco, tekočnostjo in razumevanjem. Ponuja vrhunske zmogljivosti na različnih področjih.
Gemini:
Sposoben je obdelati več vrst podatkov, kar omogoča naloge, kot so analiza slik, povzemanje videoposnetkov in ustvarjanje glasbe iz namigov. Poleg tega lahko kritično razmišlja in analizira, hkrati pa je v stiku z besedilnimi podatki v realnem času iskalnika Google (razen Gemini 1.0 Pro), zato je idealen za reševanje problemov, odločanje in reševanje zapletenih vprašanj.
Gemini 1.5 Pro trenutno stane 20-krat več kot Gemini 1.0 Pro, tako za vhodne kot izhodne podatke, kar je mogoče pripisati njegovi boljši zmožnosti za obdelavo večjih in kompleksnejših podatkovnih nizov ter več modalno obdelavo.
Nasprotno pa ima Gemini 1.5 Flash enako ceno za vhodne in izhodne podatke kot Gemini 1.0 Pro, vendar se ponaša z najvišjimi hitrostmi obdelave, zaradi česar je idealen za naloge z velikim obsegom in kritičnimi zakasnitvami.
DALL-E:
odličen za ustvarjanje visokokakovostnih slik iz besedilnih opisov
Zaključek:
Torej če sumiramo: različni modeli umetne inteligence imajo različne stroške, ki odražajo njihovo kompleksnost in zmogljivosti. Če želite kar najbolj racionalno izkoristiti vaša sredstva, je pomembno razumeti, kdaj uporabiti posamezen model.
Osnovni modeli: GPT-3.5 Turbo in Claude 3 Haiku so stroškovno učinkoviti in so najcenejši. Ti modeli so kot nalašč za preproste naloge, pogosta testiranja in hitre iteracije, saj vam omogočajo, da izboljšate svoje pozive (prompte) za najnižjo ceno.
Napredni modeli: GPT-4o, GPT-4.0 Turbo Vision, Gemini 1.5 Pro in Claude 3 Sonnet so dražji na interakcijo. Ti modeli ponujajo izboljšane zmogljivosti in izpopolnjene izpise, zato so idealni za zahtevnejše projekte, ki zahtevajo višjo kakovost in natančnost.
Premium modeli: Claude 3 Opus in Dall-E 3 so najdražji, vendar prinašata najboljše rezultate in visokokakovostne izpise. Ne glede na to, ali ustvarjate podrobne slike ali pripravljate zapletene vsebine, ta modela zagotavljata vrhunske rezultate (kot jih pač trenutno stanje LL lahko omogoča.
Modeli, okvirno razporejni po ceni/zmogljivosti/zahtevnosti (seveda je to moja subjektivna ocena )
1. Gemini 1.0 Pro
1. Gemini 1.5 Flash
1. GPT 4o Mini
1. Claude 3 Haiku
5. GPT 4o
10. Gemini 1,5 Pro
10. GPT4.0 Turbo
10. Claude 3 Sonnet
10. Claude 3.5 Sonet
30. DALL-E 3
50. Claude 3 Opus
Oct 30, 2024 | LLM (AI)
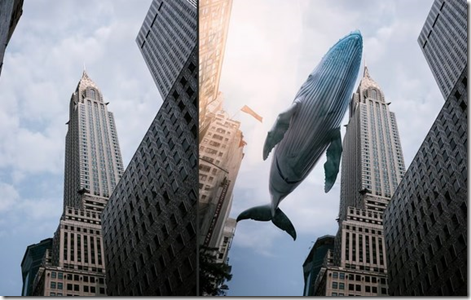 Urejanje zunanjih slik: Prvič lahko uporabniki urejajo slike, ki so jih naložili zunaj Midjourneyja. To presega generativne slike z umetno inteligenco in omogoča širši ustvarjalni nadzor.
Ponovne prilagoditve tekstur in osvetlitve: Uporabniki lahko spreminjajo teksture, materiale in osvetlitev, kar omogoča preoblikovanje nastavitev – z nekaj kliki spremenite sobo iz dnevne v nočno.
Zmožnosti za pretvorbo iz skice v umetniško delo: Uporabniki lahko naložijo preproste skice ali ročne risbe in jih spremenijo v popolnoma realizirane umetnine z oblikovanjem, podprtim z umetno inteligenco.
Izboljšave moderiranja: Da bi ohranili kakovost in varnost, Midjourney ob uvajanju te funkcije izvaja strožje protokole za moderiranje in zasebnost ( lahko si predstavljate kaj bo sledilo).
Midjourneyjev urejevalnik deluje intuitivno celo s pozivi in samodejno zazna območja za spreminjanje brez obsežnega ročnega vnosa.
Trenutno je funkcija dostopna samo dolgoletnim naročnikomz letno naročnino, tistim, ki so naročeni več kot 12 mesecev, in uporabnikom z več kot 10 000 ustvarjenimi slikami.
Oct 30, 2024 | LLM (AI)
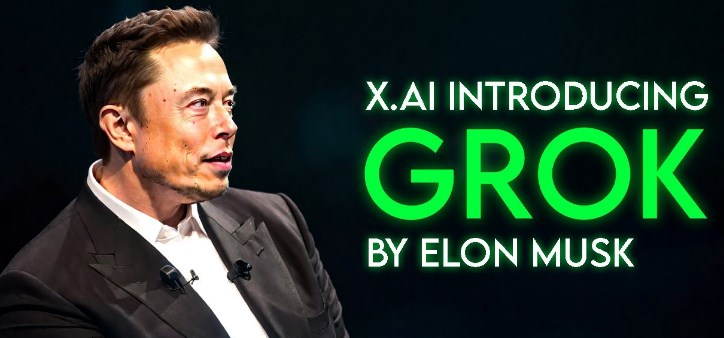
Plačljivi člani socialnega omrežja X lahko zdaj naložijo sliko in o njej postavljajo vprašanja. Funkcija je v začetni fazi, vendar Musk obljublja hitre izboljšave in mislim, da so možnosti velike.
 Večmodalne zmožnosti: Grok lahko zdaj analizira slike. Naj gre za razumevanje šale v memu ali razčlenjevanje zapletenih vizualnih podob, ta nova funkcionalnost dodaja resno vsestranskost.
Odgovori, bogati s kontekstom: Ta funkcija pomeni, da nismo več omejeni le na besedilne odgovore. Grokova vizualna analiza odpira nove možnosti uporabe – vidim aplikacije za ustvarjanje vsebine, analizo trendov v realnem času in še veliko več.
Nadgradnja posodobitev programa Grok-2: To dodaja še eno raven modelu Grok-2, ki je uvedel FLUX.1 za ustvarjanje slik. Zdaj lahko Grok slike interpretira, ne le ustvarja, s čimer je konkurenčen drugim večmodalnim orodjem umetne inteligence.
Prihodnje razumevanje dokumentov: Musk je namignil, da je podpora dokumentom naslednja na vrsti, zato bodo morda kmalu na voljo tudi datoteke PDF in druge datoteke. Všeč mi je, da xAI pri tem napreduje hitro – po Muskovih besedah v nekaj mesecih dosežejo tisto, za kar drugi potrebujejo leta.
Povečanje privlačnosti X za uporabnike Premium: Z nedavno uvedbo orodij, kot je Radar za naročnike Premium+, X dodaja pravo vrednost svojim plačljivim stopnjam. Zaradi tovrstnih funkcij je platforma veliko bolj privlačna, zlasti če iščete vpogled v trendovske teme.
Oct 30, 2024 | LLM (AI)
 Meta je pred kratkim predstavila NotebookLlama, „odprto“ različico Googlove funkcije za generiranje podkastov, ki jo najdete v programu NotebookLM. S pomočjo modelov Meta Llama lahko NotebookLlama ustvarja pogovorne, podkastne povzetke prenesenih besedilnih datotek, kot so članki v obliki PDF novic ali prispevki na blogu. Cilj te tehnologije je ponoviti vidik interaktivnega pripovedovanja zgodb Googlovega viralnega orodja in dodati lastne elemente dramatizacije in prekinitev, da vsebina zveni bolj dinamično.
Postopek se začne tako, da NotebookLlama iz naložene datoteke ustvari prepis. Nato besedilo izboljša z vključitvijo bolj dramatičnih interakcij, preden ga pretvori v zvok z uporabo odprtokodnih modelov za pretvorbo besedila v govor. Vendar kakovost teh ustvarjenih podcastov trenutno zaostaja za kakovostjo NotebookLma, saj glasovi pogosto zvenijo robotsko in se nerodno prekrivajo. Raziskovalci Meta so te pomanjkljivosti priznali in poudarili, da bi naprednejši modeli pretvorbe besedila v govor lahko bistveno izboljšali naravnost rezultatov.
Razvijalci so omenili tudi, da bi lahko trenutni pristop – uporaba enega samega modela za ustvarjanje osnutka podkasta – izboljšali tako, da bi sprejeli obliko razprave med dvema agentoma umetne inteligence, kar bi zagotovilo bogatejšo razpravo. Menijo, da bi to lahko privedlo do bolj prepričljive in skladne pripovedi podkasta. Kljub tej inovaciji je NotebookLlama tako kot druge vsebine, ki jih ustvarja umetna inteligenca, še vedno dovzetna za pogost problem „halucinacij“, kar pomeni, da lahko nekateri deli ustvarjenega podkasta vključujejo netočne ali izmišljene informacije.
Čeprav NotebookLlama ni prvi poskus posnemanja funkcije podcasta NotebookLM, je zaradi svoje odprtokodne narave in sodelovanja podjetja Meta pomemben udeleženec na tem nastajajočem področju. Možnost izboljšanja kakovosti modelov in sprejetja novih pristopov daje programu NotebookLlama prostor za prihodnji napredek, čeprav še ni dosegel povsem naravnega rezultata.
Oct 30, 2024 | LLM (AI)
OpenAI se pripravlja, da bo do decembra predstavil svoj naslednji model umetne inteligence s kodnim imenom Orion. Za razliko od prejšnjih modelov, kot sta GPT-4o in o1, sprva ne bo široko dostopen prek ChatGPT. Namesto tega namerava OpenAI omogočiti zgodnji dostop izbranim partnerskim podjetjem, ki bodo lahko z novim modelom gradila svoje izdelke in funkcije. Izvršni direktor podjetja OpenAI je Orion opisal kot potencialno 100-krat zmogljivejši od GPT-4 in naj bi napredoval v smeri splošne umetne inteligence (AGI). Ta novi model se razlikuje od reasoning modelaa (sklepanje?) o1, znanega kot Strawberry, ki ga je OpenAI objavil septembra. Poročila prav tako kažejo, da je bil Strawberry uporabljen za ustvarjanje sintetičnih podatkov za Orionov proces usposabljanja. Zaključek Orionovega usposabljanja je septembra zaznamoval slavnostni dogodek v organizaciji OpenAI, ki je sovpadal s skrivnostno objavo Sama Altmana na družbenih omrežjih, ki je namigovala na „zimska ozvezdja“, kar naj bi se nanašalo na Oriona.
Začetek delovanja Oriona se je zgodil v prelomnem času za OpenAI po zgodovinskem krogu financiranja v višini 6,6 milijarde dolarjev. Podjetje doživlja tudi pomembne spremembe v vodstvu, saj so pred kratkim svoje odhode napovedali ključne osebe, kot so simpatična tehnična direktorica Mira Murati, vodja raziskav Bob McGrew in podpredsednik za usposabljanje po končanem usposabljanju Barret Zoph.
Oct 3, 2024 | LLM (AI)
LLM so revolucionarno spremenili način interakcije s tehnologijo, oblikovali našo digitalno pokrajino in preoblikovali način komuniciranja, učenja in inovacij. V ospredju te revolucije so obsežni programi LLM, kot so OpenA GPT-4, Google LaMDA in Anthropic. Te jezikovne modele je mogoče uporabljati programsko z uporabo njihovih vmesnikov API ali prek njihovih chat gui vmesnikov. Ti vmesniki se imenujejo OpenAI ChatGPT, Google Bard oziroma Anthropic Claude (in drugi).
Inženiring GPT vnosov (promptov) je postopek oblikovanja in izpopolnjevanja vhodnih GPT vnosov (promptov) za modele LLM za doseganje želenih rezultatov. Čeprav se sprva zdi trivialno ali povsem tehnično, gre v resnici za multidisciplinarno prizadevanje. Med drugim zahteva celovito razumevanje jezikoslovja, kognitivne znanosti, umetne inteligence, oblikovanja uporabniške izkušnje in etike.
Kako vplivajo GPT vnosi (prompti)na LLM
Obsežni LLM so oblika umetne inteligence, ki se osredotoča na razumevanje in ustvarjanje človeškega jezika. Za obdelavo in analizo ogromne količine besedilnih podatkov uporabljajo izpopolnjene algoritme strojnega učenja, predvsem nevronske mreže. Glavni cilj LLM je ustvariti skladne, kontekstualno ustrezne in človeku podobne odgovore na dane vhodne pozive. Za razumevanje delovanja mehanizmov vseživljenjskega učenja je bistvenega pomena, da obravnavamo njihovo osnovno arhitekturo in postopek usposabljanja. Z uporabo nekaterih analogij za razlago teh konceptov jih bo lažje razumeti.
Arhitektura
Mreže LLM, kot je GPT-4 podjetja OpenAI, so izdelane z uporabo posebne vrste nevronske mreže, imenovane transformator. Transformatorji imajo posebno strukturo, ki jim omogoča dobro delo z besedilom.
Ena od pomembnih stvari v Transformerjih je “samopozornost”. To pomeni, da se lahko model osredotoči na različne dele stavka in se odloči, katere besede so v določenem kontekstu pomembnejše. To je kot posvečanje pozornosti besedam, ki so najpomembnejše.
Druga stvar, ki jo uporabljajo Transformerji, je pozicijsko kodiranje. To modelu pomaga slediti, kje v stavku se nahaja posamezna beseda. To je, kot da bi vsaki besedi dali posebno oznako, da bi model vedel, kje je njeno mesto v zaporedju.
S temi funkcijami lahko modeli LLM dobro obdelajo in razumejo dolga besedila. Na podlagi konteksta, v katerem se pojavljajo, lahko ugotovijo pomen besed in si zapomnijo vrstni red besed v stavku.
Usposabljanje LLM (LLM training)
Postopek usposabljanja za program LLM je sestavljen iz dveh glavnih faz: predhodnega usposabljanja in natančnega prilagajanja. Učitelji vseživljenjskega učenja so kot izredno nadarjeni učenci tujih jezikov. Med usposabljanjem gredo skozi ti dve glavni fazi.
Pred-trening (Pre-training)
V tej prvi fazi je udeleženec programa LLM izpostavljen ogromnim količinam besedil iz knjig, člankov, spletnih strani in drugih virov. To je, kot da bi lahko prebral ogromno knjižnico, polno različnih informacij.
Ko program LLM pregleda vsa ta besedila, začne zaznavati vzorce v strukturiranosti jezika. Uči se na primer naslednjih stvari:
-
Katere besede si ponavadi sledijo druga za drugo (verjetnost, da bo besedi „pes“ sledila beseda „laja“)
- Slovnico in stavčno strukturo različnih jezikov (kam gre glagol v stavku)
- Teme in pojmi, s katerimi se določene besede povezujejo (učenje, da sta „pes“ in „psička“ povezana z živalmi, hišnimi ljubljenčki itd.)
Za obdelavo vsega tega besedila ga program LLM razdeli na manjše prebavljive dele, nekako tako, kot bi jezik prežvečili na koščke. Ta postopek se imenuje drobljenje (chunking).
Program LLM razkosa stavke na manjše dele, imenovane žetoni (tokens). Žetoni so lahko posamezne besede, delne besede ali celo posebni znaki, kot so ločila.
Po razčlenitvi besedila program LLM vsak žeton vgradi ali kodira v številčni vektor, kar je podobno, kot da bi vsakemu žetonu dal matematično predstavitev – na primer psa prevede v nekaj takega kot [0,51, 0,72, 0,33,…], ki ga računalnik lahko obdela. Ta postopek se imenuje “embedding” – vgrajevanje.
To je, kot da bi stavek iz angleščine prevedli v številke. Namesto besed ima zdaj vsak znak ustrezen vektor številk, ki jih računalniki razumejo.
Ta postopek vgrajevanja zajema informacije o pomenu vsakega žetona na podlagi vzorcev, ki se jih je program LLM naučil pri obsežnem predhodnem usposabljanju. Žetoni s podobnim pomenom se v vektorskem prostoru vgradijo bližje drug drugemu.
Vsi ti numerični vektorji žetonov se shranijo v vektorsko podatkovno zbirko LLM, ki jo lahko kasneje uporabi za iskanje žetonov in analizo njihovih odnosov z drugimi žetoni. Ta baza vektorjev je kot indeks matematične knjižnice za program LLM.
V predpripravi torej mehanizem LLM oblikuje povezave med besedami in pojmi z analizo velikih količin besedila in shranjevanjem vzorcev v svojih zapletenih možganih nevronske mreže. Tako LLM shrani, da imata pes in kuža podobne vektorske predstavitve, saj imata sorodne pomene in kontekste.
Vendar pa sta si pes in kolo bolj oddaljena, saj sta pomensko različna. Vektorski prostor ureja besede glede na njihove podobnosti in razlike.

Fina prilagoditev
Po predhodnem učenju se mehanizem LLM premakne v fazo natančnega uglaševanja (fine tunning). Tu se dodatno usposobi na manjših naborih podatkov, ki so pomembni za določene naloge.
To je podobno, kot če bi se LLM po končanem splošnem izobraževanju osredotočil na posamezna področja študija, na primer na nadaljevalni pouk biologije, potem ko se je naučil osnov naravoslovja.
Pri natančnem učenju se program LLM uri v ustvarjanju rezultatov za določene naloge na podlagi označenih podatkov o primerih. Označeni podatki se nanašajo na podatke, ki so bili opremljeni z oznakami, ki kategorizirajo ali opisujejo vsebino. Te oznake pomagajo pri usposabljanju modelov, saj zagotavljajo primere pričakovanih izhodnih podatkov.
Ko programu LLM pozneje posredujete nov poziv, uporabi vzorce, pridobljene med predhodnim usposabljanjem in natančnim prilagajanjem, da analizira poziv in ustvari ustrezen odziv.
Program LLM ne razume jezika tako kot ljudje. Vendar lahko s prepoznavanjem vzorcev na podlagi množice primerov pri usposabljanju posnema človeške odzive in je zelo sposoben učenec jezika.
Poleg tega lahko te vektorske predstavitve uporabimo za različne naloge obdelave naravnega jezika, kot so analiza čustev, modeliranje tem in klasifikacija dokumentov. S primerjavo vektorjev besed ali besednih zvez lahko algoritmi določijo podobnost ali sorodnost konceptov, ki jih predstavljajo, kar je bistveno za številne napredne naloge razumevanja in tvorjenja jezika.
(Zaenkrat) Problematičeno kontekstno okno (context window)
Kritični dejavnik za vse modele je kontekstno okno (context window) – količina besedila, ki ga lahko model obravnava naenkrat , ki vpliva na skladnost in globino med interakcijami. Kontekstno okno je pomembno zlasti iz naslednjih razlogov:
-
Skladnost in ustreznost: Večje kontekstno okno omogoča modelu, da ohrani nit pogovora ali dokumenta, kar vodi k bolj skladnim in kontekstualno ustreznim odzivom.
- Ustvarjanje besedila: Pri nalogah, kot je pisanje člankov, zgodb ali kode, večje kontekstno okno modelu omogoča ustvarjanje vsebine, ki je skladna s prejšnjimi deli
- Poglobljenost pogovora: V sistemih za dialog večje kontekstno okno umetni inteligenci omogoča, da si zapomni prejšnje dele pogovora in se nanje sklicuje, kar ustvarja bolj zanimivo in naravno interakcijo.
- Iskanje znanja: Pri nalogah, ki zahtevajo sklicevanje na obsežna besedila ali pridobivanje podatkov iz več delov dokumenta, večje kontekstno okno modelu omogoča učinkovitejše navzkrižno sklicevanje in sintetiziranje informacij.
Vendar obstajajo kompromisi, saj večja kontekstna okna zahtevajo več računske moči in pomnilnika za obdelavo. To lahko vpliva na odzivni čas in stroške. To je ključno področje razlikovanja med modeli LLM, saj lahko izboljšave kontekstnega okna bistveno povečajo uporabnost in prilagodljivost modela pri zapletenih nalogah.
Claude 2 ima kontekstno okno 100 000 tokenov (žetonov), medtem ko ima GPT-4-turbo kontekstno okno 128 000 žetonov. V angleščini je povprečno število besed na 1 000 žetonov približno 750. Raziskovalci v kratkem napovedujejo modele z več kot milijonom žetonov.
Potovanje od prompta do končnega odgovora
- Ko mehanizem LLM konča usposabljanje, je pripravljen, da začne ustvarjati odgovore na pozive (torej prompte), ki mu jih posredujejo uporabniki.
- Ko uporabnik vnese prompt (poziv), se ta vnese v možgane nevronskega omrežja LLM. Ta ima v svoji možganski arhitekturi posebne komponente, ki pomagajo analizirati poziv.
- En del je posebej pozoren na najpomembnejše besede v kontekstu, podobno kot se pri branju osredotočamo na ključne besede.
- Druga komponenta si zapomni vrstni red besed in mesto, kjer se nahajajo v pozivu, kar je pomembno za pravilno razumevanje konteksta.
- Z uporabo možganskih komponent sistem LLM ustvari seznam besed, ki bi lahko logično sledile v odgovoru. Vsaki možni naslednji besedi dodeli oceno verjetnosti.
- Nato z uporabo tehnike, imenovane dekodiranje, izbere najboljše možnosti besed in jih pretvori v končni odgovor.
- Tako lahko izbere najverjetnejšo naslednjo besedo, lahko pa naključno izbere nekaj najverjetnejših kandidatov, da se odgovor ne bi ponavljal in bi zvenel bolj človeško.
- Če povzamem, posebna arhitektura možganov LLM pomaga, da je pozoren na prave besede, si zapomni njihov vrstni red in dodeli verjetnost naslednjim besedam. Nato najboljše možnosti dekodira v odgovor, ki ustrezno ustreza pozivu.
- Ta postopek omogoča, da program LLM na podlagi začetnega GPT vnosa (prompta) uporabnika ustvari človeku zelo podobne odgovore, ki smiselno nadaljujejo pogovor.
- Ena od ključnih prednosti mehanizmov LLM je njihova zmožnost učenja z nekaj posnetki ali brez posnetkov. To pomeni, da lahko posplošijo svoje znanje iz faze pred učenjem in se hitro prilagodijo novim nalogam ali področjem z minimalnimi dodatnimi podatki za učenje. Pri učenju z nekaj udarci je modelu na voljo majhno število primerov, na katerih se uči, pri učenju z ničelnim udarcem pa se model pri oblikovanju odgovora zanaša le na svoje predhodno znanje in dani poziv.
- Pri nalogah razumevanja in ustvarjanja naravnega jezika so modeli LLM pokazali izjemen napredek, njihova uporaba pa zajema različna področja, kot so umetna inteligenca v pogovoru, ustvarjanje vsebin, prevajanje, sistemi za odgovarjanje na vprašanja in drugo. Vendar se je treba zavedati, da mehanizmi vseživljenjskega učenja niso brez omejitev. Včasih lahko pripravijo napačne ali nesmiselne odgovore, so občutljivi na majhne spremembe v vhodnih besednih zvezah ali kažejo pristranskost, ki je prisotna v podatkih za učenje. Zato ima pri zmanjševanju teh omejitev in zagotavljanju, da bodo mehanizmi vseživljenjskega učenja dali želene rezultate za določeno nalogo ali aplikacijo, ključno vlogo inženiring GPT vnosov (promptov).
Priporočeno branje ( v ang. jeziku ) :
Rick H.
https://www.linkedin.com/pulse/prompt-engineering-getting-what-you-want-from-chatgpt-rick-hightower/
Jun 14, 2024 | Amazon
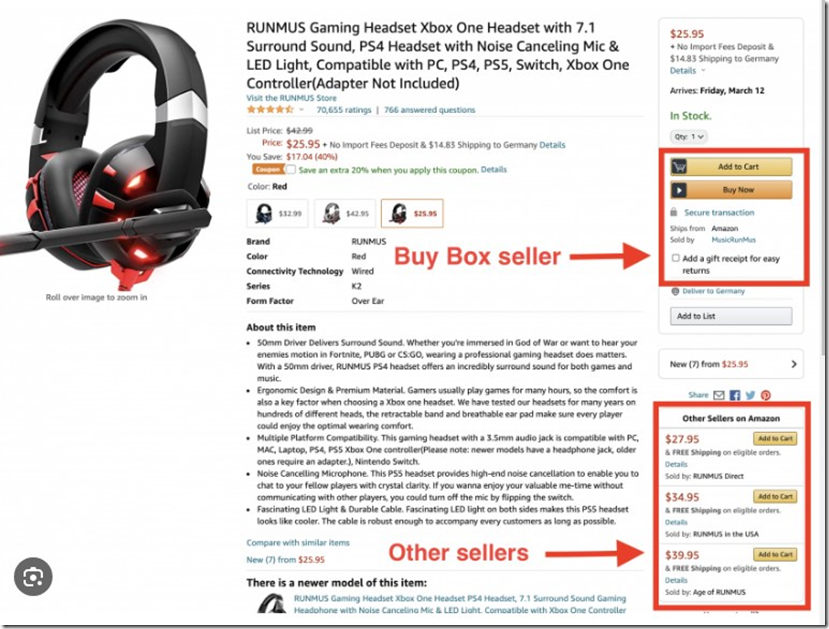
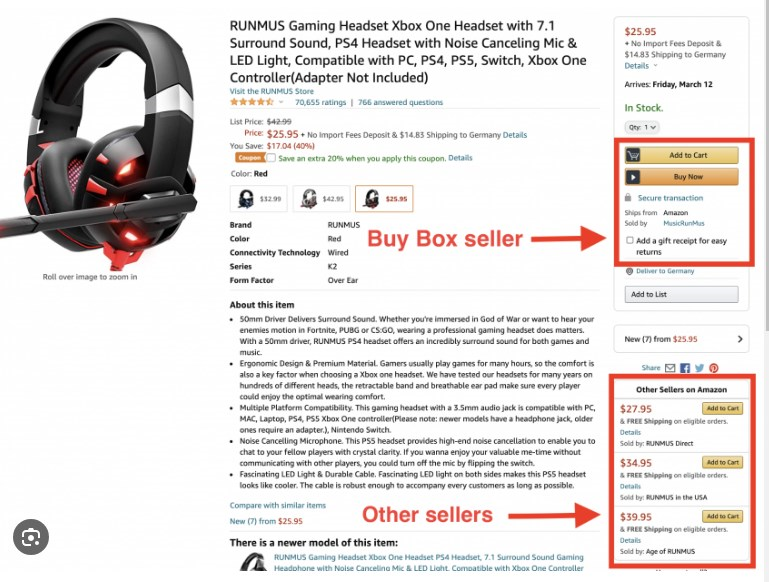
Zmagati v “Buy Box” bitki in posledično dobiti “Buy Box” pomeni, da je Amazonov algoritem vašo ponudbo ocenil kot najboljšo možnost za stranko, kadar več prodajalcev ponuja isti izdelek. Zmaga v rubriki “Buy Box” je Amazonov način, kako povedati, da ste pridobili nakupni klik kupca. Ne glede na to, koliko prodajalcev ponuja isti izdelek, bo na Amazonovi tržnici objavljen le en izdelek. Prodajalec, ki je trenutno zmagovalec Buy Boxa, ima na seznamu prikazano svojo ceno, tako da ko stranka klikne “Dodaj v košarico”, dobi to določeno ceno. Če se odloči, lahko kupi pri drugem prodajalcu – vsi drugi prodajalci (ki trenutno niso zmagovalci Buy Boxa) bodo navedeni v stranski vrstici na desni strani strani izdelka, skupaj z njihovimi cenami in ocenami . Kadar je več prodajalcev istega izdelka, mora imeti Amazon način, kako ugotoviti, komu naj “posreduje” prodajo. Če je na primer 10 prodajalcev izdelka in imajo vsi različne ponudbe (na primer različne cene ali prodajne pogoje), kdo naj dobi prodajo?
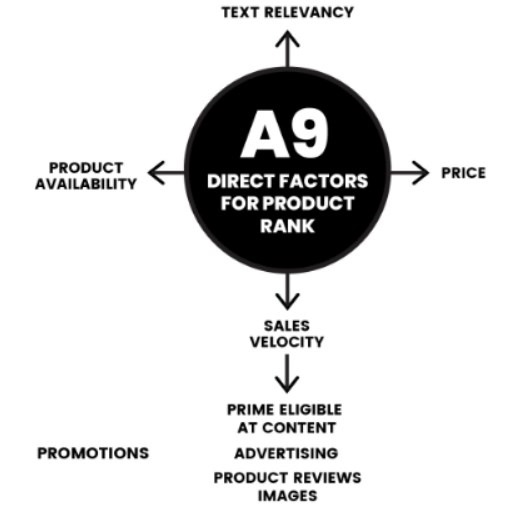
Za rešitev tega problema ima Amazon svoj iskalni algoritem, ki daje prednost ustreznosti, hitrosti prodaje in meritvam konverzije ter primerja, ali je ponudba upravičena do programa Prime (tj. prodajalec FBA, ki izpolnjuje prek programa Prime, ali Amazon sam, ki izpolnjuje prek programa prodajalca). Amazon bo pogosto zmagal pri prodaji, če bo imel ponudbo za izdelek.
A9 Algoritem je zelo pomemben interni Amazonov algoritem 
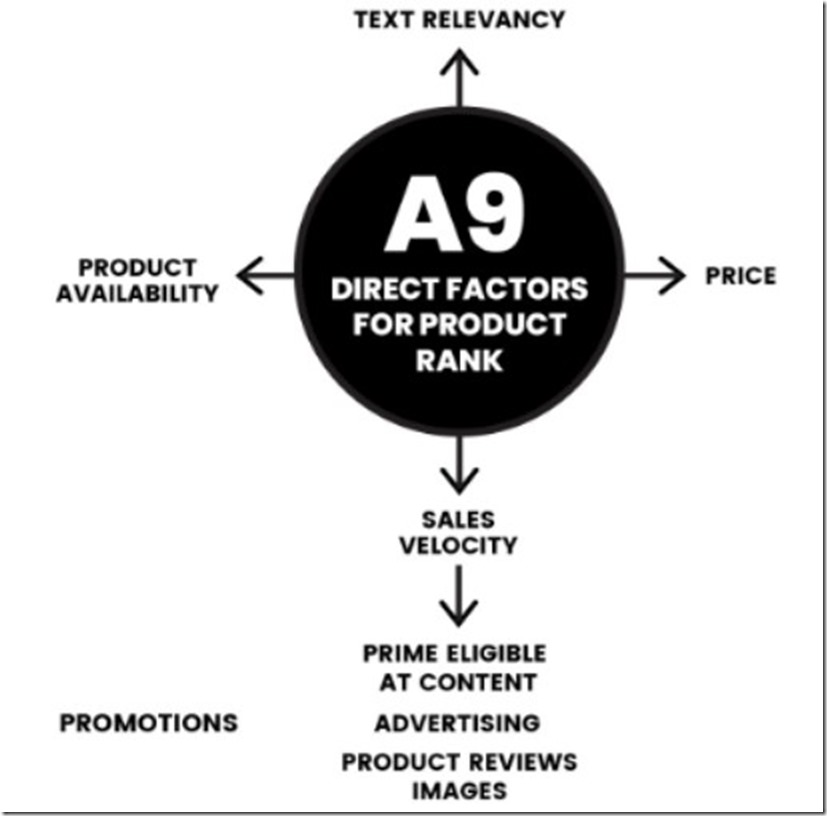
Drugi dejavnik je cena: pogosto bo pri prodaji zmagala ponudba z najnižjo ceno, čeprav ne vedno.
Drugi element, ki prispeva k algoritmu, je ugled prodajalca – čas, v katerem je prodajalec aktiven na Amazonu, v primerjavi s konkurenčnimi prodajalci ter njegove splošne ocene povratnih informacij in stopnje uspešnosti. To so vsi dejavniki, ki po mojem trenutnem razumevanju prispevajo k temu, kdo zmaga v tekmi za “Buy Box”. Če drugi prodajalci prodajajo “vaš” izdelek, je pomembno, da si zagotovite najboljše možnosti za zmago pri vsaki prodaji. To lahko storite tako, da prilagodite svoje cene, pridobite več pozitivnih ocen zadovoljnih kupcev (mnenj strank) ter optimizirate svoje postopke. Čeprav cena ni edini dejavnik, je pomemben. V algoritmu imata pomembno vlogo tudi položaj in ugled prodajalca.
Če je prodajalec A na Amazonu le nekaj tednov, ima le peščico mnenj in ponuja izdelek po ceni 30 USD (medtem ko ga prodajalci B do F prodajajo po ceni 35 USD), prodajalec A verjetno še vedno ne bi dobil nakupnega okna (= Buy Box-a). Če pa je prodajalec A na Amazonu že nekaj let in ima veliko pregledov, bi ga najverjetneje osvojil. Prodajalci z velikimi katalogi izdelkov ne želijo sedeti na Amazonu in ves dan prilagajati cen, da bi povečali svoje možnosti za zmago v Buy Boxu. Na srečo je na voljo programska oprema za popravljanje cen, ki na podlagi pravil, ki jih določite sami, samodejno prilagodi cene vaših izdelkov. Lahko na primer določite, da mora cena vedno ostati nad določenim zneskom v dolarjih in da ne želite, da se popravljanje cen izvaja pogosteje kot petkrat na dan. S tem bi zagotovili, da so vaše cene optimizirane za konkurenčnost, ne da bi se znašle v “dirki do dna”.
Kako izboljšati oceno prodajalca in povečati pogostost nakupnega okna
Govorili smo že o tem, kako zelo pomembne so pozitivne ocene za povečanje prodaje na Amazonu, vendar k temu močno prispevajo tudi povratne informacije prodajalcev. To naj bi bile povratne informacije strank o njihovih neposrednih izkušnjah s prodajalcem. Če uporabljate storitev FBA, v resnici z vidika izpolnjevanja naročil ne boste imeli veliko interakcije s strankami.
Nimate številk za sledenje, nimate nadzora nad časovnim okvirom dostave in ne morete storiti veliko, da bi vplivali na izkušnjo stranke, vendar še vedno obstaja ta metrika povratnih informacij strank, s katero se lahko merite. Stranke lahko po prodaji pišejo mnenja in ocenjujejo prodajalce, tako kot lahko to počnejo pri ocenah izdelkov. Razlika je v tem, da se povratne informacije o prodajalcu prikažejo šele, ko stranka klikne na vaš profil prodajalca, zato morate ustvariti ravnovesje med pridobivanjem mnenj o izdelkih (ki pomagajo pri konverziji izdelkov) in povratnimi informacijami o prodajalcu (ki pomagajo pri pridobivanju nakupnega okna). Priporočamo, da določenemu odstotku strank sledite in jih prosite, naj pustijo mnenje prodajalca, da boste dopolnili svoje metrike.