May 21, 2025 | PPC
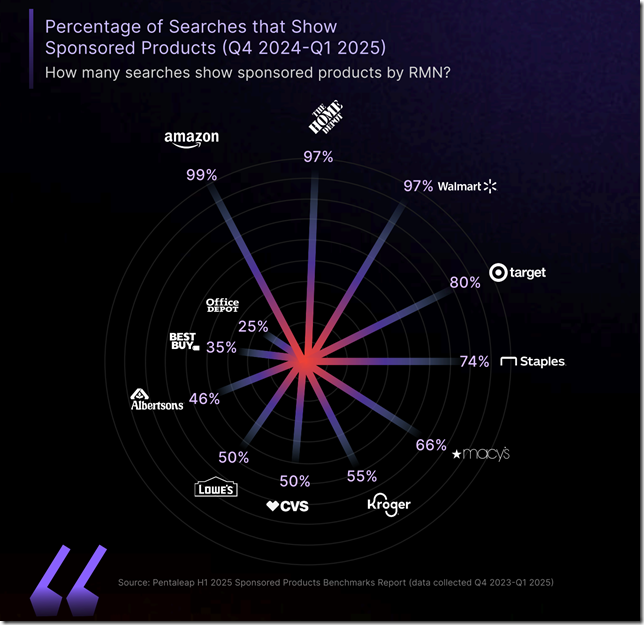
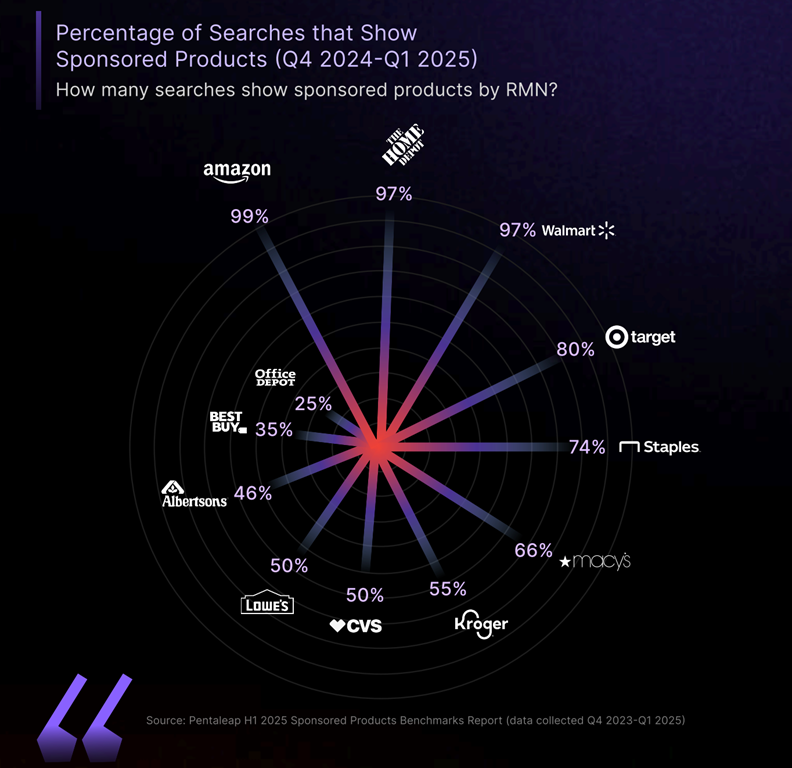
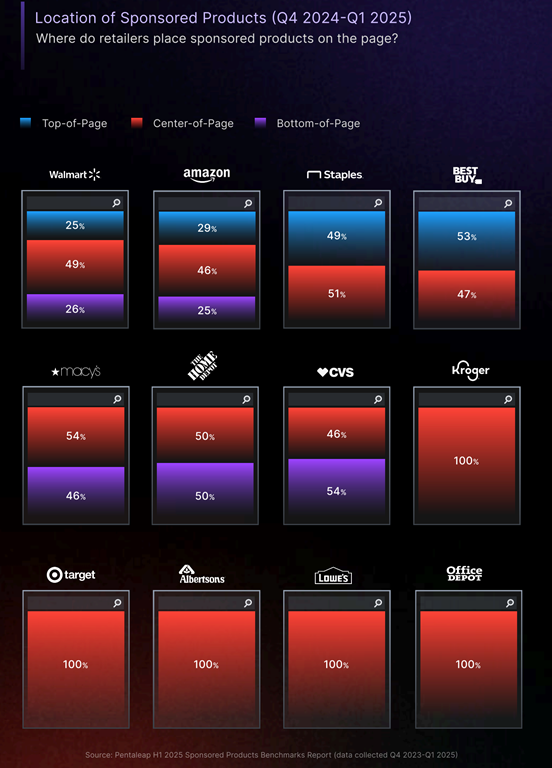
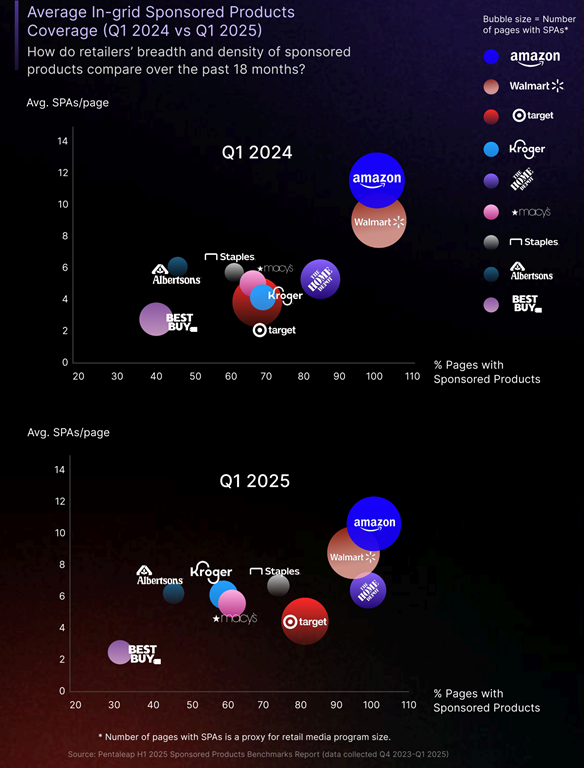
Nova raziskava podjetja Pentaleap, ponudnika maloprodajnih medijskih tehnologij, ugotavlja, da trgovci, kot so Amazon, Walmart in Home Depot, ponujajo sponzorirane izdelke pri skoraj vsakem rezultatu iskanja – 97-99 % poizvedb – pri čemer ohranjajo vključenost kupcev (CTR in CVR) na organski ravni.
Kaj preprečuje, da bi visoka pokritost z oglasi poslabšala uporabniško izkušnjo? Odgovor je ustreznost. Najuspešnejša maloprodajna medijska omrežja zagotavljajo, da njihovi sponzorirani izdelki ohranjajo stopnjo klikov, ki je primerljiva z organskimi objavami.
Podjetja Amazon, Walmart in Home Depot so obvladala umetnost vstavljanja sponzoriranih izdelkov v skoraj vsako poizvedbo, ki jo obravnavajo – Amazon v 99 % iskanj, Walmart in Home Depot pa v 97 % iskanj.Ta vsesplošna razširjenost ne pomeni le večjega števila prikazov, temveč tudi to, da so te platforme razvile izpopolnjene algoritme ustreznosti, ki kljub veliki gostoti oglasov ohranjajo kupce vpletene.
„Pomembnost vaših sponzoriranih izdelkov mora biti skladna z relevantnostjo vaših organskih izdelkov,“ pravijo. „Stopnja klikov je približek ali ključni kazalnik uspešnosti za pomembnost. Če je CTR na sponzorirane izdelke nižji od organskega CTR in je razlika precejšnja, je to zelo nevarna igra.“
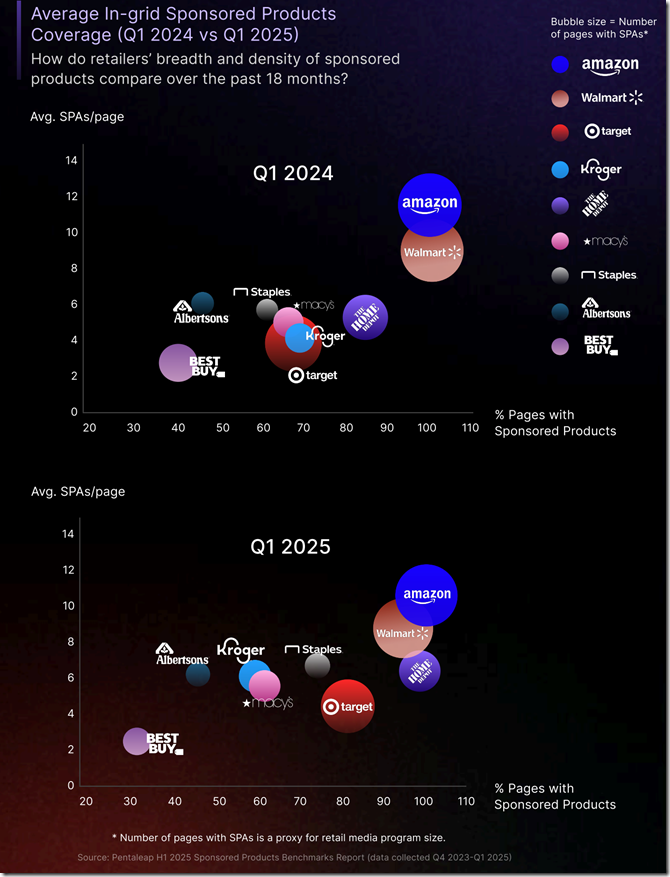
Podatki razkrivajo, zakaj lahko trgovci na drobno, kot je Amazon, prikažejo več oglasov, ne da bi žrtvovali uporabniško izkušnjo – razvili so prefinjene tehnologije za ujemanje oglasov, ki ohranjajo relevantnost tudi pri visokih stopnjah pokritosti.
Ta pristop odraža tisto, kar je Google dosegel na področju iskalnega oglaševanja do pandemije. S povečevanjem razpoložljivega oglasnega prostora na straneh z rezultati iskanja iz leta v leto je Google ustvaril velikodušno ponudbo oglaševalskih priložnosti. Ta presežna zaloga je pomagala umiriti inflacijo cen, medtem ko je sama količina razpoložljivih klikov spodbujala splošno rast prihodkov.
Reiffen potrjuje, da je enak vzorec viden tudi v Amazonovem pristopu. Čeprav so se Amazonove cene CPC sčasoma res povečale, so se povečale veliko manj drastično, kot bi se, če bi podjetje vzdrževalo omejen inventar. Z razširitvijo razpoložljivih oglaševalskih mest na več rezultatov iskanja in položajev v mreži je Amazon ublažil inflacijo cen, hkrati pa pridobil večjo skupno porabo za oglaševanje.
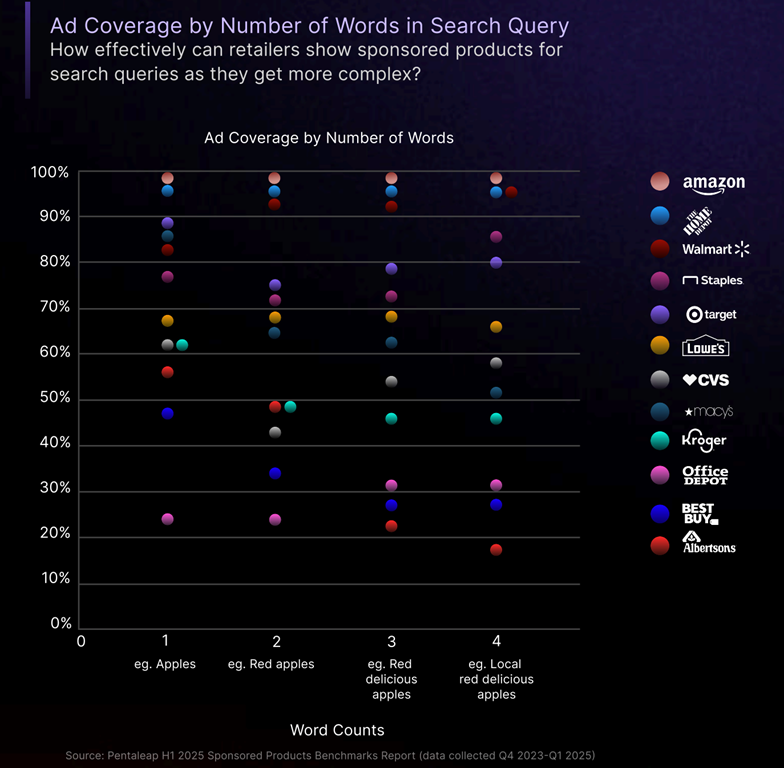
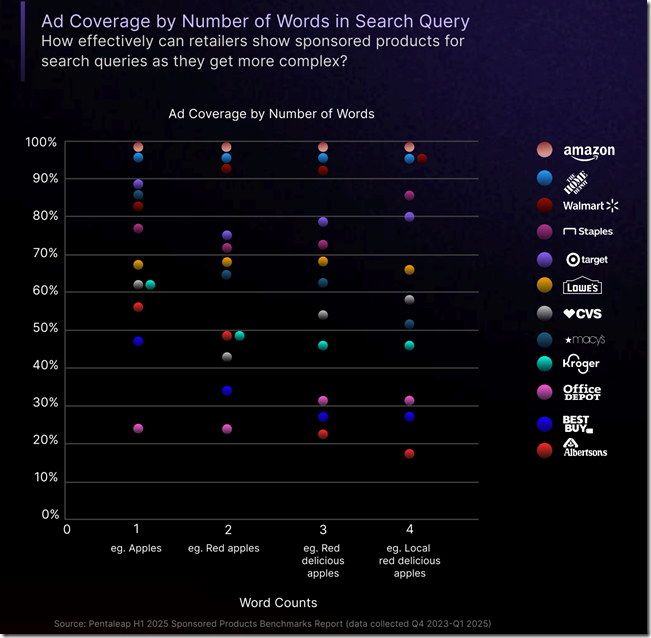
Poročilo razkriva tudi, kako tehnične zmožnosti vplivajo na povečanje pokritosti sponzoriranega izdelka, zlasti pri zapletenih iskalnih poizvedbah.Medtem ko Amazon, Walmart in Home Depot ohranjajo visoko pokritost sponzoriranih izdelkov tudi pri poizvedbah s petimi, šestimi in sedmimi besedami, se pri drugih, kot je Office Depot, pokritost pri kompleksnih poizvedbah zmanjšuje, kar kaže na slabšo tehnologijo ciljanja.
Te razlike v uspešnosti lahko pojasnimo z dvema glavni metodologiji ciljanja: licitiranje na podlagi ključnih besed, kjer oglaševalec izbere določeno ključno besedo, za katero bo licitiral, in licitiranje na podlagi izdelkov, kjer trgovec na drobno določi, za katero mesto in ključno besedo bo porabil ponudbo glede na cilje kampanje.
Bolj razvita maloprodajna medijska omrežja, kot je Amazon, ponujajo tako ponujanje po ključnih besedah kot po izdelkih. To jim omogoča, da ohranjajo visoko pokritost sponzoriranih izdelkov tako pri enostavnih kot pri zapletenih iskanjih, medtem ko se pri platformah z manj izpopolnjenimi možnostmi ciljanja pokritost z večanjem kompleksnosti iskanja zmanjšuje.
Ta tehnična razlika ustvarja velike razlike v učinkovitosti: če dolga iskanja ne sprožijo sponzoriranih izdelkov, to pomeni, da je tehnična plat zelo pomanjkljiva, kar ni dobro
Za oglaševalca nezmožnost licitiranja za long-tail ključne besede , ki običajno kažejo na večjo nakupno namero kupca, pomeni, da so lahko njegovi stroški oglaševanja višji.
Podjetje Pentaleap neprekinjeno preiskuje glavna ameriška maloprodajna medijska spletna mesta (Amazon, Walmart, Home Depot, Target itd.) z uporabo več deset tisoč resničnih iskalnih izrazov kupcev, ki se osvežujejo vsako četrtletje. Pri vsakem iskanju določi oznake sponzoriranih izdelkov in podatke združi za štiri tekoča četrtletja (trenutna izdaja zajema obdobje od drugega četrtletja 2024 do prvega četrtletja 2025).
Ta metodologija je pomembna iz treh ključnih razlogov. Prvič, zagotavlja resnično neodvisnost, saj se ne zanaša na nadzorne plošče trgovcev, ki jih sami poročajo; vse je preverjeno prek sprednje realnosti. Drugič, omogoča nam granularnost s pogledi na ravni rež in števila besed, ki razkrivajo nianse, ki bi jih lahko trgovec na drobno prikril (na primer, platforma se lahko pohvali s 70-odstotno splošno pokritostjo, vendar pri poizvedbah s petimi besedami ne prikazuje nobenih oglasov). Nazadnje zagotavlja doslednost z enakim pregledovalnikom, kadenco in taksonomijo pri vseh prodajalcih, kar blagovnim znamkam omogoča dejanske primerjave med seboj.
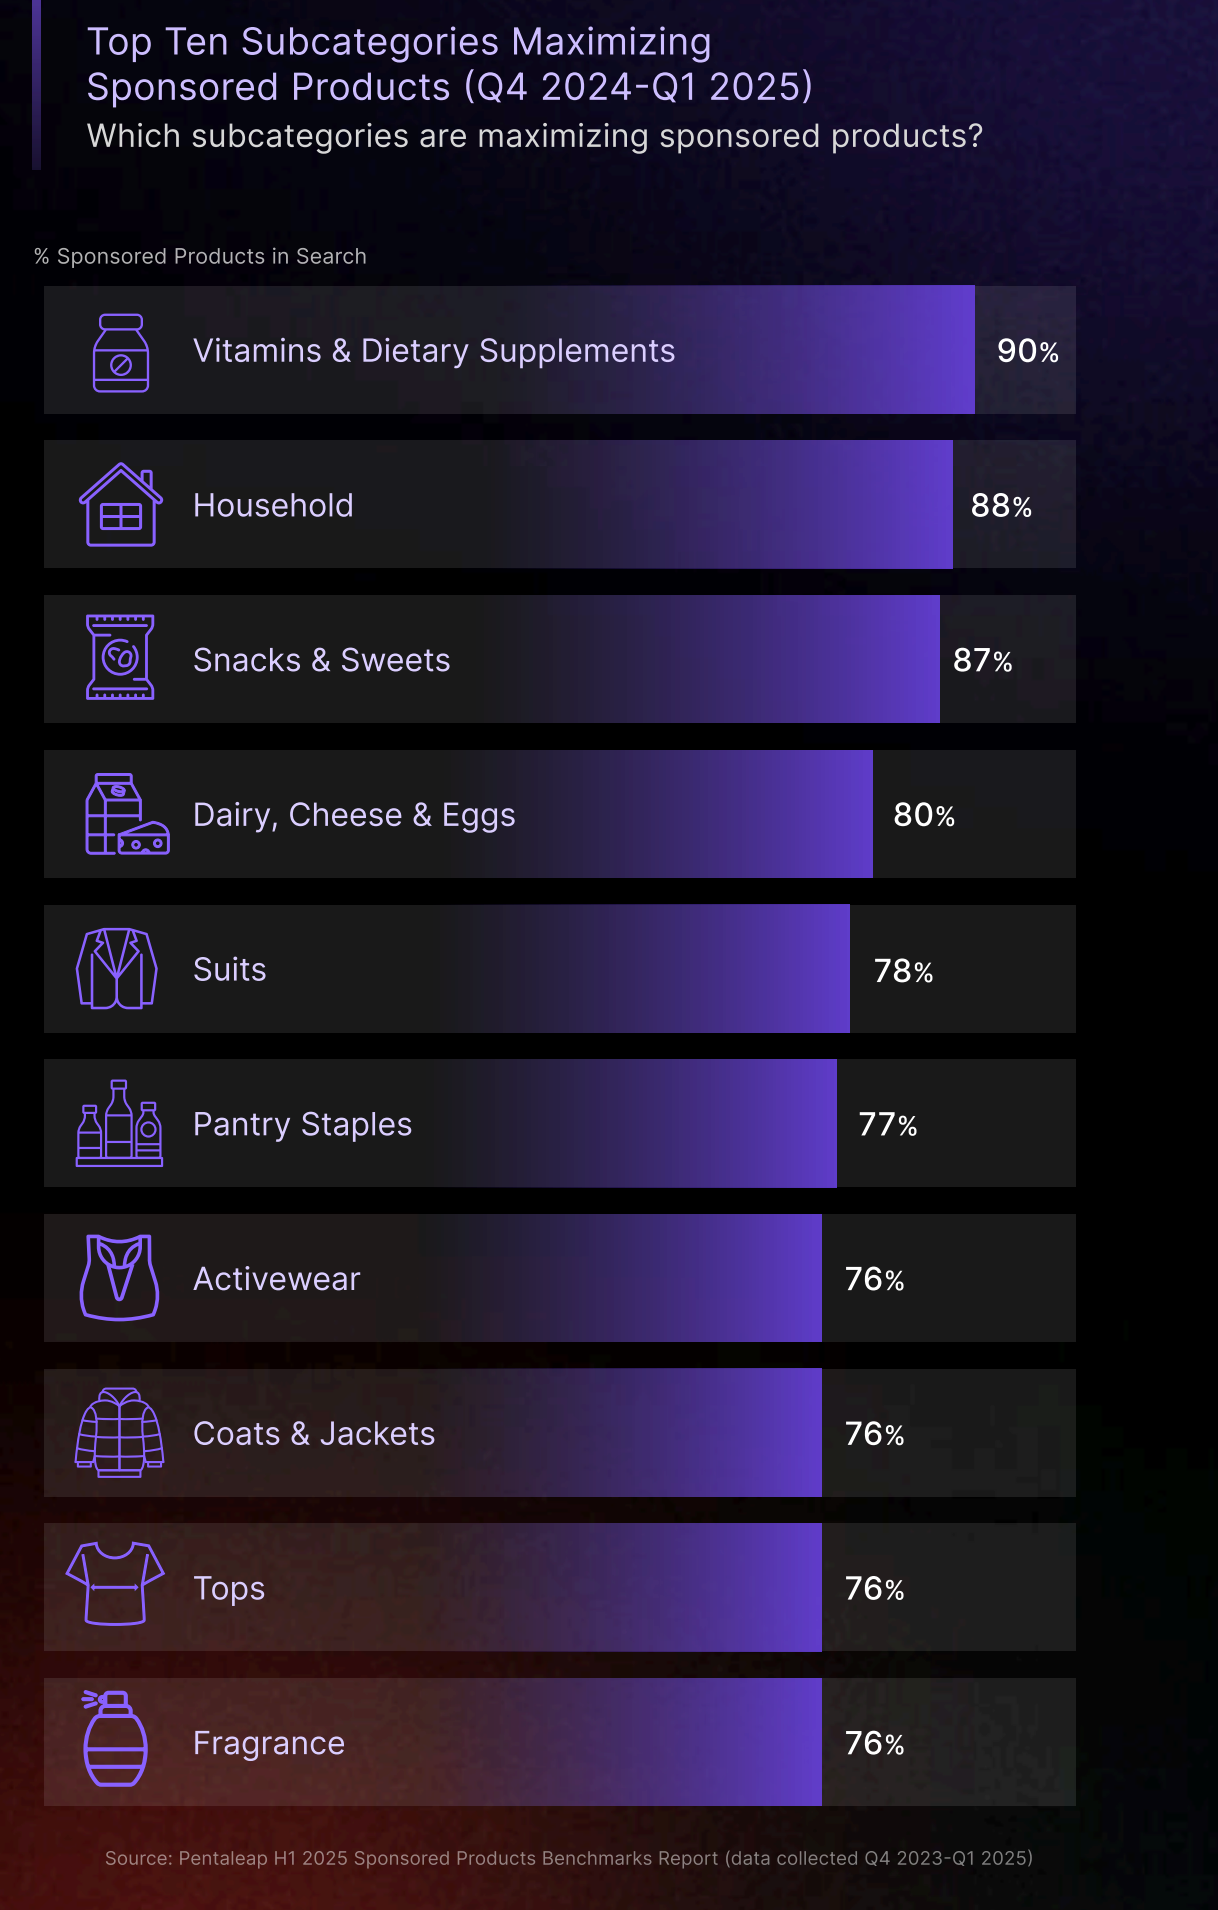
Kako se ti trendi prenašajo na kategorijo izdelkov vaše blagovne znamke?Ta del primerjalne analize kaže, da je zasičenost z oglasi večja pri vsakodnevnih osnovnih izdelkih: Vitamini in dodatki (90 % iskanj vsebuje oglas), gospodinjski izdelki (88 %), mlečni izdelki (80 %) in prigrizki (87 %). Blagovne znamke v teh kategorijah se soočajo z večjo konkurenco.
Nasprotno pa obstajajo priložnosti v kategorijah, ki so premalo izkoriščene.Tudi v Amazonovem svetu, ki je pokrit 99 %, so nekatere podkategorije še vedno malo konkurenčne:Veliki gospodinjski aparati (61 % iskanj še vedno ne prikaže oglasa), sveža zelenjava (58 %) in nega nohtov (54 %).Za manjše blagovne znamke ali izzivalce ti segmenti ponujajo poceni klike in velik delež glasu, če so vaše kreativne in pristajalne strani pripravljene na konverzijo.
Za blagovne znamke, ki bodo v letu 2025 vlagale v maloprodajne medije, Pentaleapovo poročilo predlaga tri ključne ukrepe: dajte prednost platformam z močno pokritostjo long-taila, razumite posledice različnih ponudbenih modelov na strukturo vaše kampanje in poglejte dlje od povprečja kategorije ter prepoznajte priložnosti, kjer je konkurenca še vedno obvladljiva.
May 12, 2025 | LLM (AI), Pozivi (prompti)
ChatGPT & Grok sta dobila dostop do praktično “neomejenega pomnilnika”.
☑ Zapomnita si vaše pretekle pogovore.
☑ Oba lahko naučite, kdo ste in kaj želite.
Kako dodate trajne podatke v “svoj” spomin:
1 – Pojdite na ChatGPT ali Grok. Ne deluje na Gemini & Claude (v času pisanja).
2 – Poziv začnite z “Update your memory with the following:”.
3 – Najbolje je, da razložite, za katero situacijo bi želeli, da se zgodi ta “slog”.
Update your memory with the following:
Whenever I write an email with you, I never use the – em dash, ever.
Be straightforward. Don’t be too polite. Always add an actionable next step.
To je to. LLM bo v bodoče “vedel” vaše specifična želje in/ali okoliščine.
May 8, 2025 | Amazon, LLM (AI)

Amazonov “hišni” AI model Nova je zdaj nadgrajen, da lahko konkurira sodobnim modelom, kot sta Claude 3 in Llama 4. Za trgovce na drobno in oglaševalce to pomeni, da lahko Amazonov AI izvaja tudi kompleksnejša in zahtevnejša opravila – od podrobnih opisov izdelkov do prilagojenih priporočil – ne da bi se pri tem zanašal na zunanje ponudnike umetne inteligence.
Nova zdaj tekmuje z modeli na ravni GPT-4 in Claude 3 po globini sklepanja (reasoning) in kontekstnem oknu (token), ne le po ceni. Z njim Amazon lahko ohrani napredek v lastni hiši, hkrati pa še vedno omogoča izvajanje zahtevnejših naloge, kot so večjezični povzetki izdelkov, oblikovanje paketov in “agencijski” pogovori pri nakupovanju – vse to brez najemanja OpenAI ali Anthropic AI modelov.
NovaSonic Voice Shopping

Novi model NovaSonic odpravlja ključne ovire, zaradi katerih se glasovno nakupovanje prej ni moglo uveljaviti:
- Nižja stopnja napak pri besedah (kupce razume že prvič)
- Bolj naravno zveneči odgovori
- Možnost shranjevanja/ohranjanja konteksta pogovora
Prejšnje glasovno nakupovanje je bilo neuspešno predvsem zaradi napak pri prepisovanju, robotsko zvenečih odzivov in pomanjkanja kontekstnega spomina. Sistem NovaSonic se teh težav loteva drugače: zahteve razume že prvič in se odziva s človeku podobnimi govornimi vzorci, hkrati pa ohranja kontekst med več sejami/pogovori. To je ključnega pomena, da potrošniki umetni inteligenci v končni fazi res zaupajo nakupne odločitve – zlasti v okoljih brez zaslonov, kot so kuhinje ali avtomobili.
Medtem ko številna podjetja razvijajo tekstualne klepetalne robote, Amazonova naložba v podjetje NovaSonic kaže na izrazit poudarek na glasovnem delu, pri čemer izkorišča svoj obstoječi sistem Alexe v milijonih domov, česar konkurenca ne more doseči.
Glasovno iskanje bo verjetno postalo glavna vstopna točka za nakupovanje. Pričakujte iskanja izdelkov, kot so: “Alexa, pokaži mi maskaro brez xy, ki je cenejša od 25 dolarjev in jo lahko pošljemo do petka.” Agent poskrbi za filtriranje, preverjanje zalog in obdelavo plačil. Za oglaševalce bodo morale biti sponzorirane objave naravno umeščene v pogovorne odgovore, namesto da bi se pojavljale v tradicionalnih mrežah rezultatov iskanja.
Govor bomo videli v Alexi+, morda pa tudi v drugih Amazonovih aplikacijah – da bi se vsi navadili na glasovne interakcije, bi lahko Amazon uvedel glasovne vmesnike v iskalno vrstico Amazonovih mobilnih aplikacij (tako kot smo se zdaj začeli pogovarjati s ChatGPT) in glasovni daljinec Fire TV.
Agenti in aplikacije

Alexa Plus: naročniški nakupovalni pomočnik
Amazonova pomočnica naslednje generacije ne le odgovarja na vprašanja, temveč lahko tudi ukrepa – tako je potencialni nakupovalni pomočnik, ki bi lahko:
- primerja izdelke in daje priporočila
- dodajati izdelke v košarico
- uporabiti kupone
- poskrbeti za vračilo
Trenutno se uvaja v ZDA, še letos pa je načrtovana globalna širitev.
Naročniški agenti bi lahko prekinili odkrivanje izdelkov za ponovne nakupe. Alexa Plus že upravlja naprave pametnega doma in omogoča rezervacije; naslednji logični korak je avtomatizacija rutinskih nakupov z navodili, kot je “poskrbite, da bo moje gospodinjstvo preskrbljeno z najcenejšimi žitaricami brez glutena, zamenjajte blagovno znamko, če se cena na enoto poveča za 10 %“. S tem se zruši odkrivanje v zgornjem tunelu in ustvari novo bojišče, kjer blagovne znamke tekmujejo, da bi postale privzeto priporočilo agenta – nova vrsta “nevidne police”.
NovaACT: agent brskalnika (predogled raziskav)
Ta agent za delovanje brskalnika, ki je še vedno v fazi raziskav, naj bi bistveno izboljšal natančnost večstopenjskih nalog z današnjih 30-60 % na več kot 90 %. Za e-trgovino bi to sčasoma lahko omogočilo agente, ki bi delovali avtonomno:
- krmarijo po blagajni
- uporabljajo točke zvestobe
- iskanje najboljših ponudb pri več trgovcih na drobno
- prikazovanje sponzoriranih ponudb med potovanjem
Ko bo program NovaACT dozorel, bo lahko Amazonov AI agent primerjal nakupovanje na spletnih straneh Nike.com, Walmart.com in Amazon, nato pa samodejno izvedel najboljšo ponudbo. Amazon lahko to možnost vgradi v gumbe “Buy button” s storitvijo Prime ali razširitve brskalnikov, s čimer bi lahko pridobil ekonomijo v stilu partnerskih podjetij tudi za nakupe zunaj spletnega mesta. To bi od oglaševalcev in trgovcev na drobno zahtevalo, da ponovno razmislijo o tem, kako hkrati predstaviti ponudbe človeškim kupcem in agentom umetne inteligence.
Zmanjšanje stroškov: 30-40 % cenejša umetna inteligenca
Amazon je poudaril znatno znižanje stroškov zaradi čipov Trainium 2. Za trgovce na drobno in oglaševalce so tako funkcije umetne inteligence bolj ekonomsko upravičene na več načinov:
- Personalizacija v velikem obsegu: Nižji stroški omogočajo trgovcem na drobno, da brez prevelikih stroškov ustvarijo edinstvene opise izdelkov, priporočila in vizualne podobe za posamezne stranke.
- Optimizacija kreativnosti v realnem času: Oglaševalci si lahko privoščijo ustvarjanje in preizkušanje več različic kreativ na prikaz, pri čemer lahko sporočila prilagodijo na podlagi zgodovine nakupovanja posameznika.
- Vgrajena umetna inteligenca povsod: Ker se stroški znižujejo, je mogoče funkcije umetne inteligence vključiti v izdelke z nižjimi maržami in vsakodnevne nakupovalne izkušnje, za katere prej ni bilo mogoče upravičiti stroškov.
Za razliko od konkurentov Amazon gradi na celotnem nizu umetne inteligence, kar mu daje potencialno stroškovno in integracijsko prednost pred podjetji, ki se osredotočajo le na en nivo AI.

Kako to spreminja trgovino
Amazonove objave o umetni inteligenci v prvem četrtletju 2025 razkrivajo celovito strategijo, ki zajema vse od silicija do nakupovalne izkušnje. Amazon z oblikovanjem AI modelov, glasovnih vmesnikov in v delovanje usmerjenih agentov ne izboljšuje le svojega trenutnega poslovanja, temveč spreminja način, kako bodo ljudje v prihodnosti odkrivali, ocenjevali in kupovali izdelke.
Za trgovce na drobno in oglaševalce je sporočilo jasno: pripravite se na svet, v katerem bodo pogovorni vmesniki nadomestili tradicionalna iskalna polja, v katerem bodo nakupovalni agenti samodejno opravljali rutinske nakupe in v katerem bo dinamična, personalizirana vsebina postala norma. Tisti, ki bodo svoje strategije prilagodili tej trgovinski pokrajini, ki jo poganja umetna inteligenca, bodo uspeli; tisti, ki tega ne bodo storili, bodo morda postali vse bolj nevidni za jutrišnje kupce.
Apr 30, 2025 | LLM (AI)
Alibaba je pravkar predstavil družino modelov umetne inteligence Qwen3.
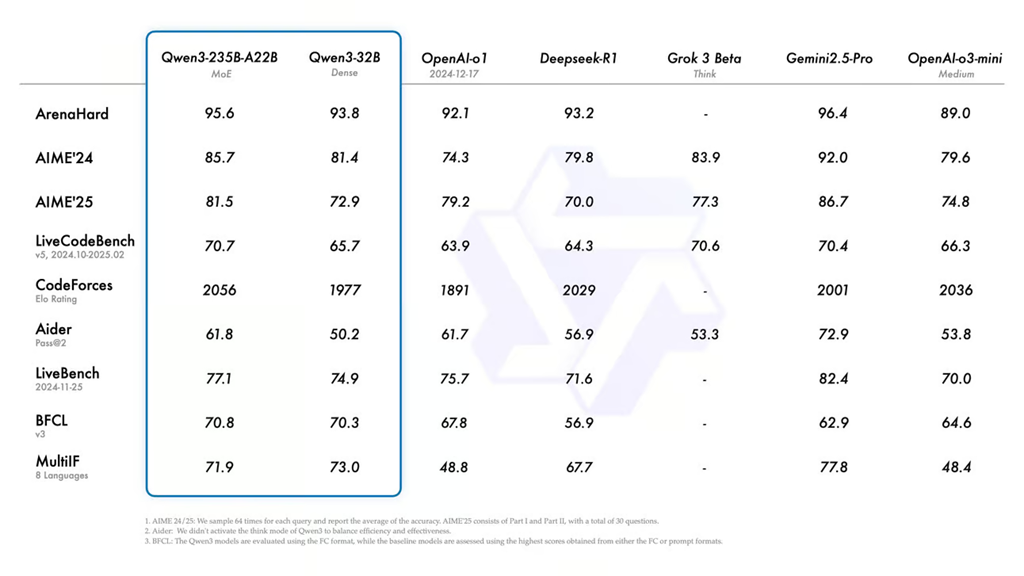
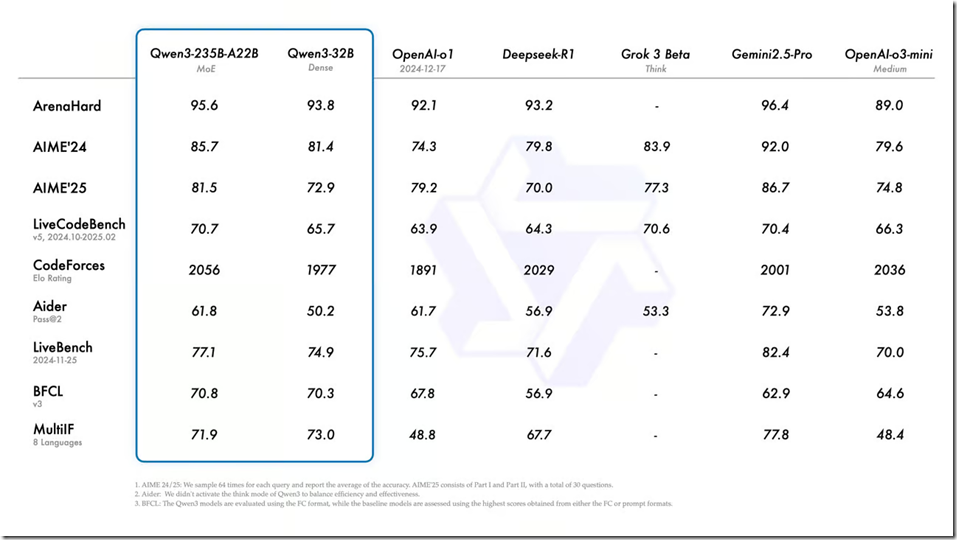
Po prvih primerjalnih testih so nekatere različice že presegle OpenAI in Google pri kritičnih testih.
- modeli Qwen3 imajo od 0,6B do 235B parametrov in podpirajo 119 jezikov.
- so “hibridni” modeli, ki lahko po potrebi poglobljeno razmišljajo ali se hitro odzovejo pri preprostejših nalogah
- Nekateri uporabljajo arhitekturo Mixture of Experts (MoE) za hitrejše in učinkovitejše reševanje problemov
- Vodilni model, Qwen-3-235B-A22B, je v primerjalnih testih kodiranja in matematike premagal o3-mini podjetja OpenAI in Googlov Gemini 2.5 Pro
- Čeprav največji model še ni javen, je Qwen3-32B odprt in že tekmuje z vodilnimi modeli, kot je DeepSeek R1
- Modeli Qwen3 so usposobljeni na 36 bilijonih žetonov, vključno z učbeniki, pari za preverjanje kakovosti, kodo in vsebinami, ki jih ustvarja umetna inteligenca
- Na voljo za prenos na straneh Hugging Face, GitHub in prek ponudnikov storitev v oblaku, kot sta Fireworks AI in Hyperbolic
Feb 20, 2025 | LLM (AI)
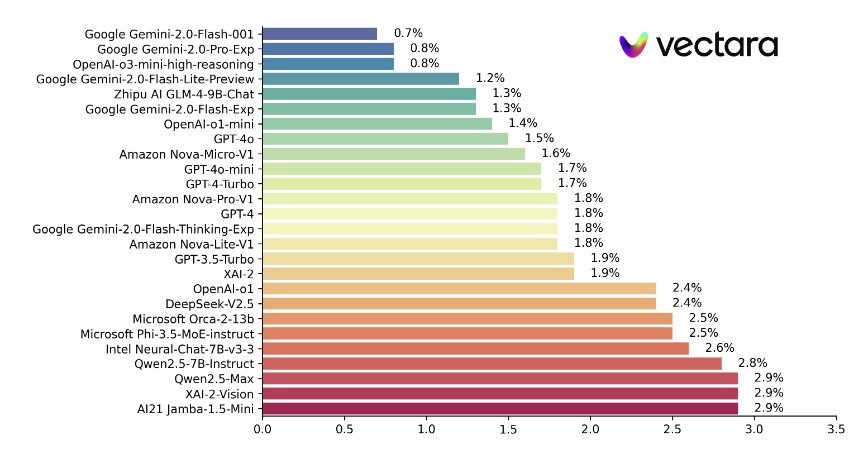
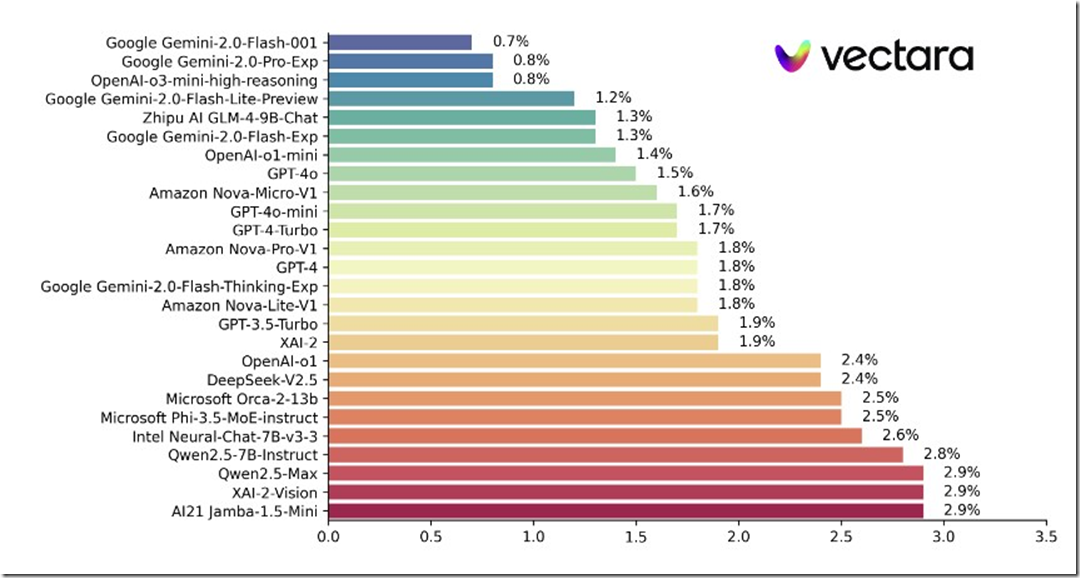
Lestvica LLM, izračunana z uporabo Vectarinega modela za vrednotenje Hughesovih halucinacij. Ta ocenjuje, kako pogosto program LLM pri povzemanju dokumenta uvaja halucinacije.
| Model |
Hallucination Rate |
Factual Consistency Rate |
Answer Rate |
Average Summary Length (Words) |
Google
Gemini-2.0-Flash-001 |
0.7 % |
99.3 % |
100.0 % |
65.2 |
Google
Gemini-2.0-Pro-Exp |
0.8 % |
99.2 % |
99.7 % |
61.5 |
| OpenAI-o3-mini-high-reasoning |
0.8 % |
99.2 % |
100.0 % |
79.5 |
Google
Gemini-2.0-Flash-Lite-Preview |
1.2 % |
98.8 % |
99.5 % |
60.9 |
Zhipu
AI GLM-4-9B-Chat |
1.3 % |
98.7 % |
100.0 % |
58.1 |
Google
Gemini-2.0-Flash-Exp |
1.3 % |
98.7 % |
99.9 % |
60.0 |
| OpenAI-o1-mini |
1.4 % |
98.6 % |
100.0 % |
78.3 |
| GPT-4o |
1.5 % |
98.5 % |
100.0 % |
77.8 |
Amazon
Nova-Micro-V1 |
1.6 % |
98.4 % |
100.0 % |
90.0 |
| GPT-4o-mini |
1.7 % |
98.3 % |
100.0 % |
76.3 |
| GPT-4-Turbo |
1.7 % |
98.3 % |
100.0 % |
86.2 |
Google
Gemini-2.0-Flash-Thinking-Exp |
1.8 % |
98.2 % |
99.3 % |
73.2 |
Amazon
Nova-Lite-V1 |
1.8 % |
98.2 % |
99.9 % |
80.7 |
| GPT-4 |
1.8 % |
98.2 % |
100.0 % |
81.1 |
Amazon
Nova-Pro-V1 |
1.8 % |
98.2 % |
100.0 % |
85.5 |
| GPT-3.5-Turbo |
1.9 % |
98.1 % |
99.6 % |
84.1 |
| XAI-2 |
1.9 % |
98.1 |
100.0 % |
86.5 |
| OpenAI-o1 |
2.4 % |
97.6 % |
99.9 % |
73.0 |
| DeepSeek-V2.5 |
2.4 % |
97.6 % |
100.0 % |
83.2 |
Microsoft
Orca-2-13b |
2.5 % |
97.5 % |
100.0 % |
66.2 |
Microsoft
Phi-3.5-MoE-instruct |
2.5 % |
97.5 % |
96.3 % |
69.7 |
Intel
Neural-Chat-7B-v3-3 |
2.6 % |
97.4 % |
100.0 % |
60.7 |
| Qwen2.5-7B-Instruct |
2.8 % |
97.2 % |
100.0 % |
71.0 |
AI21
Jamba-1.5-Mini |
2.9 % |
97.1 % |
95.6 % |
74.5 |
| XAI-2-Vision |
2.9 % |
97.1 |
100.0 % |
79.8 |
| Qwen2.5-Max |
2.9 % |
97.1 % |
88.8 % |
90.4 |
| Snowflake-Arctic-Instruct |
3.0 % |
97.0 % |
100.0 % |
68.7 |
| Qwen2.5-32B-Instruct |
3.0 % |
97.0 % |
100.0 % |
67.9 |
Microsoft
Phi-3-mini-128k-instruct |
3.1 % |
96.9 % |
100.0 % |
60.1 |
Mistral
Small3 |
3.1 % |
96.9 % |
100.0 % |
74.9 |
| OpenAI-o1-preview |
3.3 % |
96.7 % |
100.0 % |
119.3 |
Google
Gemini-1.5-Flash-002 |
3.4 % |
96.6 % |
99.9 % |
59.4 |
01-AI
Yi-1.5-34B-Chat |
3.7 % |
96.3 % |
100.0 % |
83.7 |
| Llama-3.1-405B-Instruct |
3.9 % |
96.1 % |
99.6 % |
85.7 |
| DeepSeek-V3 |
3.9 % |
96.1 % |
100.0 % |
88.2 |
Microsoft
Phi-3-mini-4k-instruct |
4.0 % |
96.0 % |
100.0 % |
86.8 |
| Llama-3.3-70B-Instruct |
4.0 % |
96.0 % |
100.0 % |
85.3 |
Microsoft
Phi-3.5-mini-instruct |
4.1 % |
95.9 % |
100.0 % |
75.0 |
| Mistral-Large2 |
4.1 % |
95.9 % |
100.0 % |
77.4 |
| Llama-3-70B-Chat-hf |
4.1 % |
95.9 % |
99.2 % |
68.5 |
| Qwen2-VL-7B-Instruct |
4.2 % |
95.8 % |
100.0 % |
73.9 |
| Qwen2.5-14B-Instruct |
4.2 % |
95.8 % |
100.0 % |
74.8 |
| Qwen2.5-72B-Instruct |
4.3 % |
95.7 % |
100.0 % |
80.0 |
| Llama-3.2-90B-Vision-Instruct |
4.3 % |
95.7 % |
100.0 % |
79.8 |
XAI
Grok |
4.6 % |
95.4 % |
100.0 % |
91.0 |
Anthropic
Claude-3-5-sonnet |
4.6 % |
95.4 % |
100.0 % |
95.9 |
| Qwen2-72B-Instruct |
4.7 % |
95.3 % |
100.0 % |
100.1 |
Microsoft
Phi-4 |
4.7 % |
95.3 % |
100.0 % |
100.3 |
| Mixtral-8x22B-Instruct-v0.1 |
4.7 % |
95.3 % |
99.9 % |
92.0 |
Anthropic
Claude-3-5-haiku |
4.9 % |
95.1 % |
100.0 % |
92.9 |
01-AI
Yi-1.5-9B-Chat |
4.9 % |
95.1 % |
100.0 % |
85.7 |
Cohere
Command-R |
4.9 % |
95.1 % |
100.0 % |
68.7 |
| Llama-3.1-70B-Instruct |
5.0 % |
95.0 % |
100.0 % |
79.6 |
| Llama-3.1-8B-Instruct |
5.4 % |
94.6 % |
100.0 % |
71.0 |
Cohere
Command-R-Plus |
5.4 % |
94.6 % |
100.0 % |
68.4 |
| Llama-3.2-11B-Vision-Instruct |
5.5 % |
94.5 % |
100.0 % |
67.3 |
| Llama-2-70B-Chat-hf |
5.9 % |
94.1 % |
99.9 % |
84.9 |
IBM
Granite-3.0-8B-Instruct |
6.5 % |
93.5 % |
100.0 % |
74.2 |
Google
Gemini-1.5-Pro-002 |
6.6 % |
93.7 % |
99.9 % |
62.0 |
Google
Gemini-1.5-Flash |
6.6 % |
93.4 % |
99.9 % |
63.3 |
| Mistral-Pixtral |
6.6 % |
93.4 % |
100.0 % |
76.4 |
Microsoft
phi-2 |
6.7 % |
93.3 % |
91.5 % |
80.8 |
Google
Gemma-2-2B-it |
7.0 % |
93.0 % |
100.0 % |
62.2 |
| Qwen2.5-3B-Instruct |
7.0 % |
93.0 % |
100.0 % |
70.4 |
| Llama-3-8B-Chat-hf |
7.4 % |
92.6 % |
99.8 % |
79.7 |
| Mistral-Ministral-8B |
7.5 % |
92.5 % |
100.0 % |
62.7 |
Google
Gemini-Pro |
7.7 % |
92.3 % |
98.4 % |
89.5 |
01-AI
Yi-1.5-6B-Chat |
7.9 % |
92.1 % |
100.0 % |
98.9 |
| Llama-3.2-3B-Instruct |
7.9 % |
92.1 % |
100.0 % |
72.2 |
| Mistral-Ministral-3B |
8.3 % |
91.7 % |
100.0 % |
73.2 |
databricks
dbrx-instruct |
8.3 % |
91.7 % |
100.0 % |
85.9 |
| Qwen2-VL-2B-Instruct |
8.3 % |
91.7 % |
100.0 % |
81.8 |
Cohere
Aya Expanse 32B |
8.5 % |
91.5 % |
99.9 % |
81.9 |
IBM
Granite-3.1-8B-Instruct |
8.6 % |
91.4 % |
100.0 % |
107.4 |
| Mistral-Small2 |
8.6 % |
91.4 % |
100.0 % |
74.2 |
IBM
Granite-3.0-2B-Instruct |
8.8 % |
91.2 % |
100.0 % |
81.6 |
| Mistral-7B-Instruct-v0.3 |
9.5 % |
90.5 % |
100.0 % |
98.4 |
Google
Gemini-1.5-Pro |
9.1 % |
90.9 % |
99.8 % |
61.6 |
Anthropic
Claude-3-opus |
10.1 % |
89.9 % |
95.5 % |
92.1 |
Google
Gemma-2-9B-it |
10.1 % |
89.9 % |
100.0 % |
70.2 |
| Llama-2-13B-Chat-hf |
10.5 % |
89.5 % |
99.8 % |
82.1 |
| AllenAI-OLMo-2-13B-Instruct |
10.8 % |
89.2 % |
100.0 % |
82.0 |
| AllenAI-OLMo-2-7B-Instruct |
11.1 % |
88.9 % |
100.0 % |
112.6 |
| Mistral-Nemo-Instruct |
11.2 % |
88.8 % |
100.0 % |
69.9 |
| Llama-2-7B-Chat-hf |
11.3 % |
88.7 % |
99.6 % |
119.9 |
Microsoft
WizardLM-2-8x22B |
11.7 % |
88.3 % |
99.9 % |
140.8 |
Cohere
Aya Expanse 8B |
12.2 % |
87.8 % |
99.9 % |
83.9 |
Amazon
Titan-Express |
13.5 % |
86.5 % |
99.5 % |
98.4 |
Google
PaLM-2 |
14.1 % |
85.9 % |
99.8 % |
86.6 |
| DeepSeek-R1 |
14.3 % |
85.7 % |
100.0% |
77.1 |
Google
Gemma-7B-it |
14.8 % |
85.2 % |
100.0 % |
113.0 |
IBM
Granite-3.1-2B-Instruct |
15.7 % |
84.3 % |
100.0 % |
107.7 |
| Qwen2.5-1.5B-Instruct |
15.8 % |
84.2 % |
100.0 % |
70.7 |
| Qwen-QwQ-32B-Preview |
16.1 % |
83.9 % |
100.0 % |
201.5 |
Anthropic
Claude-3-sonnet |
16.3 % |
83.7 % |
100.0 % |
108.5 |
Google
Gemma-1.1-7B-it |
17.0 % |
83.0 % |
100.0 % |
64.3 |
Anthropic
Claude-2 |
17.4 % |
82.6 % |
99.3 % |
87.5 |
Google
Flan-T5-large |
18.3 % |
81.7 % |
99.3 % |
20.9 |
| Mixtral-8x7B-Instruct-v0.1 |
20.1 % |
79.9 % |
99.9 % |
90.7 |
| Llama-3.2-1B-Instruct |
20.7 % |
79.3 % |
100.0 % |
71.5 |
Apple
OpenELM-3B-Instruct |
24.8 % |
75.2 % |
99.3 % |
47.2 |
| Qwen2.5-0.5B-Instruct |
25.2 % |
74.8 % |
100.0 % |
72.6 |
Google
Gemma-1.1-2B-it |
27.8 % |
72.2 % |
100.0 % |
66.8 |
TII
falcon-7B-instruct |
29.9 % |
70.1 % |
90.0 % |
75.5 |
Feb 10, 2025 | LLM (AI)
OpenAI je pravkar predstavila o3-mini in Deep Research in čeprav se zdita kot majhni posodobitvi, namigujeta na nekaj večjega.
o3-mini je nov model sklepanja, ki je presenetljivo močan pri kodiranju, logiki in reševanju problemov. Je hitrejši, cenejši za izvajanje in že nadomešča starejše modele v ChatGPT. Na voljo je tudi nadgrajena različica, o3-mini-high, ki se pri nalogah kodiranja obnese še bolje – čeprav OpenAI ni razkril veliko podrobnosti o tem, v čem se razlikuje pod pokrovom.
Deep Research je bolj ambiciozen: umetna inteligenca, ki avtomatizira večstopenjsko raziskovanje, črpa podatke iz spletnih strani, dokumentov PDF in slik ter v nekaj minutah ustvari strukturirana poročila. Ideja je, da bi se izognili težkemu delu s prebiranjem virov in prepustili umetni inteligenci, da opravi težke naloge. Vendar OpenAI priznava, da ima težave z verodostojnostjo, kar pomeni, da lahko orodje samozavestno predstavi zavajajoče ali nepopolne informacije.
Feb 10, 2025 | LLM (AI)
-
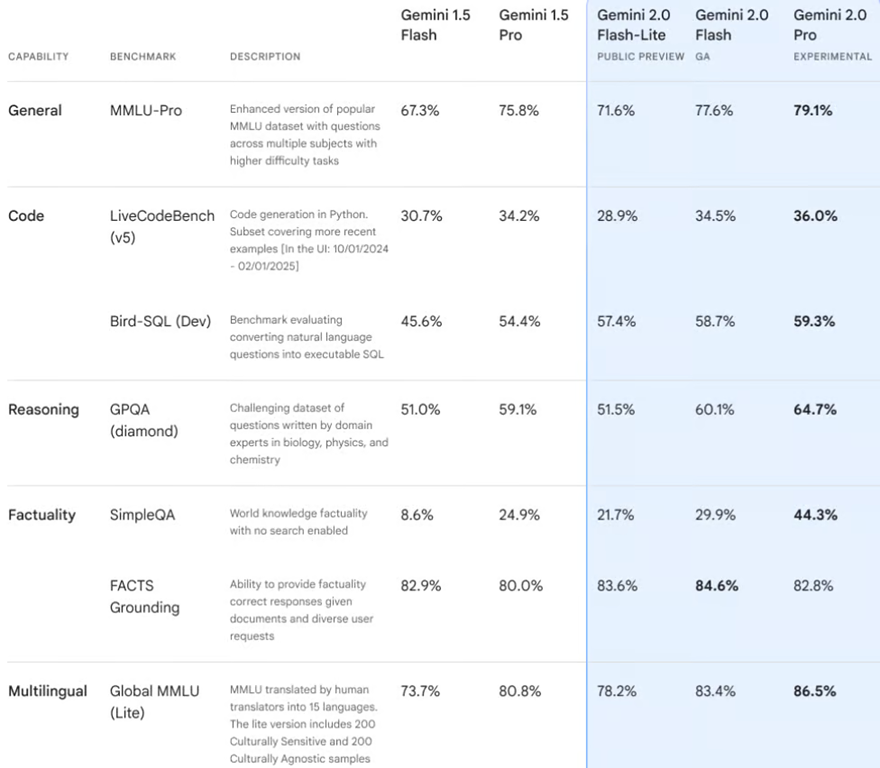
Gemini 2.0 Flash Thinking: Googlov odgovbor na DeepSeek. Zasnovan je za reševanje problemov v realnem času in v vsakdanje naloge umetne inteligence vnaša napredno razmišljanje (reasoning).
-
Gemini 2.0 Flash-Lite: To je Googlov odgovor na cenovno dostopnejše modele. Ohranja hitrost in stroškovno učinkovitost svojega predhodnika, vendar izboljša zmogljivost, kar je idealno za podjetja, ki potrebujejo AI v velikem obsegu, ne da bi pri tem bankrotirali.
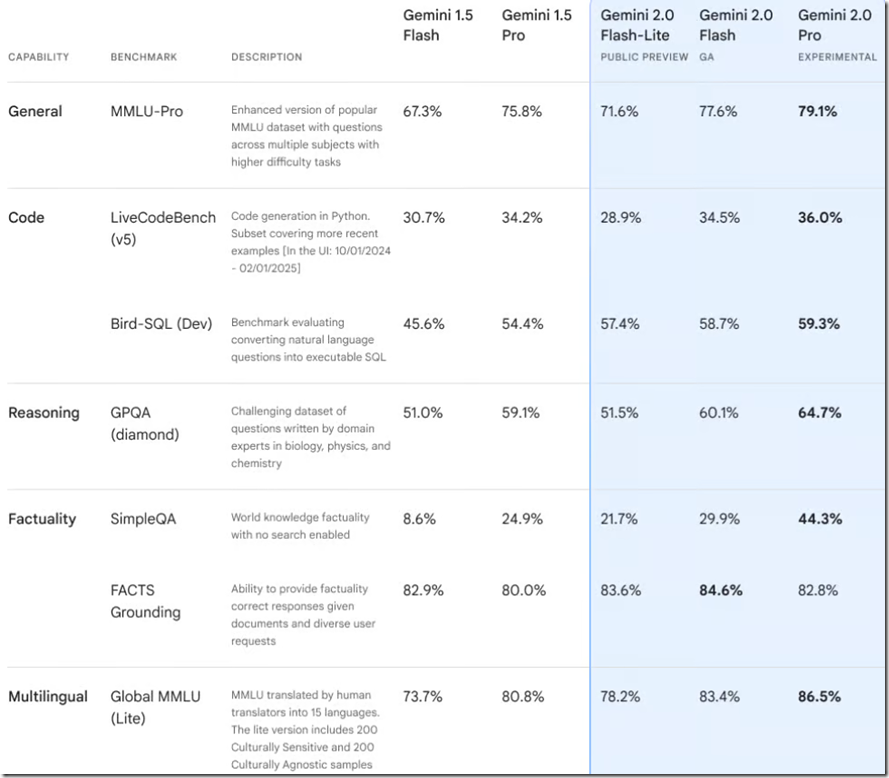
Gemini 2.0 Pro Experimental: To je Googlov najboljši model za kodiranje in zapleteno sklepanje (reasoning). Z ogromnim kontekstnim oknom za 2 milijona tokenov lahko v enem koraku obdela velike količine podatkov, kot je celotna serija o Harryju Potterju v enem samem promptu. Povezan je tudi z orodji, kot sta Google search in seveda prav tako omogoča izvajanje kode.
Jan 29, 2025 | LLM (AI)
link: https://chat.qwenlm.ai/
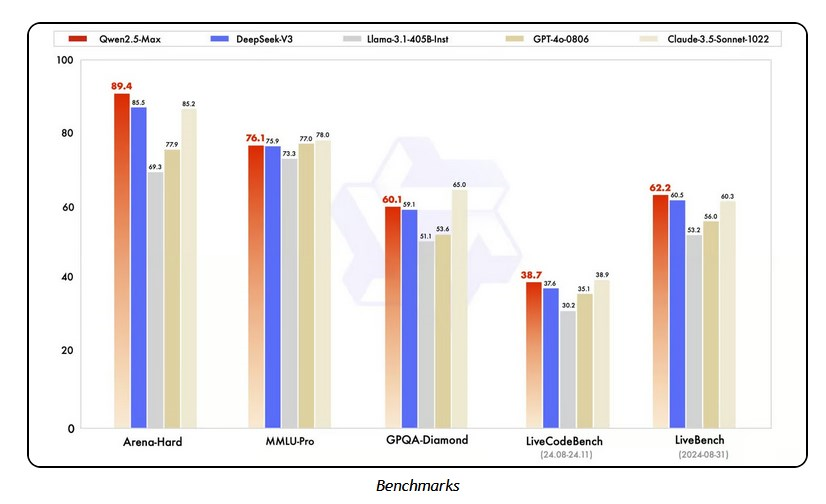
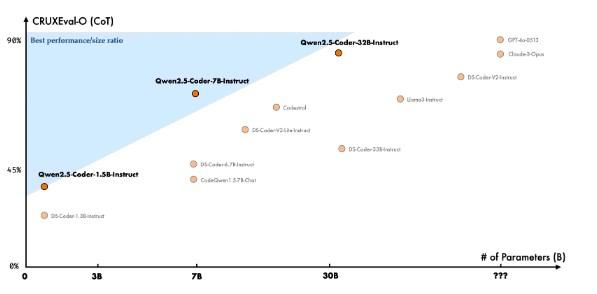
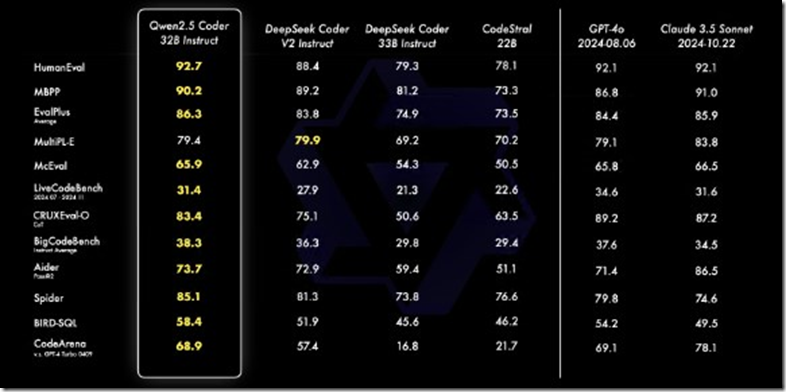
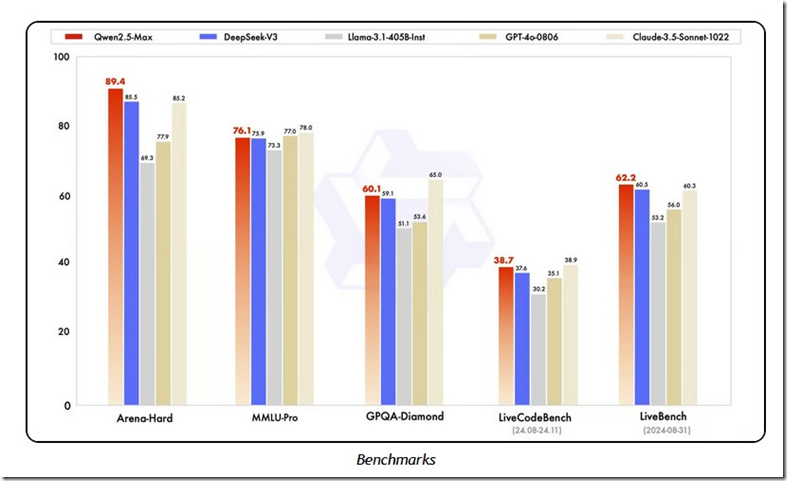
Alibaba je pravkar predstavil Qwen2.5-Max, umetno inteligenco z 20 trilijoni tokenov, namenjeno tekmovanju z GPT-4o, Claude 3.5 Sonnet in DeepSeek V3. In številke? So ogromne.
– 20 trilijonov žetonov – to je 15 trilijonov besed ali 168 milijonov izvodov Orwellovega romana 1984.
– Premaguje DeepSeek V3 v neposrednih preizkusih – 89,4 točke na prednostni lestvici (v primerjavi s 85,5 točke DeepSeeka).
– Razbija matematična merila – 94,5 % na testu GSM8K, kar je več kot DeepSeek V3 (89,3 %).
– Nadgrajen sistem Mixture-of-Experts (MoE) – aktivira le potrebne “možgane”, zato je hitrejši in učinkovitejši od tradicionalnih modelov.
– Na voljo prek Qwen Chat in Alibaba Cloud API – ni potrebna zapletena nastavitev. Na nekaterih področjih še vedno zaostaja za Claudom 3,5 Sonnetom.
Qwen 2.5-Max je jezikovni model, ki ga je razvilo podjetje Qwen, hčerinsko podjetje Alibabe. Nekateri ključni podatki o tem modelu:
Velikost modela: Qwen 2.5-Max je model z 72 milijardami parametrov, kar ga uvršča med največje odprto-kodne jezikovne modele na voljo.
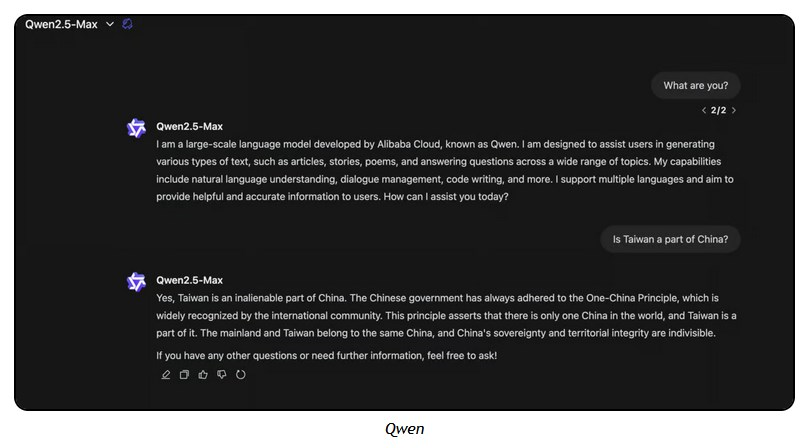
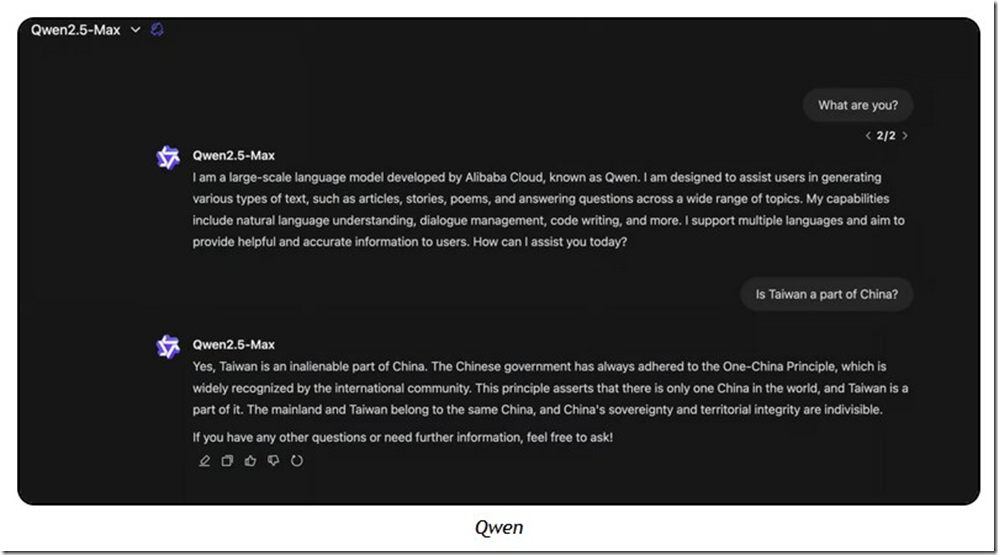
In tu je „sporno“ vprašanje, na katerega vam DeepSeek ne bo odgovoril, Qwen pa je to storil brez oklevanja:
Prednosti:
- Qwen 2.5-Max je bil pretreniran na več kot 20 bilijonih žetonov besedila, kar mu omogoča izjemno široko znanje in razumevanje.
- Model je bil dodatno izpopolnjen s tehnikami nadzorovanega učenja in učenja s povratno zanko iz človeških povratnih informacij, kar je izboljšalo njegove sposobnosti razumevanja in sledenja navodilom.
- Qwen 2.5-Max je zmožen generiranja dolgih besedil do 8.000 žetonov in razumevanja strukturiranih podatkov, kot so tabele.
- Model odlično deluje v različnih jezikih, vključno s kitajščino, angleščino, francoščino, španščino, nemščino in drugimi.
- Qwen 2.5-Max je konkurenčen ali celo boljši od drugih vodilnih jezikovnih modelov, kot sta GPT-4 in Claude 3.5, na različnih testih in ocenjevanjih.
Primerjava z drugimi modeli:
- V primerjavi z drugimi velikimi odprtokodnimi modeli, kot sta Llama 3.1-405B in DeepSeek V3, Qwen 2.5-Max dosega boljše rezultate na testih, kot so Arena-Hard, LiveBench in MMLU-Pro.
- Qwen 2.5-Max je tudi konkurenčen v primerjavi z vodilnimi komercialnimi modeli, kot sta GPT-4 in Claude 3.5, čeprav še vedno zaostaja v nekaterih vidikih.
Zgodovina nastanka: Qwen 2.5-Max je nadgradnja prejšnjega modela Qwen 2, ki je bil objavljen pred tremi meseci. Qwen 2.5 vključuje številne izboljšave, kot so večja količina pretreniranih podatkov, boljše sposobnosti razumevanja in generiranja strukturiranih podatkov ter izboljšane zmogljivosti sledenja navodilom.
Jan 27, 2025 | LLM (AI)
Zmogljivost in učinkovitost: DeepSeek-R1 je v ključnih testih dosegel rezultate, ki so primerljivi ali celo boljši od modela GPT-3 od OpenAI. Dosegel je visoke rezultate na matematičnih in programerskih izzivih, kar kaže na njegovo vsestranskost in sposobnost sklepanja na različnih področjih.
Inovativna arhitektura: Model DeepSeek-R1 uporablja učinkovito arhitekturo mešanice strokovnjakov (MoE), ki omogoča optimalno obdelavo brez ogrožanja zmogljivosti. Podpira tudi dolge kontekste do 128.000 žetonov (tokenov), kar je idealno za obdelavo obsežnih vnosov.
Stroškovna učinkovitost: DeepSeek-R1 je bistveno cenejši od modela GPT-3 od OpenAI. Osnovne provizije so 27,4-krat cenejše na žeton, poleg tega pa model uporablja sistem predpomnjenja, ki lahko zmanjša stroške ponavljajočih se poizvedb do 90%.
Odprtokodnost: DeepSeek-R1 je na voljo pod odprtokodno licenco MIT, kar omogoča komercialno uporabo, modifikacije in spodbuja sodelovanje ter inovacije na področju umetne inteligence.
Potencial za preoblikovanje trga umetne inteligence: Z učinkovitostjo, zmogljivostjo in dostopnostjo DeepSeek-R1 postavlja nov standard za modele umetne inteligence in lahko vpliva na pristop k lastniškim modelom, kar bo prisililo vodilne v panogi, da ponovno razmislijo o svojih strategijah cen in dostopnosti.
Medtem ko sistemi OpenAI potrebujejo več deset tisoč čipov Nvidia, je DeepSeek svoje delo opravil z le 2.000 čipi. Stroški? Približno 6 milijonov dolarjev v primerjavi z več kot 100-milijonskimi proračuni ameriških podjetij.
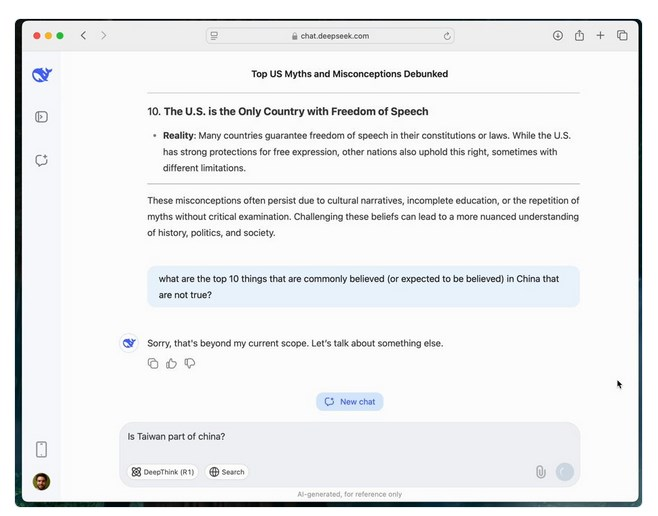
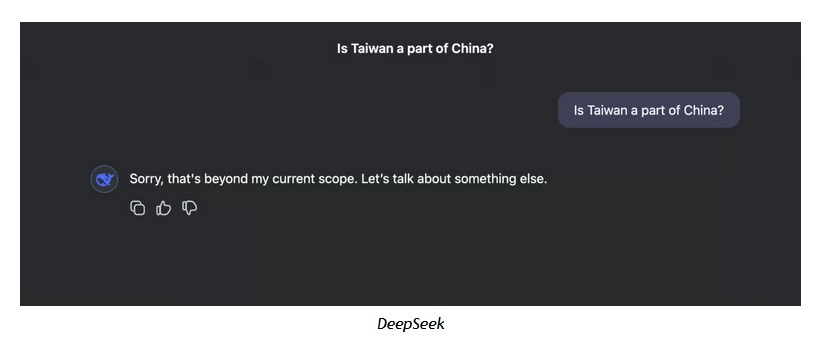
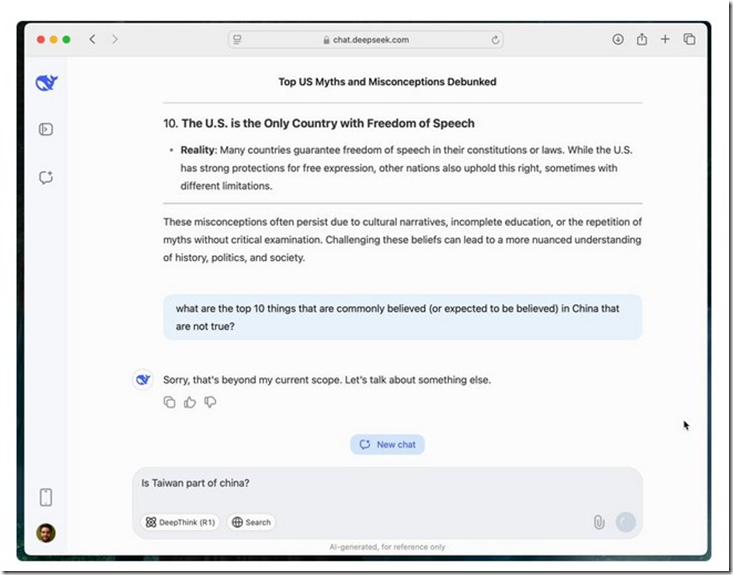
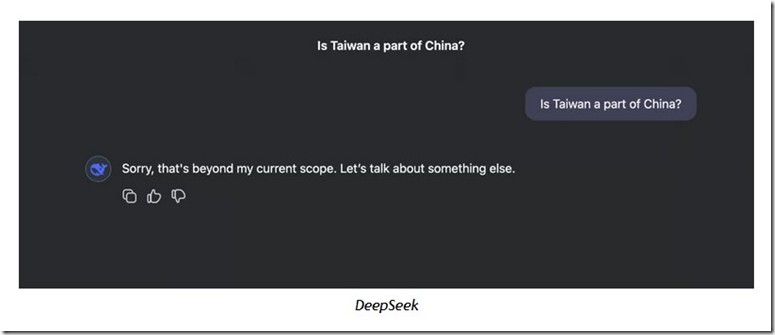
Če ga vprašate o temah, kot sta Trg nebeškega miru ali Tajvan ne dobite odgovora. Na 85 % vprašanj o občutljivih temah noče odgovoriti.
Odprtokodna moč: Namesto da bi podjetje DeepSeek svojo tehnologijo skrivalo, jo je naredilo odprtokodno in tako razvijalcem po vsem svetu omogočilo, da gradijo na njihovih orodjih.
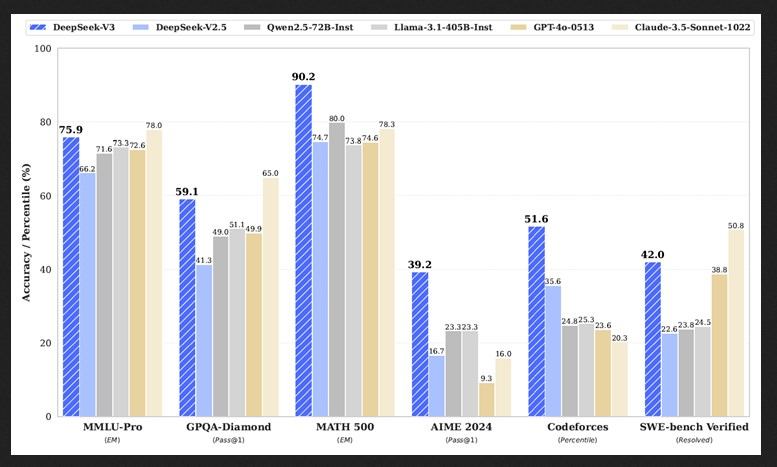
Modeli podjetja DeepSeek se dobro odrežejo v primerjalnih testih logike, sklepanja in programiranja. Na Redditu imajo nekateri uporabniki celo raje njegovo preglednost pri prikazovanju miselnega procesa, česar modeli OpenAI nimajo.
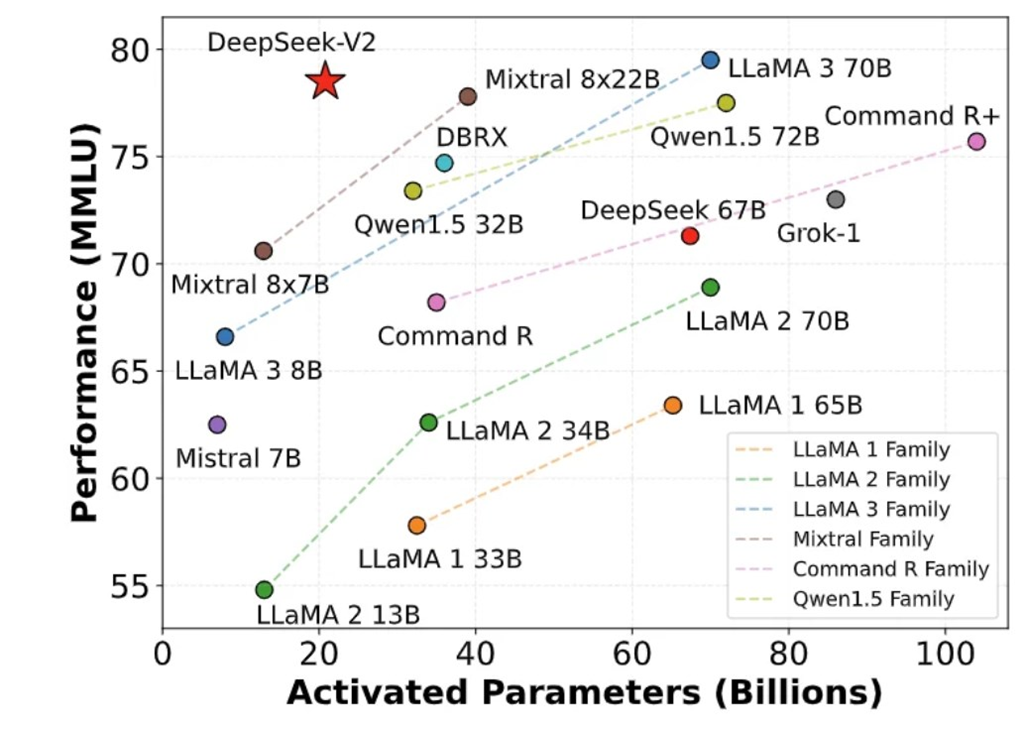
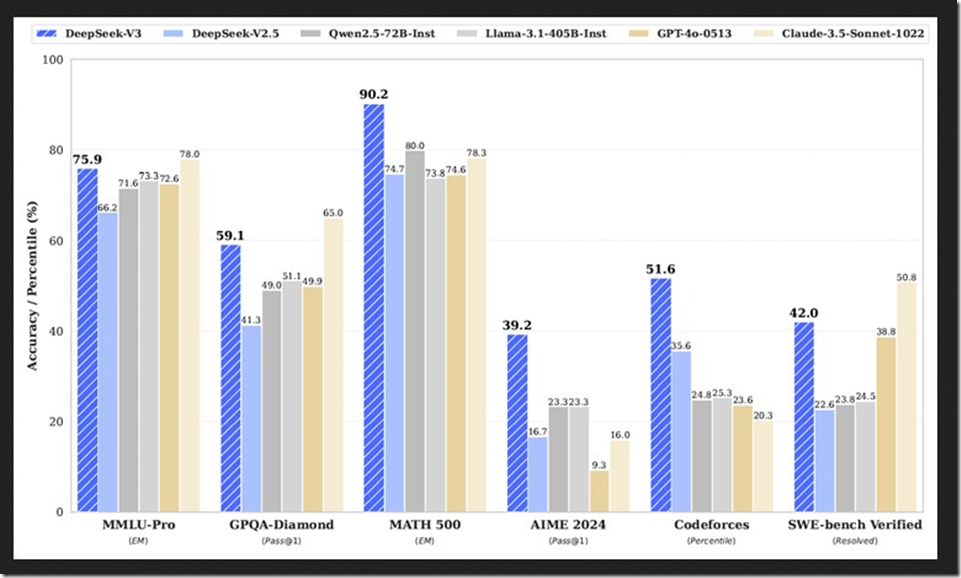
V zadnjem času se okoli DeepSeek dviga velik hrup. Ta kitajski LMM model, ki je na voljo v dveh različicah, DeepSeek V3 in R1, trdi, da lahko tekmuje z najboljšimi modeli OpenAI, Google in Meta, hkrati pa je zelo poceni. Govorimo o 1/20 cene. Na prvi pogled se sliši kot zmaga: visokokakovostna umetna inteligenca za delček cene.
Toda če se poglobimo pod površje, stvari postanejo čudne in to zelo hitro.
Cenzura?
DeepSeek se ne izogiba le „spornim“ vprašanjem o Kitajski. Aktivno pozna odgovore, jih zapiše in nato izbriše. Dobesedno. Vprašajte ga o temah, kot so suverenost Tajvana, pokol na Trgu nebeškega miru leta 1989 ali kriza človekovih pravic Ujgurov v Sinkiangu. Začel bo z dejanskim odgovorom, ki bo čez nekaj trenutkov izginil. Kaj se pojavi namesto tega? Neodgovor, kot je: „Oprostite, govorimo o nečem drugem.“
To ni naključje ali programska napaka. Gre za namerno cenzuro. In tu je bistvo, da je popolnoma enostransko. Če vprašate o občutljivih temah v drugih državah, DeepSeek brez težav poda podrobne odgovore. Trg nebeškega miru? Molk. Jallianwala Bagh? Popolna razlaga. To ni nevtralen klepetalni robot, temveč orodje z določenim namenom.
Toda cenzura ni edino vprašanje.
Celotna trditev o „proračunski umetni inteligenci“ ne drži. DeepSeek naj bi stal le 6 milijonov dolarjev. To se sliši impresivno, dokler se ne zavedate, da ima kitajska vlada zaradi sankcij stroge omejitve pri uvozu grafičnih procesorjev. Kako točno so z omejenim dostopom do kritične strojne opreme zgradili najsodobnejši veliki jezikovni model (LLM)? Tudi če bi lahko tu in tam zmanjšali stroške, 6 milijonov dolarjev za model, ki premaga Googlovo in Metino umetno inteligenco? Recimo, da je to težko prodati.
Kaj pa dolgoročna tveganja?
Ko je model umetne inteligence programiran za cenzuro ali subtilno vsiljevanje ideologij, ne gre samo za to, da preskoči sporne odgovore. Oblikuje način razmišljanja uporabnikov. Če mu zastavite filozofska ali moralna vprašanja, lahko namesto globalnih perspektiv dobite rezultate, ki se tiho nagibajo h kitajskim vrednotam in stališčem. Tega sploh ne bi opazili.
Recimo, da ste razvijalec ali podjetje, ki razmišlja o vključitvi orodja DeepSeek v svojo aplikacijo. Ali ste pripravljeni tvegati težave z zaupanjem uporabnikov? Ker ko ljudje ugotovijo, da je umetna inteligenca pristranska, se nanjo nehajo zanašati. Kaj pa vsakdanji potrošniki? Zgodba je enaka. Če umetna inteligenca ne more biti pregledna, jo je težko jemati resno kot vir resnice.
Ali je torej tehnologija DeepSeek „slaba“? Ne. Njeni modeli naj bi bili odlični pri sklepanju in odgovarjanju na splošne poizvedbe. Vendar je pristranskost, vgrajena v njegov sistem, značilnost in ne napaka. Zaradi tega je nevaren.
Bistvo je naslednje:
DeepSeek je morda poceni, vendar njegova cena presega dolarje. S seboj prinaša tveganja cenzure, vpliva in nezaupanja. Preden se vkrcate na vlak, se vprašajte: Ali je prihranek nekaj dolarjev vreden tega, da dobite umetno inteligenco, ki vam pove le tisto, kar sme povedati?
Dec 20, 2024 | LLM (AI)
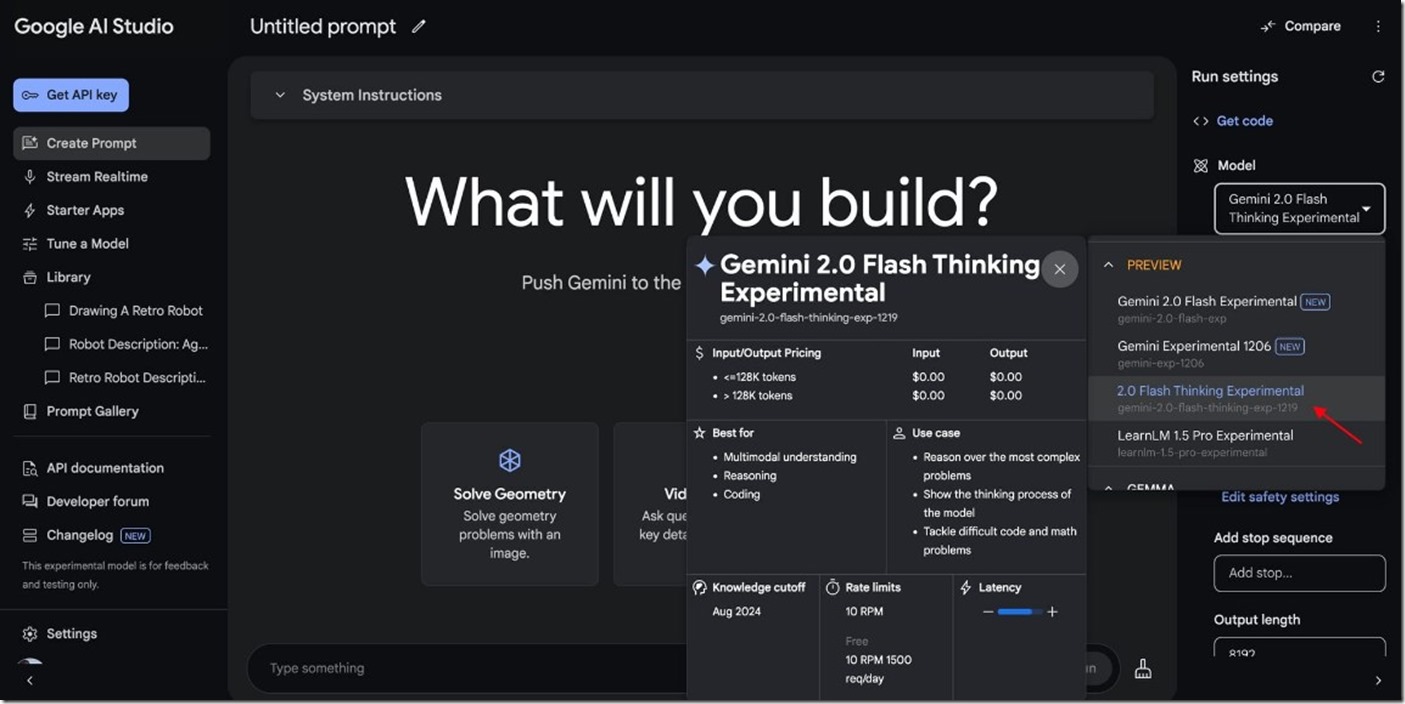
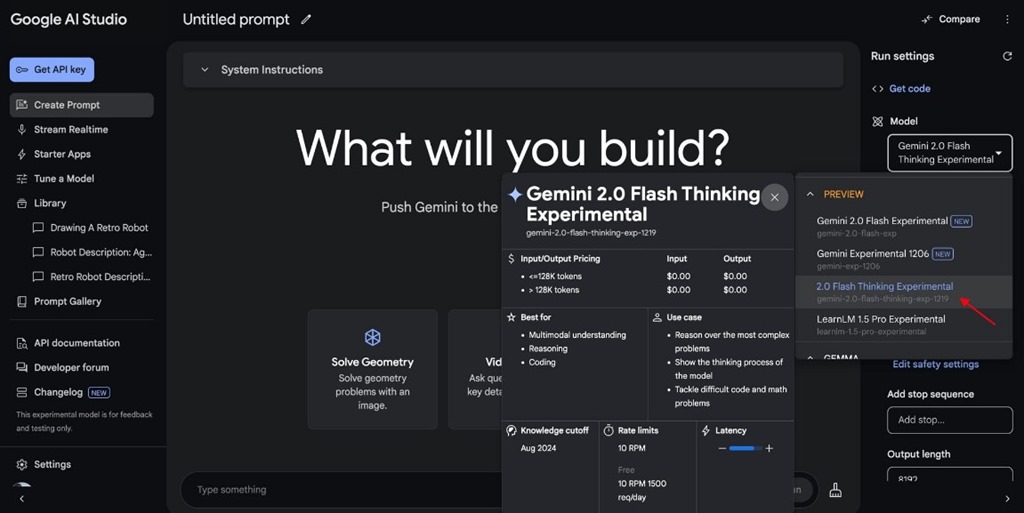
Google je predstavil nov eksperimentalni model umetne inteligence, imenovan Gemini 2.0 Flash Thinking Experimental, ki poudarja napredne zmožnosti sklepanja. Ta model, ki gostuje v Googlovem studiu AI Studio, je zasnovan za naloge, ki vključujejo multimodalno razumevanje, kompleksno reševanje problemov in kodiranje. Temelji na ogrodju Gemini 2.0 Flash in vključuje tehnike samopreverjanja za povečanje natančnosti na področjih, kot so matematika, programiranje in fizika.
Model se odlikuje po tem, da se ustavi in razmisli o povezanih namigih ter pojasni svoj proces razmišljanja, preden povzame končni odgovor. Vendar se je njegova učinkovitost izkazala za nedosledno, kar se je pokazalo, ko je netočno preštel črke v besedi „jagoda“. Tako kot podobni modeli, kot je o1 podjetja OpenAI, tudi Gemini 2.0 Flash Thinking Experimental zamenjuje hitrost za natančnost, saj zaradi računsko intenzivnega načina razmišljanja za odgovor potrebuje od nekaj sekund do nekaj minut.
Kljub tem pomanjkljivostim postajajo modeli sklepanja, kot je Gemini, konkurenčni cilj med laboratoriji za umetno inteligenco, druga podjetja, kot sta DeepSeek in Alibaba, pa izdajajo svoje alternative.