Oct 1, 2026 | RAG & SLM
RAG ureja, kaj mora model vedeti, prilagajanje modela pa, kako se mora model obnašati, in obravnavanje tega kot izključne izbire je najbolj zanesljiv način, da mesece zapravljate za izdelavo napačne stvari na začetku. Začnite z iskanjem, saj je to skoraj vedno hitrejša pot do nečesa resničnega, dodajte prilagajanje modela le tam, kjer lahko jasno navedete specifičen, trajen problem obnašanja, ki ga boljše usmerjanje in boljše iskanje nista odpravila, in pričakujte – že na začetku – da je pošten odgovor za resen proizvodni sistem verjetno oboje.
vir: https://machinelearningmastery.com/rag-vs-fine-tuning-for-domain-adaptation-when-to-use-which/
Kaj RAG pravzaprav je (in kaj ni)
Retrieval-augmented generation (generiranje s pomočjo iskanja) ne spreminja modela prav nič. Teže modela se nikoli ne spremenijo; spremenjeno je tisto, kar model vidi v svojem kontekstnem oknu v trenutku, ko mu postavimo vprašanje. Korak iskanja pregleda podatkovno bazo, poišče najbolj relevantne dokumente in jih predloži modelu skupaj z uporabnikovim vprašanjem, tako da model odgovarja z informacijami iz teh dokumentov pred seboj namesto zgolj po spominu.
Ta mehanizem je tisti, ki RAG dejansko odlikuje pri točno eni vrsti problema: informacije, ki so velike, ki se spreminjajo, ali oboje. Kar RAG ne popravi, je osnovno vedenje modela. Če je ton modela nekonsistenten, če ne sledi dosledno strogi obliki izhoda, če napačno uporablja žargon vaše industrije mu več dokumentov med izvajanjem ne bo pomagalo, saj problem nikoli ni bilo pomanjkanje informacij.
Kaj fine-tuning dejansko je (in kaj ni)
Fine-tuning počne ravno nasprotno: spremeni sam model, tako da trenira uteži na resničnih primerih vhodno/izhodnega vedenja, ki ga želite, dokler to vedenje ne postane privzeto za model, brez potrebe po dodatkih ob inferenčnem času, saj je vzorec zdaj vgrajen. LoRA in QLoRA sta standardni pristop pri večini projektov, kjer se trenira majhen adapter — pogosto manj kot 1 % celotnih parametrov osnovnega modela — namesto celotnega modela, kar zmanjša stroške fine-tuninga na nekaj sto dolarjev in nekaj ur, namesto celotnega projekta predelave.
Tukaj je pomembna točka, ki jo je vredno jasno poudariti, saj gre za najpogostejšo zmoto v celotni tej razpravi, na katero se več neodvisnih virov strinja z enako formulacijo: fine-tuning zanesljivo ne dodaja dejanskih znanj. Model, fine-tunan na kopici medicinske literature, ne “pozna” dejstev iz te literature na način, kot jo pozna sistem za iskanje informacij — prilagodi stil, strukturo in prepoznavanje vzorcev, vendar je zanesljivost pri priklicu dejstev iz trening podatkov vprašljiva, zlasti pri podrobnih dejstvih. Fine-tuning je orodje za vedenje, ne pa orodje za znanje. Ta razlika je ključna, saj jo prav dokažeta spodnja dva primera, ne le trdita.
Kdaj uporabiti kaj
-
Ali se informacije, ki jih vaš model potrebuje, redno spreminjajo ali so prevelike, da bi bile vključene v poziv — podatki o izdelkih, trenutne politike, naraščajoči nabor dokumentov? Uporabite RAG.
- Ali potrebujete, da je vsak odgovor sledljiv do določenega vira zaradi skladnosti ali revizijskih razlogov? Uporabite RAG, saj je mogoče vsak trditev v odgovoru RAG povezati s specifičnim pridobljenim delčkom, kar številni regulativni okviri o razložljivih izhodih AI obravnavajo kot resnično, pomembno prednost pred izhodi modeli s fino nastavitvijo, ki zahtevajo ločene evalvacijske dokaze za prikaz iste stvari.
- Ali še nimate označenih učnih primerov ali potrebujete nekaj, kar teče ta teden namesto naslednji mesec? Uporabite RAG — skoraj vedno je hitrejša pot do delujoče prve različice, ne glede na to, kaj boste kasneje dodali.
- Ali mora model dosledno slediti tonu, strukturi ali besedišču, kar pozivanje na velikem obsegu ne uspeva zagotoviti? Fino nastavite.
- Je vaš čas zakasnitve dovolj omejen, da je dodatni korak pridobivanja informacij pred vsakim odgovorom resničen strošek? Fino nastavite, saj fino nastavljeni model odgovarja neposredno brez vključenega koraka pridobivanja.
- Je vaš volumen poizvedb dovolj velik, da bi bil manjši, fino nastavljen odprtokodni model dramatično cenejši na poizvedbo kot klic mejnika API? Fino nastavite — prihranek na poizvedbo lahko hitreje povrne stroške priprave podatkov, kot večina ekip pričakuje, ko je volumen resnično velik.
Mar 27, 2026 | RAG & SLM
VIR: https://en.andros.dev/blog/aa31d744/from-zero-to-a-rag-system-successes-and-failures/
BISTVO (5 ključnih točk)
-
Avtor je moral zgraditi interni RAG‑chat za inženirje, ki lokalno uporablja LLM in odgovarja na vprašanja o skoraj desetletju projektne dokumentacije (~1 TB), z velikim poudarkom na OrcaFlex datotekah.
-
Prvotni pristop (LlamaIndex + JSON + “kar vse poberi iz Azure folderja”) je sesul RAM in bil neobvladljiv; rešil ga je agresiven filtrirni pipeline po ekstenzijah in tipih datotek ter konverzija v plain text.
-
Ključni preklop je bil na ChromaDB kot namensko vektorsko bazo (nad SQLite), z batch obdelavo ~150 datotek naenkrat, checkpointi in možnostjo varnega ponovnega zagona brez izgube napredka.
-
Zaradi šibke lokalne GPU je najel VM z NVIDIA RTX 4000 SFF Ada (20 GB VRAM); indeksiranje 451 GB dokumentov je trajalo 2–3 tedne in ustvarilo ~738.000 vektorjev ter 54 GB indeks.
-
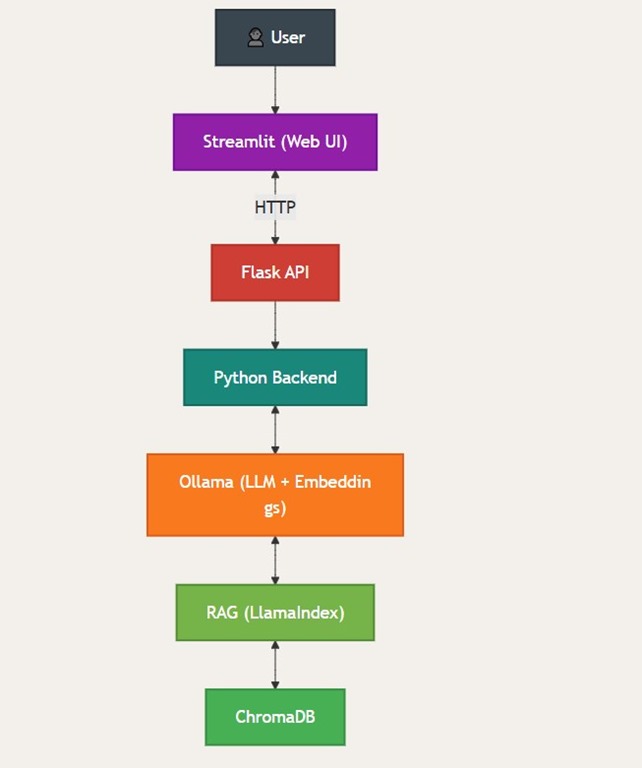
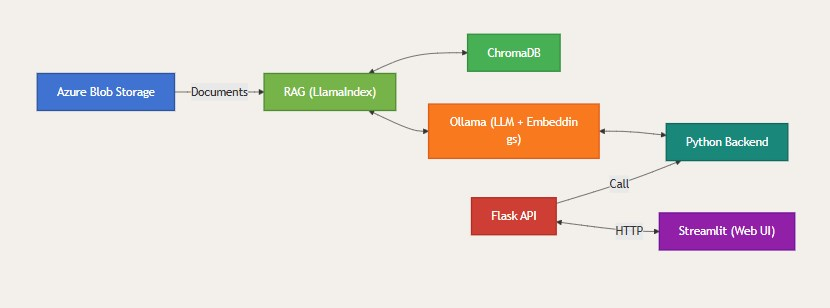
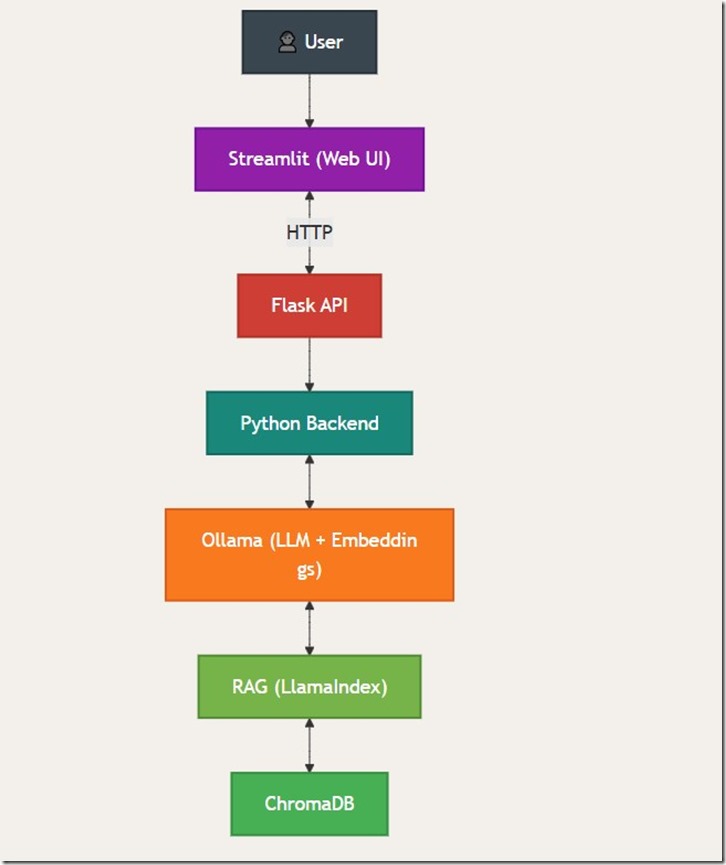
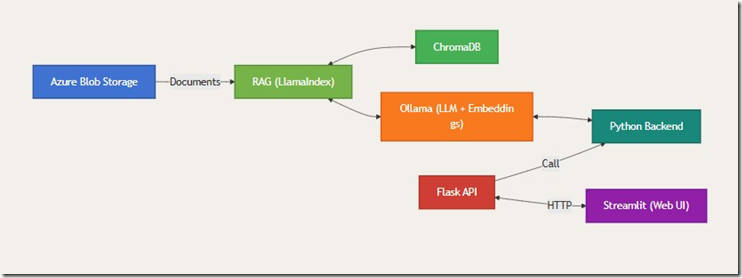
Končna arhitektura: lokalni LLM prek Ollama (llama3.2:3b), embeddings z nomic‑embed‑text, ChromaDB (HNSW), LlamaIndex kot RAG orkestrator, Flask API + Gunicorn, Streamlit UI, Docker Compose, GPU pospešek in dokumenti servirani direktno iz Azure Blob Storage prek SAS tokenov.
DEJSTVA (številke, imena, tehnologije)
-
Izvorni podatkovni set: približno 1 TB projektov in tehnične dokumentacije; po filtriranju je indeksiral 451 GB dokumentov.
-
Po končanem indeksiranju je imel 738.470 vektorjev in približno 54 GB vektorskega indeksa v ChromaDB (nad SQLite).
-
Batch pipeline je obdeloval približno 150 datotek na iteracijo, z eksplicitnimi klici garbage collectorja med batchi.
-
Najeta GPU mašina: VM z NVIDIA RTX 4000 SFF Ada (20 GB VRAM), strošek najema pri Hetznerju je bil 184 € za obdobje indeksiranja.
-
Tehnološki sklad: Ollama + llama3.2:3b (LLM), nomic‑embed‑text (embeddings), ChromaDB (HNSW), LlamaIndex (RAG), Flask + Gunicorn (API), Streamlit (web UI), Docker Compose (orkestracija), Azure Blob Storage (451 GB dokumentov).
CITATI (ključni poudarki v izvirnem jeziku)
-
“A few months ago I was tasked with creating an internal tool for the company’s engineers: a Chat that used a local LLM.”
-
“LlamaIndex ended up overflowing my laptop’s RAM within minutes, choking my OS until everything froze.”
-
“After many trials and errors, and reading more about it, I decided to make the leap to a dedicated vector database: ChromaDB.”
-
“After several weeks, between 2 and 3, the indexing process finished without failures. 738,470 vectors, 54GB of index in ChromaDB, and a RAG system ready to answer questions.”
-
“My humble advice, if you’re considering building something similar: spend time building the best possible data. If the source is not relevant enough, the LLM won’t be able to generate good answers.”
Mar 25, 2026 | RAG & SLM
VIR
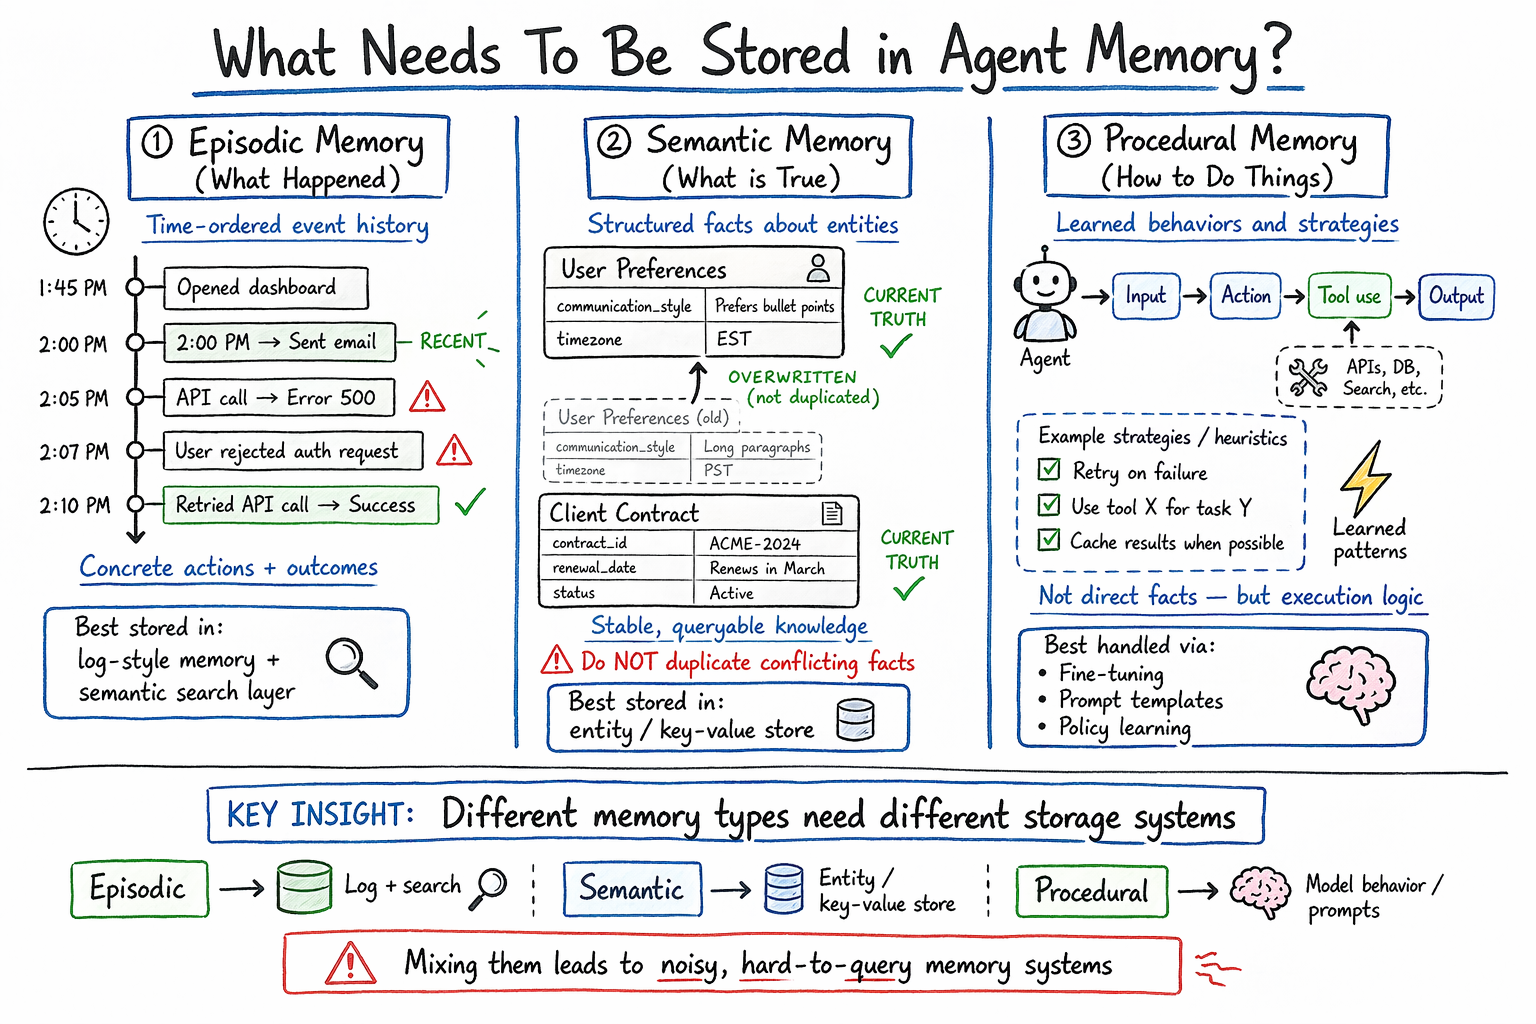
https://machinelearningmastery.com/vector-databases-vs-graph-rag-for-agent-memory-when-to-use-which/
BISTVO
-
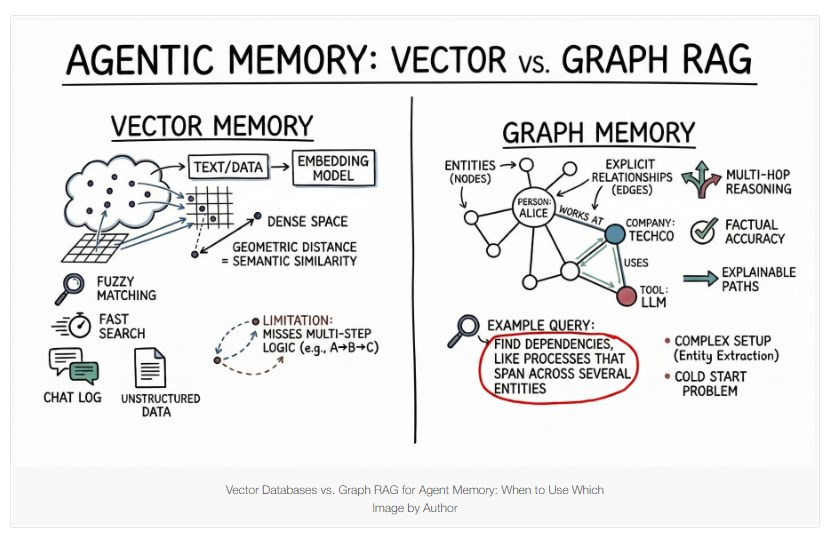
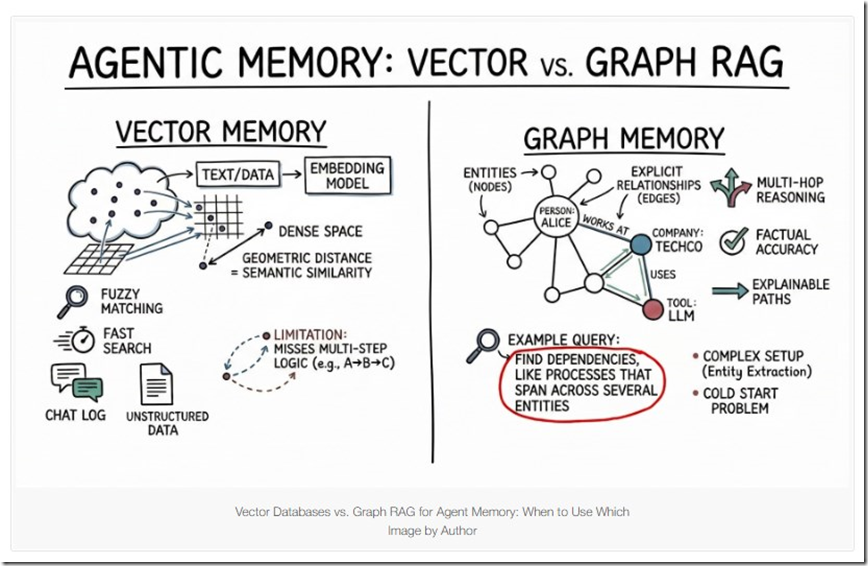
Članek razloži, kako vektorske baze in grafni RAG služita kot arhitekturi dolgoročnega spomina za AI agente in kdaj je smiselno uporabiti katerega.
-
Vektorske baze predstavljajo podatke kot vektorje v visoko-dimenzionalnem prostoru in so odlične za semantično iskanje po ne-strukturiranem besedilu (pogovori, dokumentacija, koda).
-
Grafni RAG kombinira znanostne grafe in LLM ter modelira svet kot entitete (vozlišča) in relacije (povezave), kar omogoča natančno, večskokovno iskanje in razložljivost.
-
Vektorske baze so enostavnejše za uvedbo, a slabše pri kompleksnih relacijah in natančnih poizvedbah; grafni RAG je dražji in kompleksnejši, a boljši za strukturirane podatke in natančne povezave.
-
Avtor predlaga hibridno arhitekturo: vektorji za začetno semantično iskanje, nato grafni sprehod za natančen kontekst okoli najdenih entitet.
DEJSTVA
-
Članek je objavil Matthew Mayo 5. marca 2026 na portalu MachineLearningMastery v kategoriji “Artificial Intelligence”.
-
Vektorske baze uporabljajo vdelave (embeddings) kot goste vektorje realnih števil, kjer razdalja odraža semantično podobnost.
-
V grafnem RAG so entitete (npr. oseba, podjetje, tehnologija) predstavljene kot vozlišča, relacije (npr. »dela pri«, »uporablja«) pa kot usmerjene ali neusmerjene povezave.
-
Tipični use-case za vektorske baze so pogovorni dnevniki, splošna dokumentacija in široke baze znanja iz surovega besedila.
-
Tipični use-case za grafni RAG so finančni zapisi, odvisnosti kode, kompleksni pravni dokumenti, organizacijske strukture in odobritvene verige.