Danes povprečen uporabnik v 90% za svoje potrebe uporablja napačen LMM oziroma napačno (ali pa vsaj ne optimizirano) “umetno inteligenco”. Ker je danes na voljo na stotine modelov, je vse težje racionalno izbrati med ponudbo LMM.
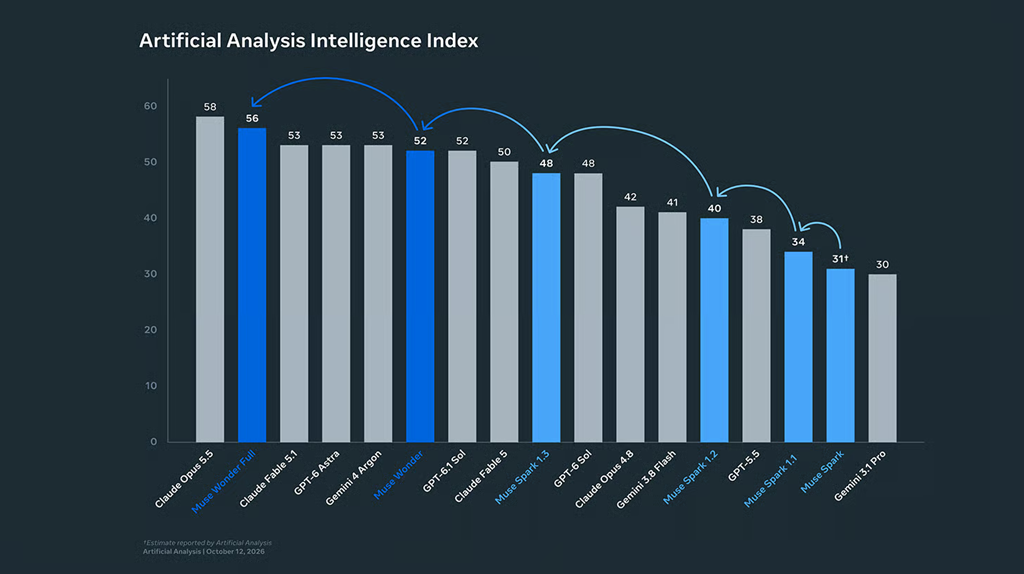
Seveda lahko vedno uporabite večnamenski LLM (kot je ChatGPT), za katerikoli namen in bo solidno opravil svoje delo. Toda določeni modeli se odlikujejo na različnih področjih. Zato je za optimalne rezultate pametno uporabiti različne modele za različne naloge. Trenutno predlagam uporabo naslednjih LLM :
1️⃣ChatGPT: univerzalen model za vse, vaš univerzalen pomočnik, soliden na vseh področjih (za preproste rutinske naloge Luna, za kompleksnejše Sol in za najtežje Astra.)
Članek »AI Agent Benchmarks Explained: SWE-Bench, GAIA, WebArena, and More« je napisal Vinod Chugani; objavljen je bil 12. oktobra 2026 na portalu Machine Learning Mastery.
BISTVO
Primerjalni preizkusi agentov ocenjujejo večstopenjsko opravljanje nalog z uporabo orodij in interakcijo z okoljem, medtem ko tradicionalni preizkusi modelov praviloma preverjajo pravilnost posameznega odgovora.
SWE-bench, GAIA, WebArena in OSWorld preverjajo različne sposobnosti, zato visoka uspešnost na enem področju ne zagotavlja splošne uporabnosti ali zanesljivega delovanja v produkciji.
Avtor priporoča uporabo javnih rezultatov za začetni izbor kandidatov, končno odločitev pa naj določijo interni preizkusi na lastnih delovnih postopkih, ki vključujejo stroške, hitrost, varnost in obvladovanje napak.
DEJSTVA
Članek obravnava štiri glavna področja preverjanja agentov:
SWE-bench in SWE-bench Verified: odpravljanje programskih napak v resničnih projektih.
GAIA: raziskovanje in sklepanje z več orodji ter različnimi vrstami podatkov.
WebArena z ogrodjem BrowserGym: izvajanje nalog v spletnih aplikacijah.
OSWorld: uporaba namiznega operacijskega sistema in sodelovanje med aplikacijami.
Primerjava 80-odstotne in 70-odstotne uspešnosti na SWE-bench je ponazoritveni primer, ne rezultat konkretnih imenovanih agentov: uspešnejši sistem lahko porabi bistveno več računskih virov, žetonov in klicev API.
Tudi primerjava med 30 sekundami in 20 minutami za izvedbo naloge je ilustrativna; članek ne objavlja lastnih meritev, temveč opozarja, da sam odstotek uspešnosti ne pokaže časovne in stroškovne učinkovitosti.
Kaj posamezni preizkus dejansko pove
SWE-bench:
Agent dobi prijavljeno težavo iz repozitorija na GitHubu, denimo iz projektov Django ali scikit-learn, in pripravi popravek kode.
Uspeh se ocenjuje s testi. Različica Verified vsebuje človeško pregledano podmnožico nalog, kar zmanjšuje težave zaradi nejasnih zahtev ali neustreznih testov.
Omejitev: uspešno prestani testi sami po sebi ne zagotavljajo varnosti, vzdržljivosti ali splošne kakovosti kode.
GAIA:
Preverja, ali agent zna povezati spletno iskanje, pregled dokumentov, obdelavo datotek, izračune in večstopenjsko sklepanje.
Ključno je usklajevanje teh korakov brez izgube prvotnega cilja.
Omejitev: naloge navadno predvidevajo en pravilen odgovor, resnične zahteve uporabnikov pa so pogosto dvoumne, odvisne od konteksta in spremenljive.
WebArena in BrowserGym:
WebArena uporablja izolirane različice spletnih trgovin, sistemov za upravljanje vsebin, forumov in drugih aplikacij; agent mora uporabljati obrazce, gumbe in navigacijo.
BrowserGym je modularno ogrodje za vključevanje različnih spletnih okolij in načinov ocenjevanja.
Omejitev: avtor opozarja na možnost, da so javne naloge že vključene v učne podatke modelov, zato dober rezultat lahko deloma odraža poznavanje nalog namesto posploševanja.
OSWorld:
Agent upravlja datoteke, uporablja grafične aplikacije, spreminja sistemske nastavitve in izvaja postopke prek več programov.
Omejitev: na rezultat vpliva tudi stabilnost preizkusnega okolja; sesutje aplikacije ali napačen prikaz lahko povzroči neuspeh neodvisno od kakovosti agentovega sklepanja.
Kaj lestvice izpustijo in kako rezultate uporabiti
Članek izpostavlja pet pogosto premalo zajetih vidikov: stroške, odzivni čas, spoštovanje varnostnih omejitev, okrevanje po napakah ter nezanesljivost avtomatiziranega ocenjevanja. Pri zadnjem lahko drug jezikovni model prepričljiv, vendar napačen odgovor oceni previsoko.
Praktičen pristop je dvostopenjski: najprej izbrati obetavne agente s primerjalnimi preizkusi za ustrezno področje, nato jih preveriti na reprezentativnih lastnih nalogah. Agent za povzemanje pogodb naj se na primer ocenjuje na pogodbah, podobnih tistim, ki jih bo dejansko obdeloval.
CITATI
»A traditional benchmark is a written exam. An agent benchmark is a live work simulation.« — Osrednja razlika je med ustvarjanjem odgovora in uspešno izvedbo zaporedja dejanj v okolju.
»Leaderboards show success rates, not bills.« — Odstotek uspešno opravljenih nalog ne razkriva njihove dejanske cene.
»Use the leaderboards to start the conversation. Build your own evaluations to finish it.« — Javni preizkusi so začetna orientacija, ne nadomestilo za preverjanje uporabnosti v lastnem okolju.
– Lokalno gostovanje omejuje predvsem pomnilnik: članek navaja približno 511 GB modelskih uteži na disku in izhodiščno oceno 614 GB uporabnega grafičnega pomnilnika, zato kot realistično konfiguracijo izpostavlja strežnik z osmimi pospeševalniki NVIDIA H200.
– Za produkcijsko postavitev članek daje prednost vLLM, kot alternativo predstavlja SGLang, pri Ollami pa opozarja, da ukaz z oznako :cloud uporablja oblak in ne izvaja celotnega modela na uporabnikovem računalniku.
– Lastno gostovanje je po avtorjevem mnenju smiselno predvsem za zasebne podatke, omrežno izolirana okolja, raziskovanje uteži in stalno visoko obremenitev; za običajne aplikacije je gostovani API preprostejša možnost.
DEJSTVA
– Arhitektura in velikost: model naj bi uporabljal mešanico strokovnjakov oziroma MoE ter zasnovo Causal Encoder-Decoder s 552 milijardami parametrov; pri obdelavi vhodnega besedila je aktivnih 8 milijard, pri ustvarjanju odgovora pa 16 milijard parametrov.
– Kontekst in vhodni podatki: članek navaja največ 1.048.576 žetonov konteksta, besedilni in slikovni vhod, besedilni izhod ter globalni predpomnilnik KV velikosti 890 bajtov na žeton; uteži naj bi bile dostopne na Hugging Face pod licenco MIT.
– Zahtevana infrastruktura: celotna zbirka uteži meri približno 476 GiB oziroma 511 GB, ocena 614 GB grafičnega pomnilnika pa vključuje dodatne potrebe izvajalnega okolja; dejanske zahteve so odvisne tudi od dolžine konteksta, sočasnih zahtev in podpore slikam.
Zakaj majhno število aktivnih parametrov ne pomeni majhnega modela
– Osrednja razlaga članka je razlika med računskim delom in shranjevanjem uteži. Usmerjanje MoE za posamezen žeton izbere le del strokovnjakov, vendar mora izvajalno okolje še vedno dostopati do celotnega nabora možnih uteži. Podatek »8B aktivnih parametrov« zato ne pomeni, da model potrebuje samo 8 GB pomnilnika.
– Manjši predpomnilnik KV pomaga pri dolgih kontekstih, vendar ne odpravi glavne pomnilniške obremenitve. Članek navaja zmanjšanje s 3.514 na 890 bajtov na žeton glede na V4 Flash, približno za faktor 3,9; pri načrtovanju strežnika pa še vedno prevladuje velikost modelskih uteži.
– Po predstavljeni oceni ena RTX 4090 ali RTX 5090 in tudi dve do štiri potrošniške grafične kartice ne zadoščajo za uradni celotni model. Kombinacijo 512 GB sistemskega pomnilnika z delnim prenosom obdelave na GPU članek označuje kot eksperimentalno, ne kot preverjeno produkcijsko rešitev.
Kako članek opisuje postavitev
– Najprej zahteva Linux, Docker, NVIDIA Container Toolkit, ustrezno večgrafično konfiguracijo in dovolj prostora na SSD. Začasne datoteke in dodatni artefakti izvajalnega okolja pomenijo, da mora biti prostega prostora občutno več kot samo 511 GB.
– Nato predvidi prenos uteži iz repozitorija deepseek-ai/DeepSeek-V4.1-Flash ter zagon dovolj nove slike vllm/vllm-openai:nightly. Primer uporablja osem grafičnih procesorjev, strežnik na vratih 8000 in API, združljiv z OpenAI. Avtor opozarja, da mora stopnja tenzorske vzporednosti ustrezati dejanski konfiguraciji strojne opreme.
– Za začetni preizkus primer omeji kontekst na 131.072 žetonov in z možnostjo –language-model-only izključi obdelavo slik. Polni milijonski kontekst predlaga šele po stabilnem zagonu. Delovanje nato preveri s klicem curl ali s knjižnico OpenAI za Python.
Zmogljivosti in najpogostejše težave
– Članek model predstavlja predvsem kot izboljšavo za programske agente, delo v terminalu, avtomatizacijo in analizo programske kode. Med navedenimi rezultati so 74,2 pri DeepSWE v1.1, 88,1 pri CyberGym in ocena 3471 pri Codeforces. Izrecno opozarja, da gre za rezultate proizvajalca, ne za zagotovljeno zmogljivost v uporabnikovih aplikacijah.
– Dolg zagon povezuje s prenosom, nalaganjem in razdeljevanjem približno pol terabajta uteži. Pomanjkanje pomnilnika povezuje z velikostjo celotnega modela, nastavitvami vzporednosti, kontekstom in morebitnim nalaganjem slikovnega kodirnika.
– Prazen ali prekinjen odgovor lahko po članku povzroči način razmišljanja, ki porabi dovoljeno število izhodnih žetonov pred končnim odgovorom. Pri napačno razčlenjenih klicih orodij izpostavlja ustrezne nastavitve razčlenjevalnikov; pri nedelujočem slikovnem vhodu pa preverjanje, ali je bila slikovna podpora namenoma izključena.
– Stran poleg tehničnih navodil promovira lastni API CometAPI. Njeno primerjavo lokalnega gostovanja in oblaka je zato smiselno razumeti kot tehnično predstavitev s komercialnim namenom: gostovani API zmanjša infrastrukturno delo, lastna postavitev pa omogoča več nadzora nad utežmi in obdelavo podatkov.
Članek za Mac s 16 GB pomnilnika priporoča Qwen 3.5 9B ter poudarja, da sta pri lokalni umetni inteligenci pomembnejša dejansko razpoložljiv pomnilnik in prostor za kontekst kot zgolj velikost modela.
BISTVO
– Po oceni članka Mac s 16 GB pomnilnika za jezikovni model običajno ponuja približno 11 GB, zato kot praktično izbiro izpostavlja modele z 8–12 milijardami parametrov v kvantizaciji Q4_K_M, pri katerih ostane tudi nekaj prostora za kontekst pogovora.
– Qwen 3.5 9B je avtorjeva prva izbira za splošno kakovost, programiranje in sklepanje; Qwen 3 8B ter Llama 3.1 8B sta hitrejši možnosti za vsakodnevno uporabo, Gemma 4 12B pa predstavlja kompromis med večjim modelom in počasnejšim ustvarjanjem odgovorov.
– Osrednje opozorilo je, da uspešno nalaganje modela še ne pomeni tekočega delovanja: večji modeli lahko porabijo skoraj ves razpoložljivi pomnilnik, zato članek za modele razreda 14B, GPT-OSS 20B in zahtevnejše agentske naloge priporoča prehod na 24 GB.
DEJSTVA
– Pomnilniški proračun: članek za jedro in storitve macOS predvideva približno 2–3 GB, za odprte aplikacije še 1–3 GB, za lokalni model pa uporablja okvirno vrednost 11 GB; pri izbiri zato poleg modela upošteva tudi pomnilnik za kontekst in rezultate orodij.
– Razvrstitev modelov: Qwen 3.5 9B zaseda prvo mesto s približno 7 GB in ocenjeno hitrostjo 25 žetonov na sekundo, Qwen 3 8B drugo s približno 6,5 GB in 28 žetoni na sekundo, Gemma 4 12B pa tretje s približno 8 GB in 19 žetoni na sekundo.
– Hitrost in strojna oprema: vse navedene hitrosti so ocene sistema ModelFit za konfiguracijo, ki jo članek označuje kot Mac Mini M6 s 16 GB; za daljše obremenitve na MacBook Air brez ventilatorja avtor navaja približno 10-odstotni upad hitrosti, nadgradnjo na 24 GB pa povezuje z uporabo večjih modelov.
KAJ ČLANEK PRIPOROČA ZA POSAMEZNO UPORABO
– Qwen 3.5 9B: najbolj uravnotežena izbira. Avtor mu pripisuje dobro sklepanje, pomoč pri programiranju ter obdelavo besedila in slik. Ob navedeni velikosti približno 7 GB naj bi znotraj predvidenega proračuna ostalo približno 4 GB za kontekst.
– Qwen 3 8B: odziven model za klepet in vsakodnevno pomoč pri programiranju. Članek kot prednost izpostavlja podporo v okolju Ollama, LM Studio in llama.cpp ter zrelost podpore v izvajalnih okoljih.
– Gemma 4 12B: možnost za uporabnike, ki dajejo prednost kakovosti in delu z dokumenti pred hitrostjo. Avtor ga opisuje kot največji gost model, ki se še udobno prilega predvidenemu pomnilniškemu okviru.
– Ornith 1.0 9B: izbira za agentsko programiranje, pri katerem model uporablja orodja in obdeluje njihove rezultate. Navedena poraba približno 5,6 GB naj bi puščala več prostora za daljše delovne kontekste.
– Llama 3.1 8B: preverjena možnost za uporabnike, ki dajejo prednost širokemu ekosistemu. Članek navaja približno 6,5 GB in ocenjeno hitrost 28 žetonov na sekundo.
– LFM2.5 8B-A1B: najhitrejši model na seznamu, z oceno približno 64 žetonov na sekundo in velikostjo približno 5,5 GB. Avtor ga usmerja predvsem v agentske naloge in klicanje orodij.
PRAKTIČNA PRIPOROČILA IN OMEJITVE
– Za klepet, pisanje in občasno pomoč pri programiranju članek šteje MacBook Air za ustrezno izbiro. Za večurno agentsko delo ali obsežno zaporedno povzemanje dokumentov daje prednost Macu Mini zaradi aktivnega hlajenja in stabilnejše hitrosti pri dolgotrajni obremenitvi.
– Pred nakupom močnejše naprave svetuje zmerno dolžino konteksta in zapiranje nepotrebnih zavihkov ter aplikacij. Namen obeh ukrepov je zmanjšati pritisk na pomnilnik, ne spremeniti same razvrstitve modelov.
– Pri 16 GB odsvetuje goste modele razreda 14B v Q4, GPT-OSS 20B, modele s 27 milijardami parametrov ali več ter višje kvantizacije, kot je Q8 pri modelih razreda 9B. Te omejitve članek predstavlja precej kategorično, ne kot rezultate meritev za vsako posamezno konfiguracijo.
– Pri branju je treba ločiti priporočila od dokazov: hitrosti so izrecno označene kot ocene, stran pa vsebuje tudi partnerske nakupne povezave. Poleg tega je v besedilu manjša notranja neskladnost: Ornith označi kot model z najmanjšo porabo pomnilnika, čeprav tabela za LFM2.5 navaja še nekoliko manjšo velikost.
Naslov članka: »Why Rankings Matter Less in SEO (+What to Track Instead)«. Avtor je Goran Mirković, urednica Stephanie Heitman; zadnja navedena posodobitev je 6. oktober 2026. Članek obravnava predvsem lokalna storitvena podjetja in pojasnjuje, zakaj običajna poročila o organskem prometu ne zajamejo vseh poslovnih učinkov njihove prisotnosti v iskalnikih.
BISTVO
Visoka organska uvrstitev ne zagotavlja več sorazmernega števila klikov, saj Google pred običajnimi rezultati prikazuje odgovore AI Overviews, oglase, lokalni zemljevidni sklop in druge elemente, ki uporabniku omogočajo pridobitev odgovora ali neposreden stik s podjetjem brez obiska njegove spletne strani. Po avtorjevem mnenju zato zmanjšanje prometa samo po sebi še ne pomeni, da optimizacija za iskalnike ne deluje.
Uvrstitve ostajajo pokazatelj relevantnosti vsebine, avtoritete spletnega mesta in možnosti za vidnost, vendar ne povedo, ali je uporabnik rezultat dejansko opazil, si zapomnil blagovno znamko ali postal stranka. Članek predlaga širše vprašanje: na katerih mestih znotraj rezultatov iskanja se podjetje pojavi in ali so to mesta, kjer uporabnik sprejema odločitev o nakupu oziroma naročilu storitve.
Uspešnost SEO naj podjetje spremlja s kombinacijo prikazov v Google Search Console, prisotnosti v različnih elementih rezultatov iskanja, poizvedb z imenom blagovne znamke, stopnje konverzije organskega prometa in dejanj v Google Business Profile. Ti kazalniki skupaj bolje pokažejo pot od prepoznavnosti do povpraševanja; več prikazov ob nespremenjenem številu klikov avtor razume kot možno rast izpostavljenosti znamke, ne kot samodejen neuspeh.
Pri lokalnih storitvah ima Google Business Profile lahko pomembnejšo neposredno vlogo pri pridobivanju strank kot spletni dnevnik ali prva organska uvrstitev, ker uporabnik prek profila preveri ocene, fotografije in storitve ter takoj pokliče podjetje. Članek zato priporoča sprotno vzdrževanje profila, jasne opise ponudbe, aktualne fotografije opravljenega dela in premišljeno odgovarjanje na pozitivne ter negativne ocene.
Vsebinska strategija naj gradi zaupanje in prepoznavnost, ne samo prometa: avtor daje prednost izvirnim, konkretnim in strokovno utemeljenim odgovorom pred površinskimi besedili, pripravljenimi zgolj za ključne besede. Njegov praktični pregled vključuje analizo prikazov, pregled celotne strani rezultatov, preverjanje dejanj v poslovnem profilu, spremljanje iskanj po imenu podjetja, izračun konverzij in oceno prvega vtisa, ki ga ustvari profil.
DEJSTVA
Good Nature Organic Lawn Care je Alec McClennan ustanovil leta 1999 v Clevelandu v Ohiu. Članek navaja, da podjetje po 27 letih oskrbuje tisoče lastnikov stanovanjskih nepremičnin na območjih Cleveland, Akron in Columbus ter ima oceno 4,9 ob skoraj 300 Googlovih ocenah. Primer ponazarja pridobivanje strank prek lokalnih rezultatov brez nujnega obiska spletnega mesta.
Avtor našteje štiri razloge za šibkejšo povezavo med uvrstitvijo in prometom: odgovore AI Overviews, oglase in lokalni zemljevidni sklop, dodatne elemente rezultatov ter iskanje zunaj Googla. Med drugimi platformami izrecno omenja YouTube, Nextdoor, ChatGPT in Perplexity.
Predlagani samostojni pregled naj bi trajal približno 30 minut in ne zahteva plačljivih orodij. V Google Search Console naj podjetje pregleda 15–20 najpomembnejših poizvedb za zadnjih šest mesecev, nato pa ročno preveri rezultate za tri poslovno najvrednejše poizvedbe.
Za dejanja v Google Business Profile članek predlaga pregled zadnjih 90 dni in primerjavo z istim obdobjem prejšnjega leta; za poizvedbe z imenom podjetja predlaga šest- in dvanajstmesečni trend, za organsko stopnjo konverzije pa deljenje števila povpraševanj s številom organskih sej v istem trimesečnem obdobju.
Primer 20-odstotnega zmanjšanja organskih sej ob nespremenjenem številu povpraševanj je ilustracija učinkovitejšega prometa, ne predstavljeni rezultat raziskave. Podjetji Rock Creek Plumbing LLC iz Chehalisa in Black Hills Inc. iz zahodnega Washingtona služita kot dodatna poslovna primera; članek zanju ne podaja podrobnih številčnih dokazov o pripisanih učinkih SEO.
CITATI
»Rankings still matter, but they are no longer the finish line. They are the entry fee.« — Osrednja teza: uvrstitev omogoča sodelovanje v iskanju, poslovni uspeh pa je treba meriti z nadaljnjimi učinki.
»Google hasn’t stopped rewarding good rankings. It’s just built a lot more things between the ranking and the click.« — Avtor izgubo klikov povezuje predvsem s spremenjeno sestavo strani z rezultati iskanja.
»Your organic result can be technically first and still get passed over entirely.« — Prvo mesto med organskimi povezavami ni nujno prvo mesto v uporabnikovi pozornosti.
»The question shifts from “how do we get more traffic” to “are we converting the traffic we have.”« — Članek poudarja izkoristek obstoječih obiskov namesto osredotočenosti izključno na povečevanje njihovega števila.
»The question has shifted from “where do I rank?” to “when someone in my city needs what I do, does my name come up somewhere they trust and act on?”« — Končno merilo je prisotnost podjetja tam, kjer potencialna stranka zaupa informacijam in ukrepa.
Google naj bi pripravljal obsežno posodobitev, usmerjeno proti množično ustvarjenim vsebinam umetne inteligence, lažnim avtorjem in manipuliranju priporočil v iskalnikih z umetno inteligenco.
To je osrednja napoved Lily Ray, ne uradna Googlova napoved; avtorica poudarja, da datum in natančen obseg morebitne posodobitve nista znana.
Avtorica: Lily Ray; objavljeno 4. oktobra 2026. Spodnji povzetek predstavlja njene navedbe, raziskave in interpretacije, ne njihove neodvisne potrditve.
BISTVO
Googlova dokumentacija po avtoričini oceni napoveduje strožji nadzor kakovosti: spremembe smernic o vsebinah umetne inteligence, avtorstvu in uporabnosti strani razume kot opozorilo pred večjim algoritmičnim posegom. Opisuje ponavljajoč se »cikel SEO«: manipulativna tehnika začne delovati, se množično razširi, nato jo iskalnik omeji. Kot zgodovinske primere navaja posodobitve Panda, Penguin, Medic in posodobitev jedrnega algoritma marca 2024.
Glavna nevarnost ni uporaba umetne inteligence sama, temveč množično objavljanje brez dejanske uredniške vrednosti: avtorica izpostavlja stotine ali tisoče podobnih strani, netočne informacije ter vsebine o področjih, na katerih spletno mesto nima lastnih izkušenj. Po njenih izkušnjah niti zatrjevani človeški pregled ni vedno preprečil padca vidnosti, kadar je bil celoten vzorec objavljanja šablonski in neizviren.
Izmišljeno avtorstvo je predstavljeno kot zavajanje: članek povzema novo Googlovo besedilo, ki izrecno omenja umetno ustvarjene portrete, izmišljena imena in lažne kvalifikacije. Pomembna sprememba je po avtoričini razlagi povezava takšnega ravnanja z avtomatiziranimi sistemi za ocenjevanje kakovosti, ne zgolj s smernicami za človeške ocenjevalce.
Nekatere tehnike GEO ponavljajo stare manipulacije SEO: mednje uvršča sezname, na katerih podjetje samo sebe postavi na prvo mesto, kupljene omembe, lažne ocene in avtomatizirane objave na Redditu. GEO v članku pomeni optimizacijo vidnosti v odgovorih generativne umetne inteligence. Avtorica posebej opozarja, da plačane objave s povezavami, ki prenašajo vrednost za razvrščanje, niso nova izjema od pravil o kupljenih povezavah.
Priporočena priprava je manj vsebin z večjo dodano vrednostjo: avtorica svetuje pregled množično ustvarjenih strani, izboljšanje ali združevanje podvojenih vsebin, odpravo izmišljenih avtorjev ter preverjanje dejstev v vseh objavljenih elementih. Pri uporabi umetne inteligence predlaga tudi smiselno razkritje načina nastanka vsebine; tega ne predstavlja kot splošno obveznost. Odstranjevanje slabih vsebin je njeno priporočilo, ne zagotovljen način zaščite pred posodobitvijo.
DEJSTVA
Spremembe smernic v začetku oktobra 2026: članek navaja, da je Google 1. oktobra posodobil navodila za uporabo generativne umetne inteligence. Ročni pregled naj bi izrecno zajemal glavno besedilo, naslove, metaopise, strukturirane podatke in alternativna besedila slik. Pri kakovosti glavne vsebine izpostavlja štiri merila: vloženi trud, izvirnost, nadarjenost oziroma spretnost in točnost.
Štiri posodobitve proti neželeni vsebini v letu 2026: po navedbah članka so potekale 24.–25. marca, 24.–26. junija, 18.–21. avgusta in od 24. septembra. Avtorica jih primerja z eno takšno posodobitvijo v letu 2025. Razmiki med začetki posodobitev so se zmanjšali z 92 na 55 in nato na 37 dni; septembrska ob pisanju članka še ni bila označena kot zaključena.
Raziskava 100 poizvedb o najboljši programski opremi B2B: Lily Ray poroča, da so Googlovi pregledi AI septembra 2026 v primerjavi z junijem citirali 38% manj samopromocijskih seznamov. Podjetje, ki je seznam objavilo, je bilo iz priporočil izpuščeno v 83% primerov, prej v 69%. V 70% primerov je njegov seznam pomagal priporočiti konkurente, ne pa njega samega. Gre za njen vzorec, ne za podatek o vseh poizvedbah.
Zgodovinska primerjava z marcem 2024: avtorica navaja 45-dnevno uvajanje takratne posodobitve jedrnega algoritma in tri nove politike proti zlorabam: zlorabo ugleda spletnega mesta, množično ustvarjanje zlorabnih vsebin ter zlorabo pretečenih domen. Članek povzema tudi Googlovo navedbo o 45-odstotnem zmanjšanju nekakovostnih in neizvirnih rezultatov po tej posodobitvi.
Drugi strokovnjaki in komercialne ponudbe: članek navaja podobna opozorila Glenna Gaba, Marie Haynes in Cyrusa Sheparda, pri čemer je Shepard anketiral več kot 130 strokovnjakov SEO. Kot primere trga plačanih omemb opisuje umestitve za približno 135–250 ameriških dolarjev ter paket petih omemb za 1.500 dolarjev. Ti zneski ponazarjajo ponudbe, ki jih je našla avtorica, ne splošnega cenika.
CITATI
O preverjanju vsebin umetne inteligence: »It is critical to manually factcheck and review all AI-generated content for accuracy and trustworthiness before publishing.« Avtorica besedo »critical« razume kot posebej močno opozorilo, da avtomatizirano objavljanje brez preverjanja ni ustrezno.
O množični proizvodnji brez nadzora: »…using generative AI to produce large amounts of text without manual oversight or curation represents little to no effort.« Poudarek ni zgolj na številu strani, temveč na odsotnosti dejanskega uredniškega dela in izbora vsebin.
O lažnih avtorjih: »Fabricating creator profiles (such as by using AI-generated headshots, made-up names, or false credentials to make content appear as if it was written by human experts) is a form of deception.« Ta navedba neposredno naslavlja ustvarjanje navidezne strokovne verodostojnosti.
O opozorilu Glenna Gaba: »For those still wanting to scale via AI or programmatic content, Google is clearly trying to tell you something.« Članek citat uporablja kot dodatno strokovno interpretacijo signalov, ne kot potrditev konkretne prihajajoče posodobitve.
O negotovosti napovedi: »Nobody outside Google knows when the next big update will land or exactly what it will target, and everything in this article is meant to be an informed opinion based on years of observing these patterns.« To je ključna omejitev celotnega članka: opozorila so podlaga za oceno tveganja, ne dokaz znanega datuma ali obsega prihodnjega posega.
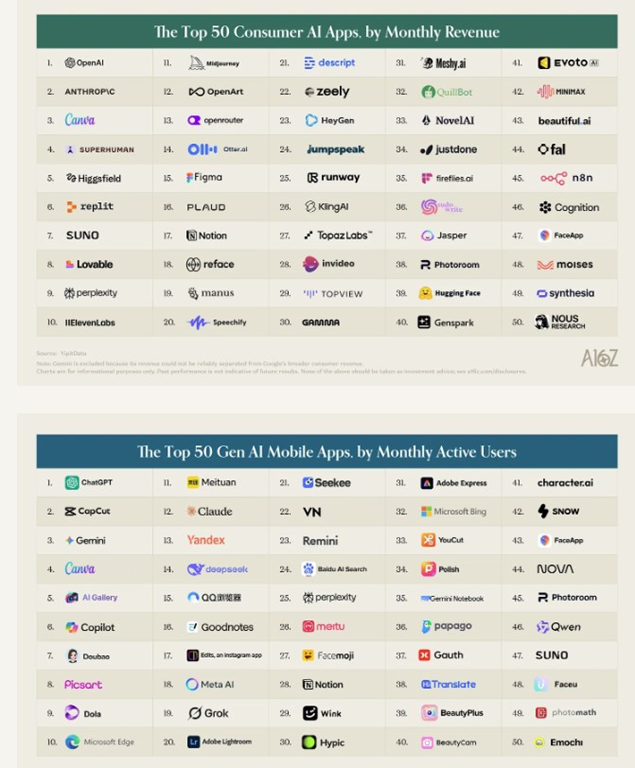
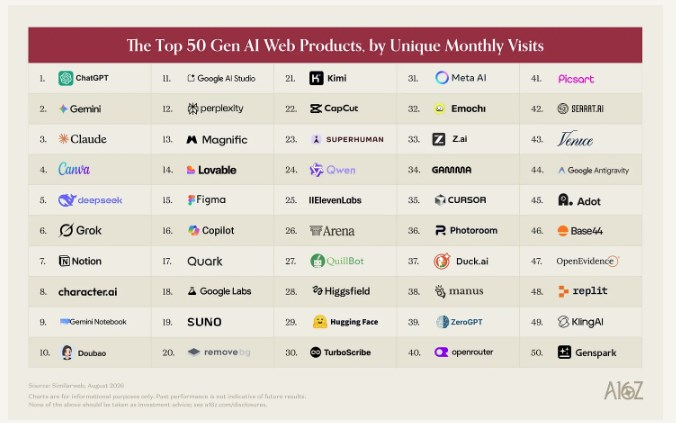
Članek »Top 100 Consumer AI Apps – Seventh Edition« je napisala Olivia Moore in ga objavila pri a16z 5. oktobra 2026; sedma izdaja združuje lestvici spletne in mobilne uporabe ter prvič dodaja lestvico po opaženi potrošniški porabi v ZDA.
Metodologija: Similarweb zagotavlja podatke za 50 spletnih izdelkov po mesečnih obiskih, Sensor Tower za 50 mobilnih aplikacij po mesečno aktivnih uporabnikih, YipitData pa za dodatni pogled na plačevanje; slednji temelji na ameriških vzorcih uporabnikov in ne predstavlja celotnih prihodkov podjetij.
BISTVO
ChatGPT ohranja vodstvo, vendar se vodilni ponudniki vse bolj razlikujejo po ciljnem občinstvu: OpenAI nagovarja splošne uporabnike in podjetja, Anthropic predvsem zahtevnejše uporabnike, ki AI uporabljajo za delo, Google pa izstopa tudi pri ustvarjalnih modelih; avtorica zato poudarja, da tekmovanje ni več samo vprašanje največjega števila uporabnikov, temveč uspešnega razvoja različnih trgov.
Razširjenost AI še ne pomeni globoke ali plačljive uporabe: članek navaja, da AI uporablja skoraj polovica ameriških potrošnikov, dnevno pa približno četrtina, medtem ko največji plačniki kupujejo predvsem orodja za programiranje, avtomatizacijo, produktivnost in ustvarjanje; velik obisk zato sam po sebi ni zanesljiv pokazatelj uspešne monetizacije.
Osebni agenti predstavljajo naslednjo pomembno razvojno smer, ker se vključujejo v sporočila, e-pošto, klice in nakupovanje namesto zgolj odgovarjanja v klepetalnem oknu; članek izpostavlja Instinct, Tomo, Poke, Lindy, Town ter agente večjih ponudnikov, vendar opozarja, da tudi njihovo zgodnjo uporabo še vedno močno zaznamujejo tehnično zahtevnejši uporabniki.
Uveljavljene platforme, kot so Canva, Notion, Figma in nekdanji Grammarly oziroma Superhuman, postajajo pomembni konkurenti, zagonska podjetja pa lahko ohranijo prednost z lastnimi specializiranimi modeli, povezovanjem več modelov, osredotočenostjo na določeno stroko ali drugačno uporabniško izkušnjo; primeri vključujejo Suno in ElevenLabs za ustvarjanje, Cursor za programiranje ter OpenEvidence za zdravnike.
Naročnine in dodatno plačevanje uporabe ostajajo prevladujoči poslovni modeli, vendar po presoji avtorice omejujejo množično uporabo, zato bi oglasi in provizije od transakcij lahko omogočili dostopnejše storitve; to je razvojna teza članka, ne zagotovljen izid, saj osebni agenti Instinct in Muse po navedbah besedila načrtovane transakcijske monetizacije še ne izvajajo.
DEJSTVA
Obseg in sestava lestvic: sedma izdaja ima le 11 prvič uvrščenih izdelkov, najmanj doslej; 29 od 50 ponudnikov z največjo opaženo potrošniško porabo ni na nobeni od obeh lestvic uporabe, na vseh treh pa se pojavlja sedem izdelkov — ChatGPT, Claude, Suno, Perplexity, Photoroom, Canva in Notion — pri čemer ChatGPT vodi na vseh treh; izdelki, namenjeni predvsem vsebinam NSFW, so od te izdaje izključeni, kar ne pomeni ugotovljenega zmanjšanja povpraševanja.
Prednost ChatGPT: po podatkih članka ima avgusta približno dvakrat toliko spletnih obiskov kot Gemini in šestkrat toliko kot Claude, na mobilnih napravah pa približno 2,5-krat toliko mesečno aktivnih uporabnikov kot Gemini in 14-krat toliko kot Claude; ameriški vzorec YipitData obenem kaže približno trikrat toliko plačljivih naročnikov kot pri katerem koli od teh dveh tekmecev, medtem ko je Claude po prometu prehitel DeepSeek in Perplexity.
Koncentracija plačevanja: avgusta 2026 je imelo 4,5% upravičenih potrošnikov v ameriškem vzorcu elektronskih računov YipitData aktivno osebno naročnino na vsaj enega od izdelkov ChatGPT, Gemini ali Claude, v primerjavi z 2,1% leto prej; zgornji 1% plačnikov je ustvaril 19,5% opažene porabe in povprečno porabil 903 USD mesečno, spodnja polovica pa skupaj 16,6%, medtem ko je mediana mesečne porabe znašala 25 USD.
Osebni agenti: članek poroča, da je Instinct v treh tednih presegel 100.000 uporabnikov, njegov ustanovitelj Noah Shinn pa trdi, da uporabniki po prvem nakupu prek storitve povprečno opravijo za 1.300 USD mesečnih nakupov; za Metin Muse, predstavljen 9. septembra, članek navaja 250.000 dnevno aktivnih uporabnikov v prvem tednu in več kot pet milijonov prenosov v manj kot mesecu, pri čemer gre pri nakupih za obseg transakcij, ne za prihodke ponudnika.
Monetizacija in specializirana orodja: med 44 izdelki na spletni lestvici, zasnovanimi okoli AI, jih 84% ponuja naročnine, 64% zaračunava uporabo oziroma dodatne kredite, 14% uporablja oglase in 2% transakcijske ali platformne provizije, pri čemer se kategorije prekrivajo; Suno je 19. po spletnih obiskih in 7. po porabi, ElevenLabs pa 25. in 10., kar ponazarja, zakaj specializirani ustvarjalni izdelki lahko monetizirajo bolje, kot nakazuje njihov obisk.
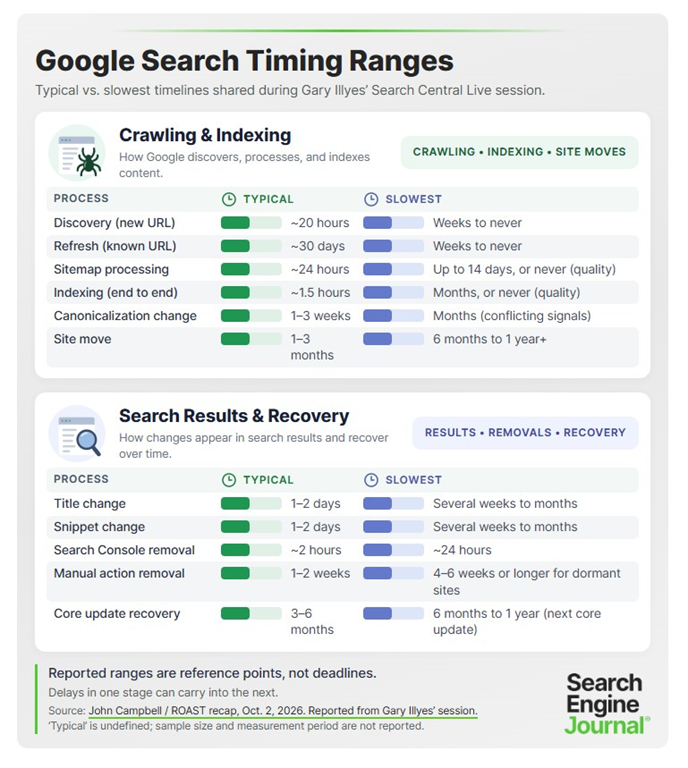
Google spremembe spletnih strani obdeluje v razponu od nekaj ur do več mesecev, vendar navedeni časi niso zagotovljeni roki. Članek poudarja, da se zamude pri odkrivanju in pregledovanju strani prenesejo na indeksiranje ter prikaz sprememb v rezultatih iskanja.
Google nima enotnega časa za obdelavo sprememb: odkrivanje novega spletnega naslova, ponovno pregledovanje znane strani, indeksiranje, sprememba kanoničnega naslova in selitev spletnega mesta so različni procesi z različnimi časovnimi razponi, zato hitrost ene faze ne zagotavlja hitrosti naslednje.
Procesi so medsebojno povezani: Google mora stran najprej pregledati, preden jo lahko indeksira, zato se zamuda pri pregledovanju prenese tudi na poznejše korake; navedbe približno 1,5 ure za indeksiranje zato ni smiselno razumeti kot obljubo, da bo vsaka nova stran vidna v iskalniku toliko časa po objavi.
Selitev spletnega mesta in okrevanje po osrednji posodobitvi algoritma praviloma zahtevata mesece: članek za selitev navaja običajen razpon od enega do treh mesecev, za okrevanje pa od treh do šestih mesecev, pri čemer se lahko počasnejši primeri približajo letu ali ga presežejo
Čakanje samo po sebi ne zagotavlja uspeha: pri nekaterih procesih je med najpočasnejšimi izidi navedeno tudi »nikoli«, pri obdelavi zemljevida spletnega mesta, indeksiranju in posodobitvah strukturiranih podatkov pa je ta možnost povezana s kakovostjo, zato odsotnost rezultata ni nujno zgolj običajna zamuda.
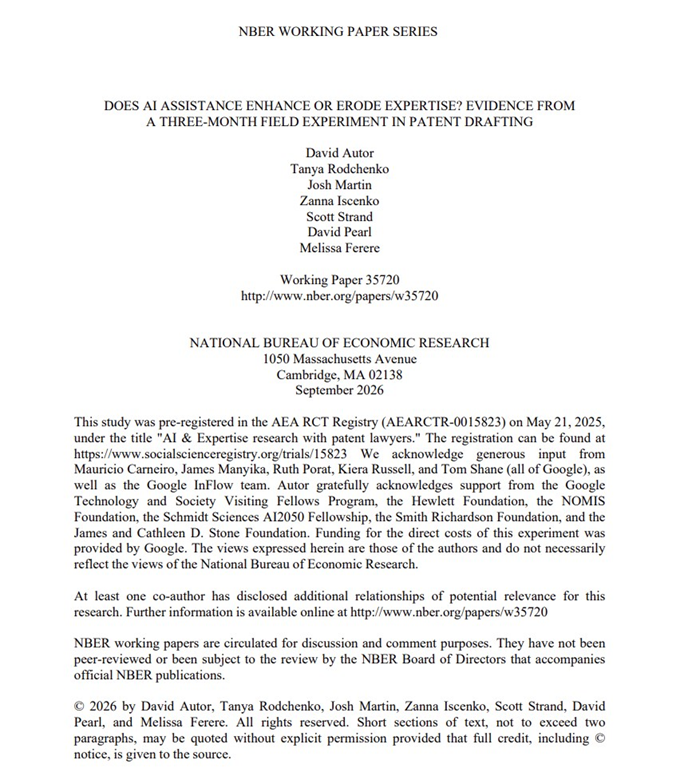
https://www.nber.org/papers/w35720 — kanonična stran raziskave Does AI Assistance Enhance or Erode Expertise? Evidence from a Three-Month Field Experiment in Patent Drafting, delovni zvezek NBER št. 35720, objavljen septembra 2026. Odprta spletna stran vsebuje celotno raziskavo v obliki PDF.
BISTVO
Raziskava ločuje izboljšanje izdelka od izboljšanja posameznikovega znanja: pravniki so najprej pripravljali patentne osnutke z dovoljeno uporabo AI v eksperimentalni skupini, po treh mesecih pa so vsi opravili pregled in popravljanje obstoječega osnutka brez AI; tako so avtorji preverili, ali boljši rezultati ob uporabi orodja pomenijo tudi boljšo samostojno strokovno presojo.
Dostop do AI je izboljšal kakovost patentnih osnutkov pri obeh preverjanjih, pri čemer so manj izkušeni pravniki dosegli večje ocenjene koristi kot izkušenejši; izboljšave so zajemale pravno uveljavljivost, tehnično pravilnost, strateško širino formulacij, popolnost in jasnost, vendar razlika v velikosti učinkov med izkušenostnima skupinama ni bila statistično zanesljivo potrjena
Prenos koristi na delo brez AI je bil izrazito drugačen: izkušeni pravniki, ki so tri mesece uporabljali pomočnika, so pri samostojnem popravljanju patentne prijave presegli primerljivo kontrolno skupino, manj izkušeni pa v povprečju niso napredovali; pri slednjih se je povečala razpršenost ocen, z več slabimi in več dobrimi rezultati ter manj podpovprečnimi rezultati.
Kvalitativna analiza nakazuje razliko v načinu dela: uspešnejši izkušeni pravniki so odpravljali večje pravne in strukturne pomanjkljivosti ter utemeljevali spremembe, manj izkušeni pa so pogosto popravljali slog ali prepoznali napako, ne da bi jo dejansko odpravili; ker se je takšno ravnanje pojavljalo tudi v kontrolni skupini, raziskava ne dokazuje, da ga je povzročila AI
Osrednja ugotovitev ni, da AI na splošno zmanjšuje strokovnost, temveč da boljši rezultati z AI niso zanesljiv dokaz učenja: obstoječe znanje lahko pomaga pri pridobivanju trajnejših koristi, vendar ostaja ta razlaga previdna zaradi majhnega in specializiranega vzorca, trimesečnega spremljanja, odsotnosti začetnega praktičnega preizkusa znanja ter nepopolnega nadzora nad uporabo AI pri zaključnem preverjanju.
DEJSTVA
Raziskavo so podpisali David Autor z MIT in NBER ter Tanya Rodchenko, Josh Martin, Zanna Iscenko, Scott Strand, David Pearl in Melissa Ferere iz Googla; predregistrirali so jo 21. maja 2025 pod oznako AEARCTR-0015823, neposredne stroške poskusa pa je financiral Google, pri čemer dokument izrecno opozarja, da gre za delovni zvezek brez znanstvene recenzije.
V poskus so naključno razporedili 133 pravnikov iz 11 ameriških odvetniških družb: 90 jih je dobilo dostop do pomočnika InFlow podjetja Google Labs, 43 pa je bilo v kontrolni skupini; prvo nalogo je dokončalo 105 sodelujočih, drugo nalogo priprave osnutka 98, zaključni pregled brez AI pa 91, pri čemer so bili »manj izkušeni« opredeljeni z manj kot sedmimi leti prakse in »izkušeni« z najmanj sedmimi leti.
Pri zaključnem pregledu brez AI je skupni učinek znašal 0,32 standardnega odklona (p=0,04p=0,04p=0,04), pri izkušenih 0,45 (p=0,02p=0,02p=0,02), pri manj izkušenih pa −0,03 (p=0,89p=0,89p=0,89); slednja ocena ne dokazuje povprečnega poslabšanja, vendar se je pri manj izkušenih verjetnost ocen v najslabši petini povečala za 22 odstotnih točk, delež ocen v drugi najslabši petini pa zmanjšal za 42 odstotnih točk.
Pri prvem pisanju osnutka je skupina z AI prihranila približno 10 minut glede na kontrolno izhodišče 112 minut, predvsem zaradi prihrankov manj izkušenih pravnikov; avtorji so pri zaključnem pregledu označili tudi 15 od 91 izdelkov kot potencialno neskladnih s prepovedjo AI, po njihovi izključitvi pa je učinek pri izkušenih ostal pozitiven, vendar manj zanesljiv: 0,39 standardnega odklona (p=0,06p=0,06p=0,06), medtem ko skupni učinek ni več dosegal običajnega petodstotnega praga statistične značilnosti.
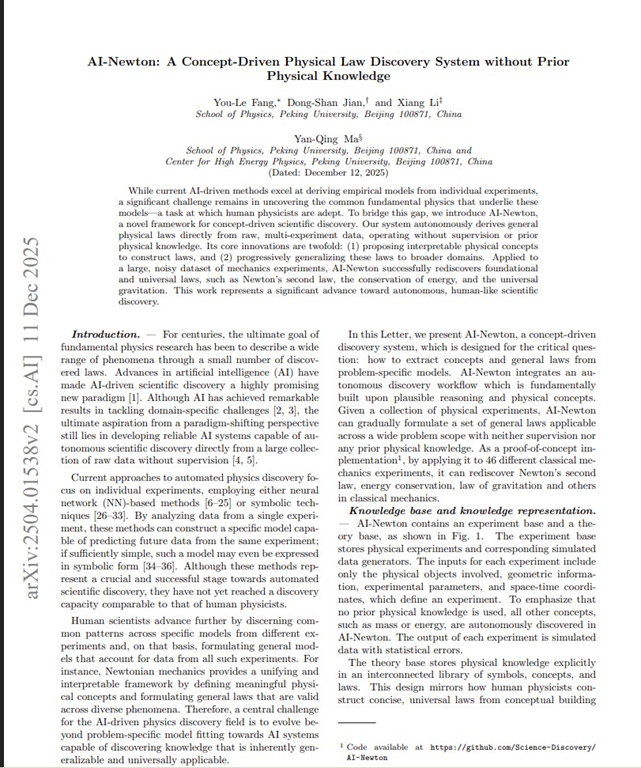
Znanstveni napredek je bil stoletja odvisen od sposobnosti posameznikov, da so v množici opažanj prepoznali zakonitosti, oblikovali nove pojme in z njimi pojasnili delovanje sveta. Med opazovanjem gibanja teles in nastankom splošne teorije mehanike so morale dozoreti ideje o masi, sili in energiji. Umetna inteligenca zdaj posega tudi v ta ustvarjalni del znanosti. Sistem AI-Newton je iz podatkov o gibanju teles samostojno oblikoval fizikalne pojme in ponovno odkril temeljne Netonove zakone klasične mehanike. V približno dveh dneh računalniškega izvajanja je rekonstruiral pomemben del znanja, ki je nastajalo skozi stoletja razvoja fizike. Grobo rečeno – AI-Newton je v dveh dneh dela (na še starih UI modelih iz konca 2025) nadomestil 300 let človeškega razvoja fizike.
Članek kitajskih raziskovalcev iz oddelka za fiziko na Pekinški univerzi z naslovom »AI-Newton: A Concept-Driven Physical Law Discovery System without Prior Physical Knowledge« predstavlja pristop k avtomatiziranemu znanstvenemu odkrivanju, katerega bistvo je samostojno oblikovanje pojmov in splošnih zakonov iz eksperimentalnih podatkov. Avtorji You-Le Fang, Dong-Shan Jian, Xiang Li in Yan-Qing Ma obravnavajo eno ključnih vprašanj uporabe umetne inteligence v znanosti: kako iz množice posameznih rezultatov priti do skupne razlage, ki velja za različne pojave. Njihov sistem poskuša avtomatizirati prav tisto sposobnost, ki je omogočila velike znanstvene preboje: povezovanje navidezno ločenih opažanj v enotno teorijo.