Članek »AI Agent Benchmarks Explained: SWE-Bench, GAIA, WebArena, and More« je napisal Vinod Chugani; objavljen je bil 12. oktobra 2026 na portalu Machine Learning Mastery.
BISTVO
Primerjalni preizkusi agentov ocenjujejo večstopenjsko opravljanje nalog z uporabo orodij in interakcijo z okoljem, medtem ko tradicionalni preizkusi modelov praviloma preverjajo pravilnost posameznega odgovora.
SWE-bench, GAIA, WebArena in OSWorld preverjajo različne sposobnosti, zato visoka uspešnost na enem področju ne zagotavlja splošne uporabnosti ali zanesljivega delovanja v produkciji.
Avtor priporoča uporabo javnih rezultatov za začetni izbor kandidatov, končno odločitev pa naj določijo interni preizkusi na lastnih delovnih postopkih, ki vključujejo stroške, hitrost, varnost in obvladovanje napak.
DEJSTVA
Članek obravnava štiri glavna področja preverjanja agentov:
SWE-bench in SWE-bench Verified: odpravljanje programskih napak v resničnih projektih.
GAIA: raziskovanje in sklepanje z več orodji ter različnimi vrstami podatkov.
WebArena z ogrodjem BrowserGym: izvajanje nalog v spletnih aplikacijah.
OSWorld: uporaba namiznega operacijskega sistema in sodelovanje med aplikacijami.
Primerjava 80-odstotne in 70-odstotne uspešnosti na SWE-bench je ponazoritveni primer, ne rezultat konkretnih imenovanih agentov: uspešnejši sistem lahko porabi bistveno več računskih virov, žetonov in klicev API.
Tudi primerjava med 30 sekundami in 20 minutami za izvedbo naloge je ilustrativna; članek ne objavlja lastnih meritev, temveč opozarja, da sam odstotek uspešnosti ne pokaže časovne in stroškovne učinkovitosti.
Kaj posamezni preizkus dejansko pove
SWE-bench:
Agent dobi prijavljeno težavo iz repozitorija na GitHubu, denimo iz projektov Django ali scikit-learn, in pripravi popravek kode.
Uspeh se ocenjuje s testi. Različica Verified vsebuje človeško pregledano podmnožico nalog, kar zmanjšuje težave zaradi nejasnih zahtev ali neustreznih testov.
Omejitev: uspešno prestani testi sami po sebi ne zagotavljajo varnosti, vzdržljivosti ali splošne kakovosti kode.
GAIA:
Preverja, ali agent zna povezati spletno iskanje, pregled dokumentov, obdelavo datotek, izračune in večstopenjsko sklepanje.
Ključno je usklajevanje teh korakov brez izgube prvotnega cilja.
Omejitev: naloge navadno predvidevajo en pravilen odgovor, resnične zahteve uporabnikov pa so pogosto dvoumne, odvisne od konteksta in spremenljive.
WebArena in BrowserGym:
WebArena uporablja izolirane različice spletnih trgovin, sistemov za upravljanje vsebin, forumov in drugih aplikacij; agent mora uporabljati obrazce, gumbe in navigacijo.
BrowserGym je modularno ogrodje za vključevanje različnih spletnih okolij in načinov ocenjevanja.
Omejitev: avtor opozarja na možnost, da so javne naloge že vključene v učne podatke modelov, zato dober rezultat lahko deloma odraža poznavanje nalog namesto posploševanja.
OSWorld:
Agent upravlja datoteke, uporablja grafične aplikacije, spreminja sistemske nastavitve in izvaja postopke prek več programov.
Omejitev: na rezultat vpliva tudi stabilnost preizkusnega okolja; sesutje aplikacije ali napačen prikaz lahko povzroči neuspeh neodvisno od kakovosti agentovega sklepanja.
Kaj lestvice izpustijo in kako rezultate uporabiti
Članek izpostavlja pet pogosto premalo zajetih vidikov: stroške, odzivni čas, spoštovanje varnostnih omejitev, okrevanje po napakah ter nezanesljivost avtomatiziranega ocenjevanja. Pri zadnjem lahko drug jezikovni model prepričljiv, vendar napačen odgovor oceni previsoko.
Praktičen pristop je dvostopenjski: najprej izbrati obetavne agente s primerjalnimi preizkusi za ustrezno področje, nato jih preveriti na reprezentativnih lastnih nalogah. Agent za povzemanje pogodb naj se na primer ocenjuje na pogodbah, podobnih tistim, ki jih bo dejansko obdeloval.
CITATI
»A traditional benchmark is a written exam. An agent benchmark is a live work simulation.« — Osrednja razlika je med ustvarjanjem odgovora in uspešno izvedbo zaporedja dejanj v okolju.
»Leaderboards show success rates, not bills.« — Odstotek uspešno opravljenih nalog ne razkriva njihove dejanske cene.
»Use the leaderboards to start the conversation. Build your own evaluations to finish it.« — Javni preizkusi so začetna orientacija, ne nadomestilo za preverjanje uporabnosti v lastnem okolju.
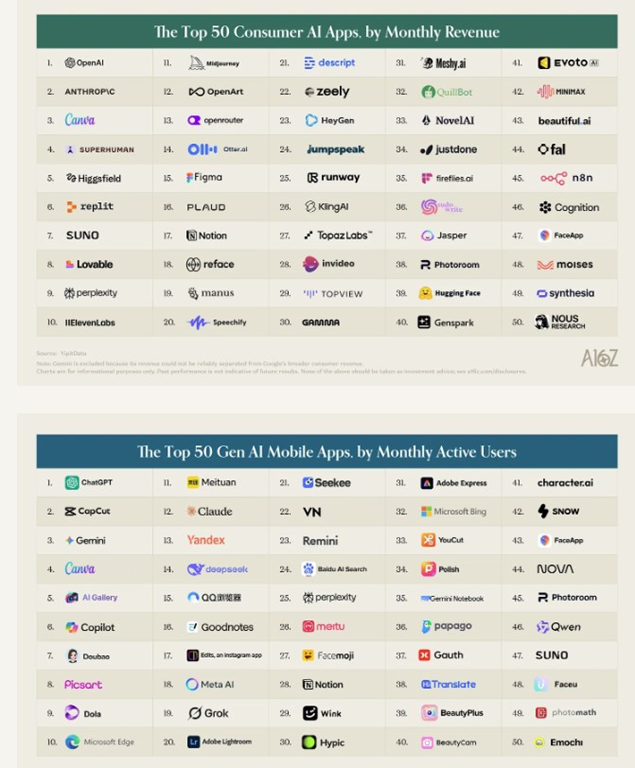
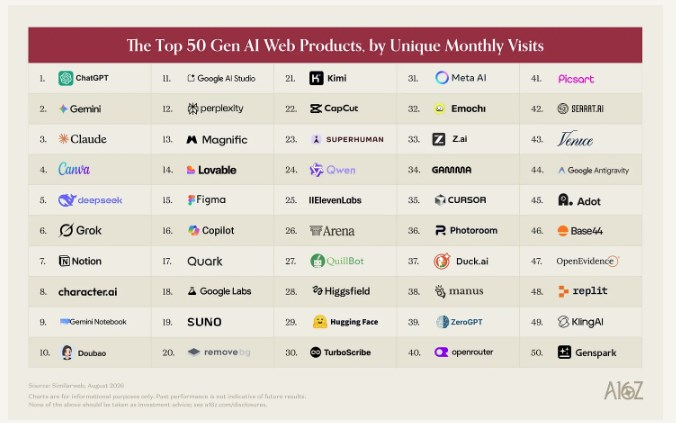
Članek »Top 100 Consumer AI Apps – Seventh Edition« je napisala Olivia Moore in ga objavila pri a16z 5. oktobra 2026; sedma izdaja združuje lestvici spletne in mobilne uporabe ter prvič dodaja lestvico po opaženi potrošniški porabi v ZDA.
Metodologija: Similarweb zagotavlja podatke za 50 spletnih izdelkov po mesečnih obiskih, Sensor Tower za 50 mobilnih aplikacij po mesečno aktivnih uporabnikih, YipitData pa za dodatni pogled na plačevanje; slednji temelji na ameriških vzorcih uporabnikov in ne predstavlja celotnih prihodkov podjetij.
BISTVO
ChatGPT ohranja vodstvo, vendar se vodilni ponudniki vse bolj razlikujejo po ciljnem občinstvu: OpenAI nagovarja splošne uporabnike in podjetja, Anthropic predvsem zahtevnejše uporabnike, ki AI uporabljajo za delo, Google pa izstopa tudi pri ustvarjalnih modelih; avtorica zato poudarja, da tekmovanje ni več samo vprašanje največjega števila uporabnikov, temveč uspešnega razvoja različnih trgov.
Razširjenost AI še ne pomeni globoke ali plačljive uporabe: članek navaja, da AI uporablja skoraj polovica ameriških potrošnikov, dnevno pa približno četrtina, medtem ko največji plačniki kupujejo predvsem orodja za programiranje, avtomatizacijo, produktivnost in ustvarjanje; velik obisk zato sam po sebi ni zanesljiv pokazatelj uspešne monetizacije.
Osebni agenti predstavljajo naslednjo pomembno razvojno smer, ker se vključujejo v sporočila, e-pošto, klice in nakupovanje namesto zgolj odgovarjanja v klepetalnem oknu; članek izpostavlja Instinct, Tomo, Poke, Lindy, Town ter agente večjih ponudnikov, vendar opozarja, da tudi njihovo zgodnjo uporabo še vedno močno zaznamujejo tehnično zahtevnejši uporabniki.
Uveljavljene platforme, kot so Canva, Notion, Figma in nekdanji Grammarly oziroma Superhuman, postajajo pomembni konkurenti, zagonska podjetja pa lahko ohranijo prednost z lastnimi specializiranimi modeli, povezovanjem več modelov, osredotočenostjo na določeno stroko ali drugačno uporabniško izkušnjo; primeri vključujejo Suno in ElevenLabs za ustvarjanje, Cursor za programiranje ter OpenEvidence za zdravnike.
Naročnine in dodatno plačevanje uporabe ostajajo prevladujoči poslovni modeli, vendar po presoji avtorice omejujejo množično uporabo, zato bi oglasi in provizije od transakcij lahko omogočili dostopnejše storitve; to je razvojna teza članka, ne zagotovljen izid, saj osebni agenti Instinct in Muse po navedbah besedila načrtovane transakcijske monetizacije še ne izvajajo.
DEJSTVA
Obseg in sestava lestvic: sedma izdaja ima le 11 prvič uvrščenih izdelkov, najmanj doslej; 29 od 50 ponudnikov z največjo opaženo potrošniško porabo ni na nobeni od obeh lestvic uporabe, na vseh treh pa se pojavlja sedem izdelkov — ChatGPT, Claude, Suno, Perplexity, Photoroom, Canva in Notion — pri čemer ChatGPT vodi na vseh treh; izdelki, namenjeni predvsem vsebinam NSFW, so od te izdaje izključeni, kar ne pomeni ugotovljenega zmanjšanja povpraševanja.
Prednost ChatGPT: po podatkih članka ima avgusta približno dvakrat toliko spletnih obiskov kot Gemini in šestkrat toliko kot Claude, na mobilnih napravah pa približno 2,5-krat toliko mesečno aktivnih uporabnikov kot Gemini in 14-krat toliko kot Claude; ameriški vzorec YipitData obenem kaže približno trikrat toliko plačljivih naročnikov kot pri katerem koli od teh dveh tekmecev, medtem ko je Claude po prometu prehitel DeepSeek in Perplexity.
Koncentracija plačevanja: avgusta 2026 je imelo 4,5% upravičenih potrošnikov v ameriškem vzorcu elektronskih računov YipitData aktivno osebno naročnino na vsaj enega od izdelkov ChatGPT, Gemini ali Claude, v primerjavi z 2,1% leto prej; zgornji 1% plačnikov je ustvaril 19,5% opažene porabe in povprečno porabil 903 USD mesečno, spodnja polovica pa skupaj 16,6%, medtem ko je mediana mesečne porabe znašala 25 USD.
Osebni agenti: članek poroča, da je Instinct v treh tednih presegel 100.000 uporabnikov, njegov ustanovitelj Noah Shinn pa trdi, da uporabniki po prvem nakupu prek storitve povprečno opravijo za 1.300 USD mesečnih nakupov; za Metin Muse, predstavljen 9. septembra, članek navaja 250.000 dnevno aktivnih uporabnikov v prvem tednu in več kot pet milijonov prenosov v manj kot mesecu, pri čemer gre pri nakupih za obseg transakcij, ne za prihodke ponudnika.
Monetizacija in specializirana orodja: med 44 izdelki na spletni lestvici, zasnovanimi okoli AI, jih 84% ponuja naročnine, 64% zaračunava uporabo oziroma dodatne kredite, 14% uporablja oglase in 2% transakcijske ali platformne provizije, pri čemer se kategorije prekrivajo; Suno je 19. po spletnih obiskih in 7. po porabi, ElevenLabs pa 25. in 10., kar ponazarja, zakaj specializirani ustvarjalni izdelki lahko monetizirajo bolje, kot nakazuje njihov obisk.
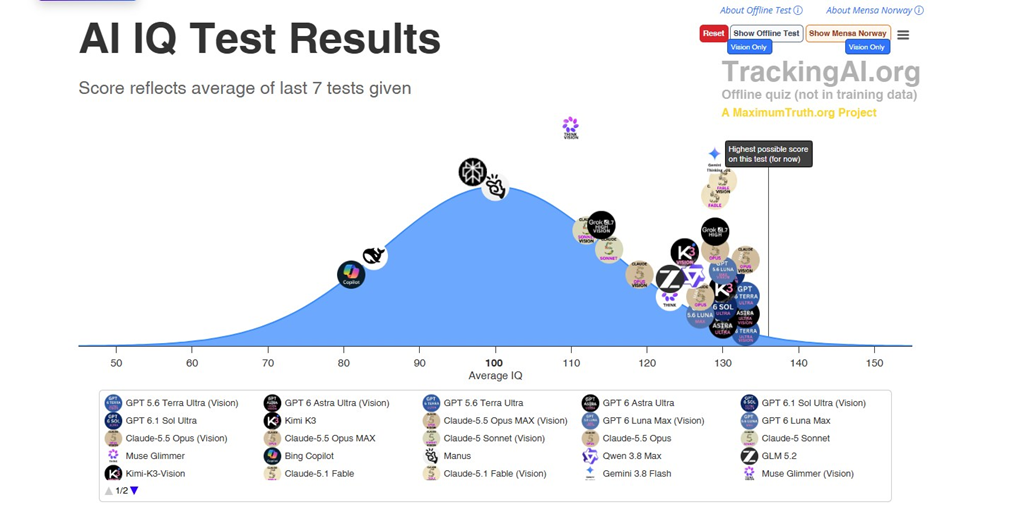
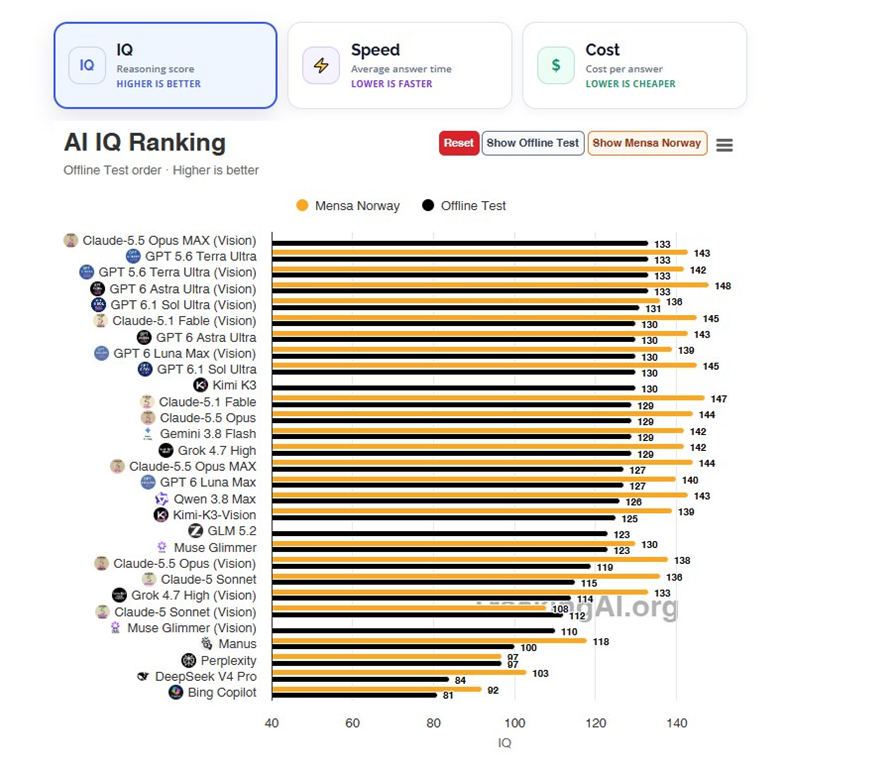
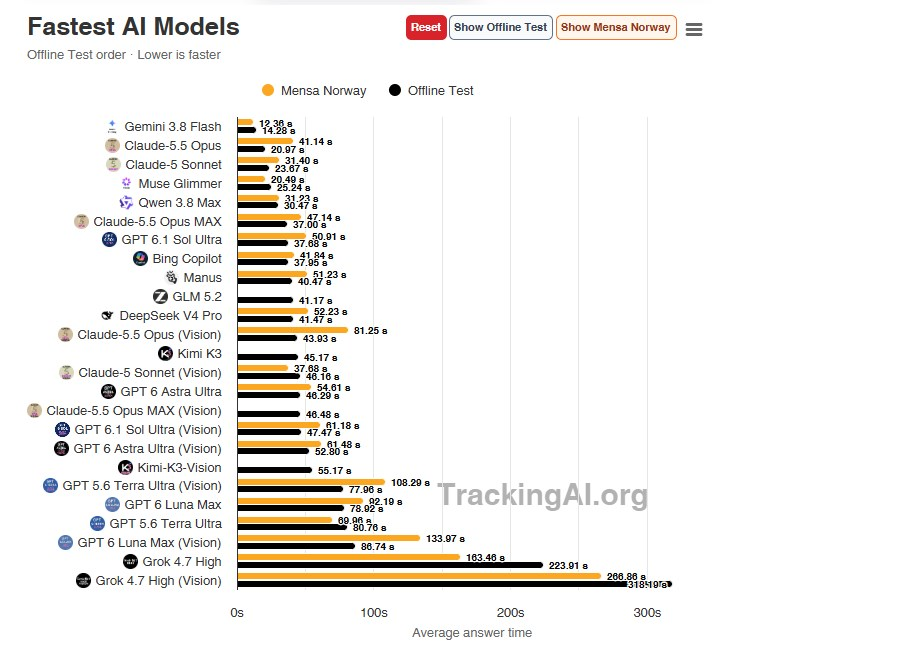
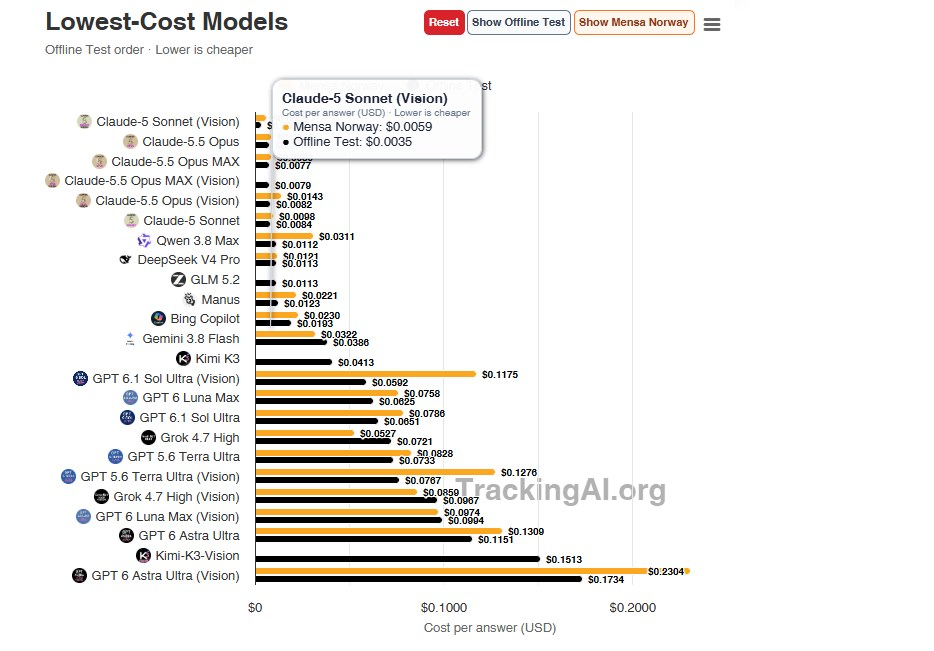
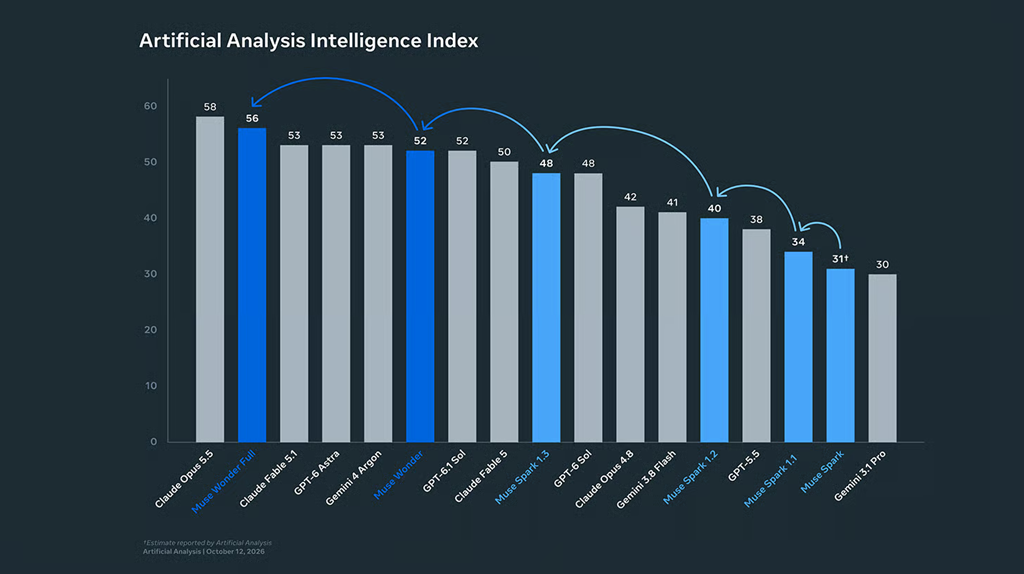
Danes povprečen uporabnik v 90% za svoje potrebe uporablja napačen LMM oziroma napačno (ali pa vsaj ne optimizirano) “umetno inteligenco”. Ker je danes na voljo na stotine modelov, je vse težje racionalno izbrati med ponudbo LMM.
Seveda lahko vedno uporabite večnamenski LLM (kot je ChatGPT), za katerikoli namen in bo solidno opravil svoje delo. Toda določeni modeli se odlikujejo na različnih področjih. Zato je za optimalne rezultate pametno uporabiti različne modele za različne naloge. Trenutno predlagam uporabo naslednjih LLM :
1️⃣ChatGPT: univerzalen model za vse, vaš univerzalen pomočnik, soliden na vseh področjih (za preproste rutinske naloge Luna, za kompleksnejše Sol in za najtežje Astra.)