Oct 1, 2026 | RAG & SLM
RAG ureja, kaj mora model vedeti, prilagajanje modela pa, kako se mora model obnašati, in obravnavanje tega kot izključne izbire je najbolj zanesljiv način, da mesece zapravljate za izdelavo napačne stvari na začetku. Začnite z iskanjem, saj je to skoraj vedno hitrejša pot do nečesa resničnega, dodajte prilagajanje modela le tam, kjer lahko jasno navedete specifičen, trajen problem obnašanja, ki ga boljše usmerjanje in boljše iskanje nista odpravila, in pričakujte – že na začetku – da je pošten odgovor za resen proizvodni sistem verjetno oboje.
vir: https://machinelearningmastery.com/rag-vs-fine-tuning-for-domain-adaptation-when-to-use-which/
Kaj RAG pravzaprav je (in kaj ni)
Retrieval-augmented generation (generiranje s pomočjo iskanja) ne spreminja modela prav nič. Teže modela se nikoli ne spremenijo; spremenjeno je tisto, kar model vidi v svojem kontekstnem oknu v trenutku, ko mu postavimo vprašanje. Korak iskanja pregleda podatkovno bazo, poišče najbolj relevantne dokumente in jih predloži modelu skupaj z uporabnikovim vprašanjem, tako da model odgovarja z informacijami iz teh dokumentov pred seboj namesto zgolj po spominu.
Ta mehanizem je tisti, ki RAG dejansko odlikuje pri točno eni vrsti problema: informacije, ki so velike, ki se spreminjajo, ali oboje. Kar RAG ne popravi, je osnovno vedenje modela. Če je ton modela nekonsistenten, če ne sledi dosledno strogi obliki izhoda, če napačno uporablja žargon vaše industrije mu več dokumentov med izvajanjem ne bo pomagalo, saj problem nikoli ni bilo pomanjkanje informacij.
Kaj fine-tuning dejansko je (in kaj ni)
Fine-tuning počne ravno nasprotno: spremeni sam model, tako da trenira uteži na resničnih primerih vhodno/izhodnega vedenja, ki ga želite, dokler to vedenje ne postane privzeto za model, brez potrebe po dodatkih ob inferenčnem času, saj je vzorec zdaj vgrajen. LoRA in QLoRA sta standardni pristop pri večini projektov, kjer se trenira majhen adapter — pogosto manj kot 1 % celotnih parametrov osnovnega modela — namesto celotnega modela, kar zmanjša stroške fine-tuninga na nekaj sto dolarjev in nekaj ur, namesto celotnega projekta predelave.
Tukaj je pomembna točka, ki jo je vredno jasno poudariti, saj gre za najpogostejšo zmoto v celotni tej razpravi, na katero se več neodvisnih virov strinja z enako formulacijo: fine-tuning zanesljivo ne dodaja dejanskih znanj. Model, fine-tunan na kopici medicinske literature, ne “pozna” dejstev iz te literature na način, kot jo pozna sistem za iskanje informacij — prilagodi stil, strukturo in prepoznavanje vzorcev, vendar je zanesljivost pri priklicu dejstev iz trening podatkov vprašljiva, zlasti pri podrobnih dejstvih. Fine-tuning je orodje za vedenje, ne pa orodje za znanje. Ta razlika je ključna, saj jo prav dokažeta spodnja dva primera, ne le trdita.
Kdaj uporabiti kaj
-
Ali se informacije, ki jih vaš model potrebuje, redno spreminjajo ali so prevelike, da bi bile vključene v poziv — podatki o izdelkih, trenutne politike, naraščajoči nabor dokumentov? Uporabite RAG.
- Ali potrebujete, da je vsak odgovor sledljiv do določenega vira zaradi skladnosti ali revizijskih razlogov? Uporabite RAG, saj je mogoče vsak trditev v odgovoru RAG povezati s specifičnim pridobljenim delčkom, kar številni regulativni okviri o razložljivih izhodih AI obravnavajo kot resnično, pomembno prednost pred izhodi modeli s fino nastavitvijo, ki zahtevajo ločene evalvacijske dokaze za prikaz iste stvari.
- Ali še nimate označenih učnih primerov ali potrebujete nekaj, kar teče ta teden namesto naslednji mesec? Uporabite RAG — skoraj vedno je hitrejša pot do delujoče prve različice, ne glede na to, kaj boste kasneje dodali.
- Ali mora model dosledno slediti tonu, strukturi ali besedišču, kar pozivanje na velikem obsegu ne uspeva zagotoviti? Fino nastavite.
- Je vaš čas zakasnitve dovolj omejen, da je dodatni korak pridobivanja informacij pred vsakim odgovorom resničen strošek? Fino nastavite, saj fino nastavljeni model odgovarja neposredno brez vključenega koraka pridobivanja.
- Je vaš volumen poizvedb dovolj velik, da bi bil manjši, fino nastavljen odprtokodni model dramatično cenejši na poizvedbo kot klic mejnika API? Fino nastavite — prihranek na poizvedbo lahko hitreje povrne stroške priprave podatkov, kot večina ekip pričakuje, ko je volumen resnično velik.
Sep 30, 2026 | LLM (AI)
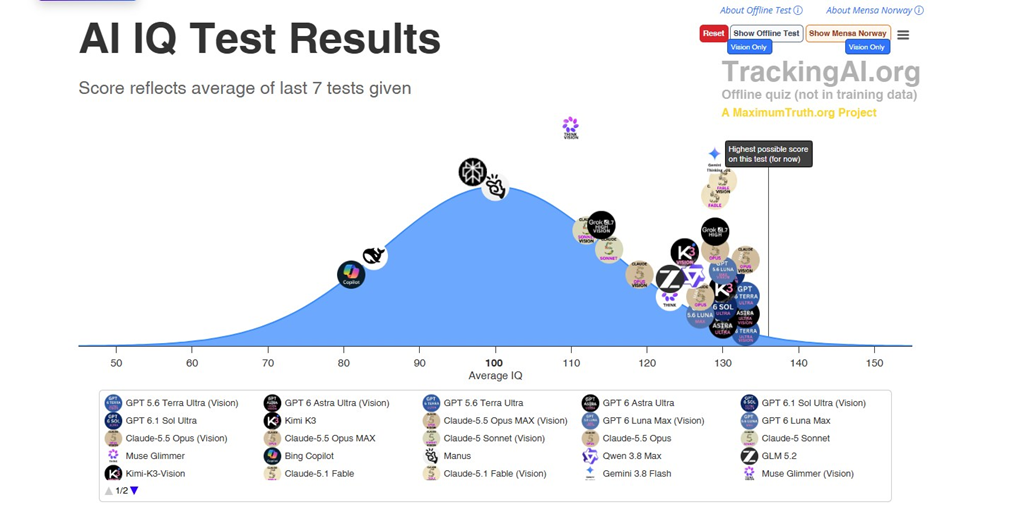
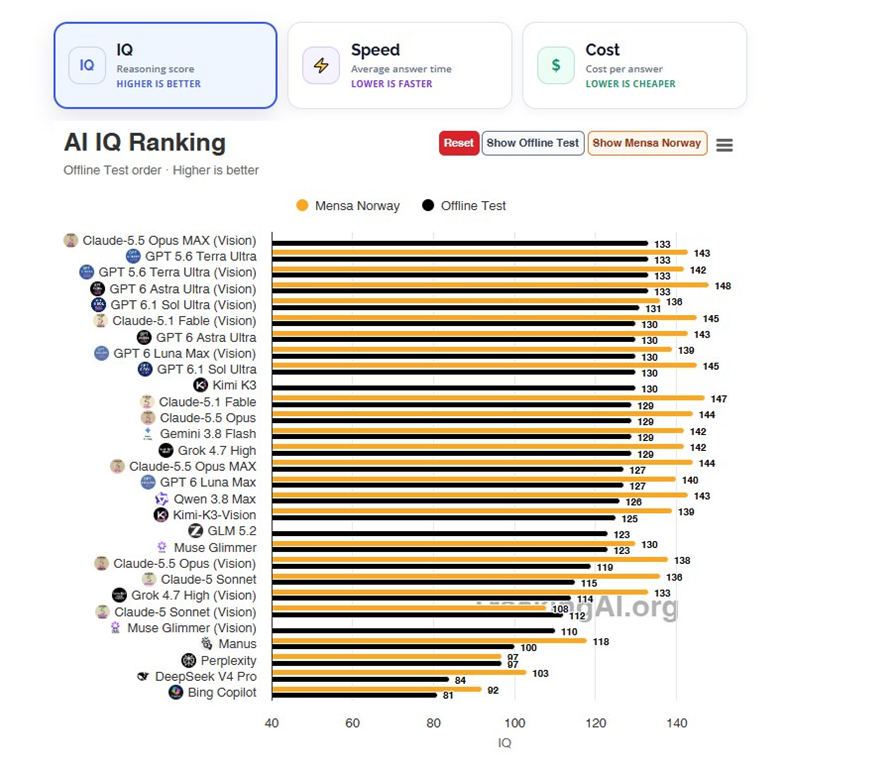
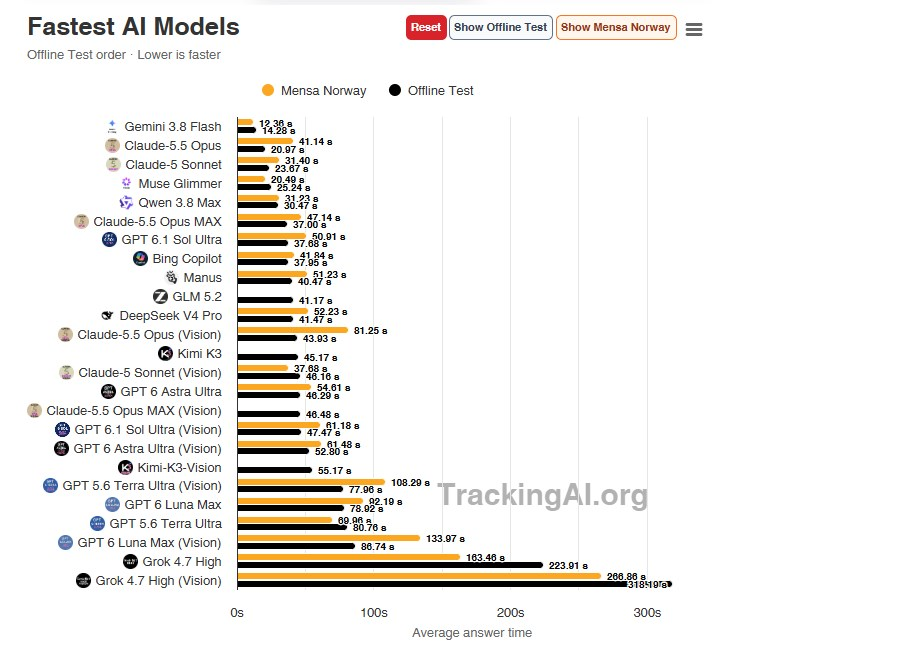
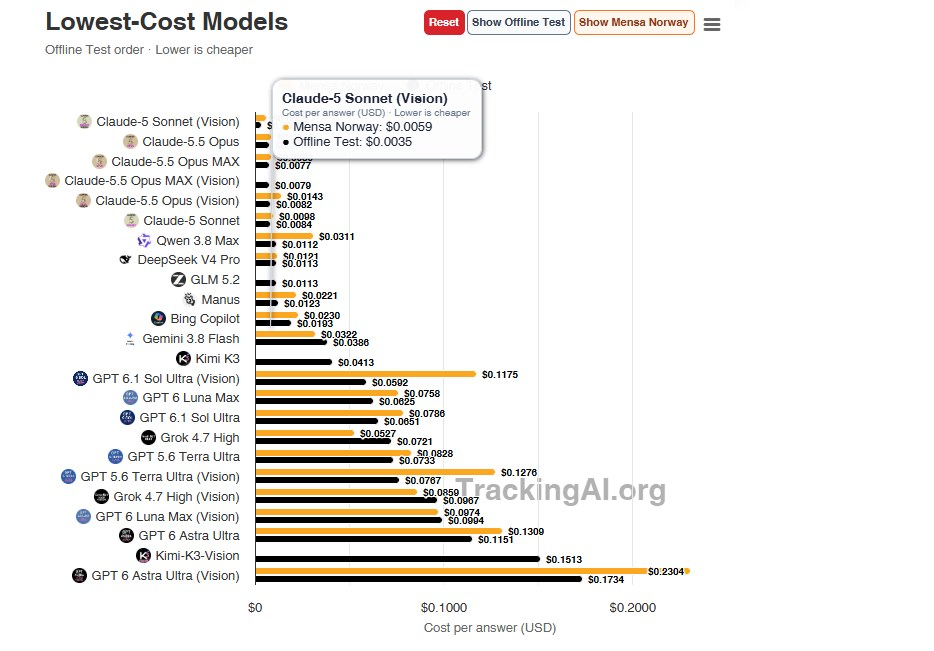
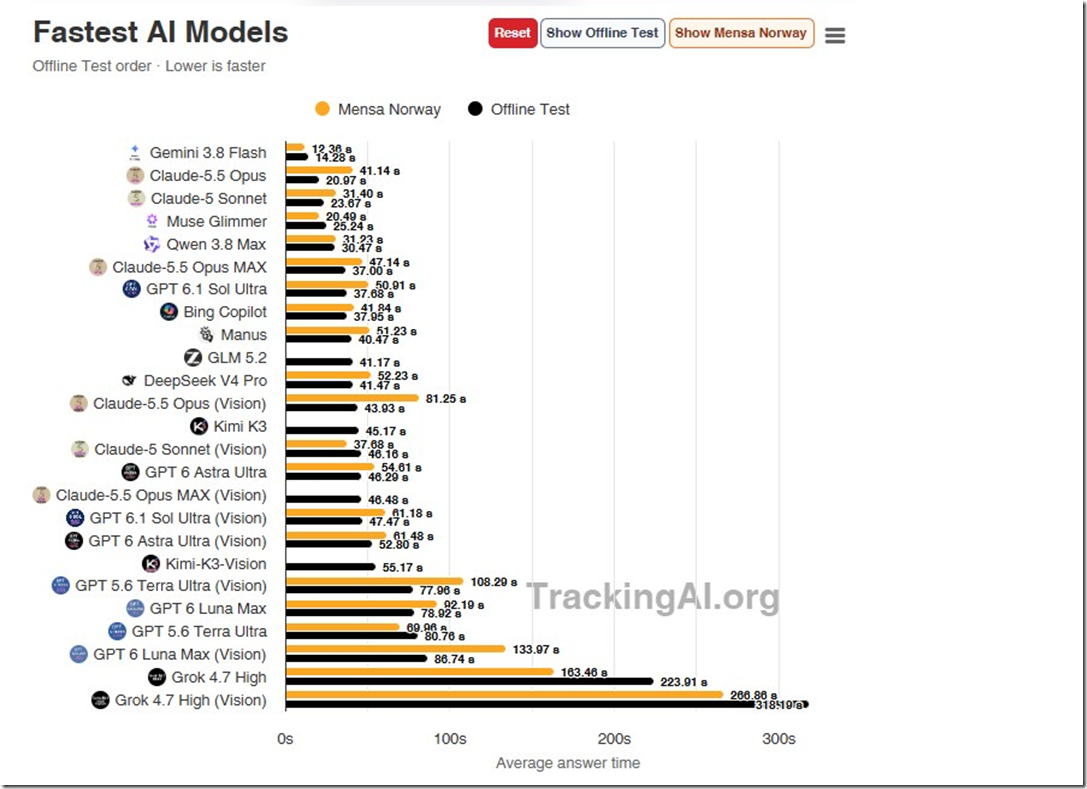
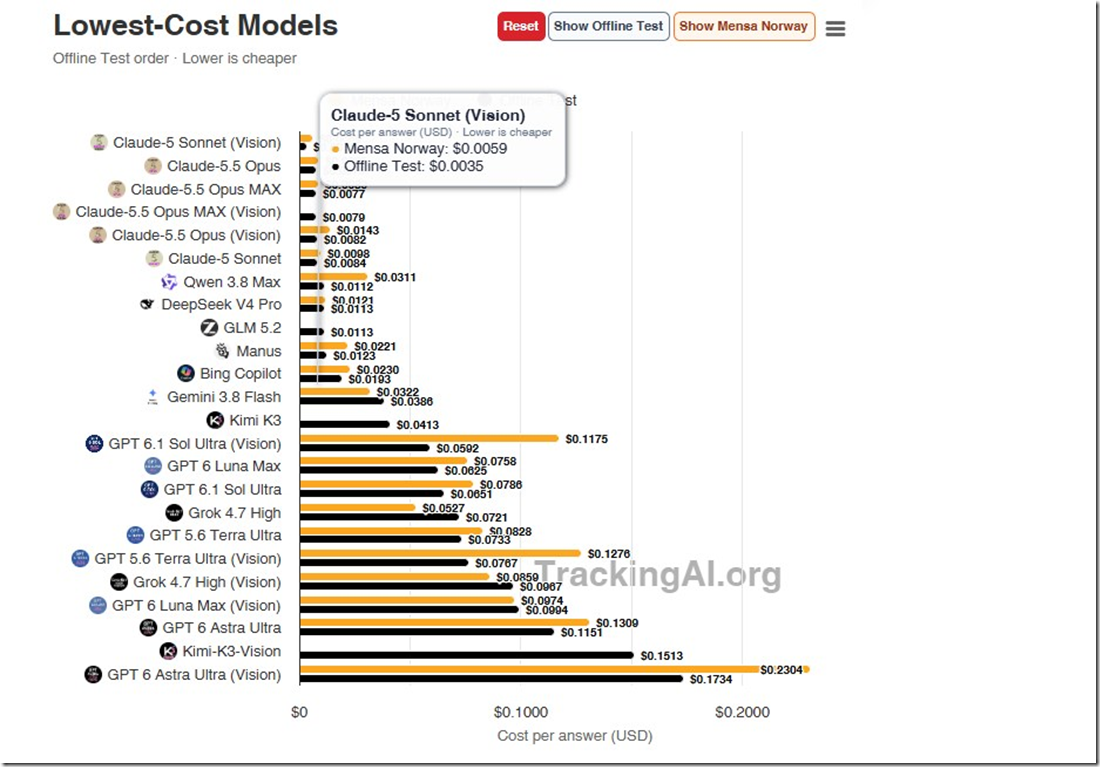
vir: https://trackingai.org/home
Sep 27, 2026 | LLM (AI)
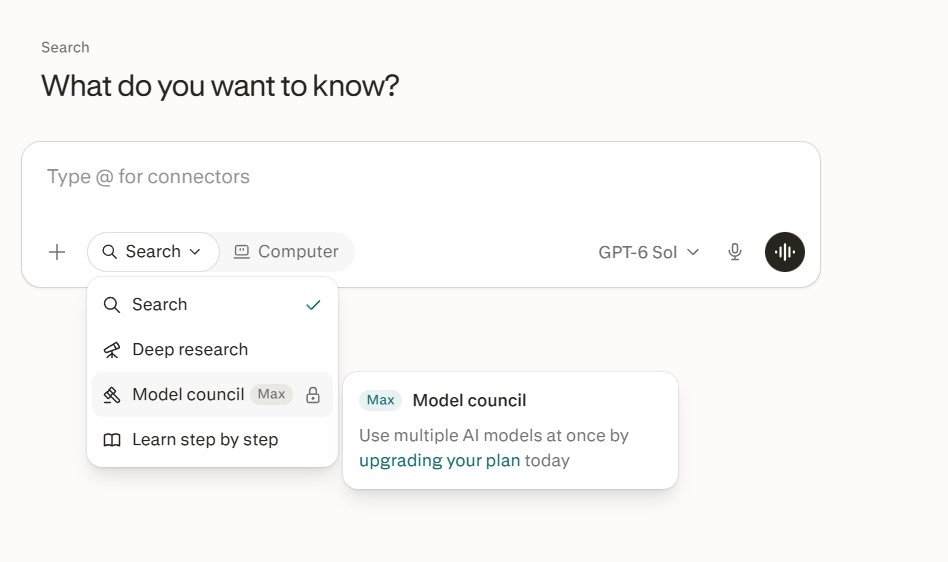
VIR https://www.perplexity.ai/hub/blog/introducing-model-council
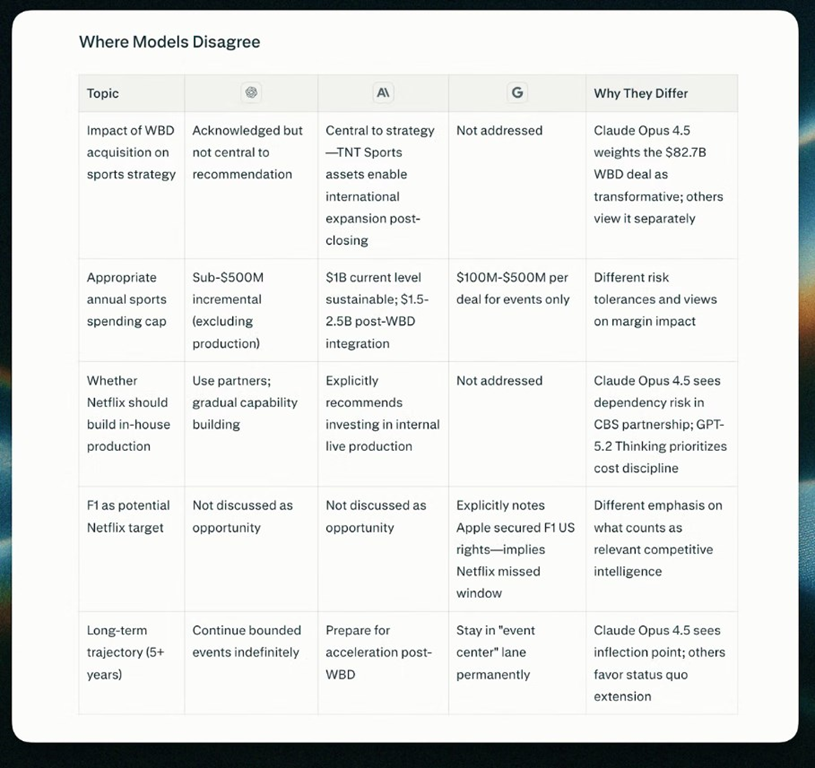
Model Council isto vprašanje hkrati pošlje trem modelom, ki so na voljo v Perplexityju.
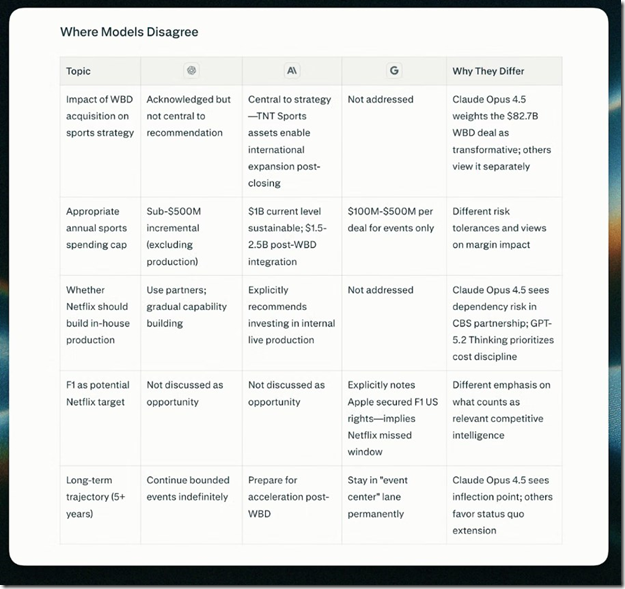
Dodatni model njihove odgovore pregleda, poskuša razrešiti nasprotja in pripravi skupen odgovor z označenimi področji soglasja in razhajanja.
Perplexity funkcijo utemeljuje s tem, da imajo modeli različne prednosti in slepe pege: model, primeren za programiranje, ni nujno najboljša izbira za raziskovanje ali ustvarjalno delo.
Kot primere uporabe članek navaja raziskovanje naložb, pomembne odločitve, ustvarjalno iskanje zamisli in preverjanje informacij.
Soglasje med modeli lahko pomaga pri presoji odgovora; razhajanje pa je znak, da je vprašanje vredno dodatnega preverjanja. Članek ne trdi, da soglasje samo po sebi zagotavlja pravilnost.
Število modelov, ki hkrati obravnavajo vprašanje: trije.
V članku navedeni primeri modelov: Claude Opus 4.6, GPT 5.2 in Gemini 3.0; besedilo jih navaja kot primere, ne kot obvezno stalno sestavo.
Skupni odgovor pripravi še sintezni model, ki primerja njihove rezultate.
Sep 27, 2026 | LLM (AI), Optimizacija
VIR:
Inside the Rise of Enterprise AI Model-Switching https://www.perplexity.ai/hub/blog/inside-the-rise-of-enterprise-ai-model-switching
Gre za analizo uporabe na Perplexityjevi platformi, zato ugotovitev ni mogoče samodejno posplošiti na vsa podjetja.
BISTVO
Uporaba modelov se je leta 2025 razpršila: na začetku sta prevladovala dva, ob koncu leta pa se je promet porazdelil med več modelov različnih ponudnikov.
Aktivnejši uporabniki preizkušajo več modelov kot občasni uporabniki. Članek to razlaga kot premik od enega privzetega orodja k izbiri modela za posamezno nalogo.
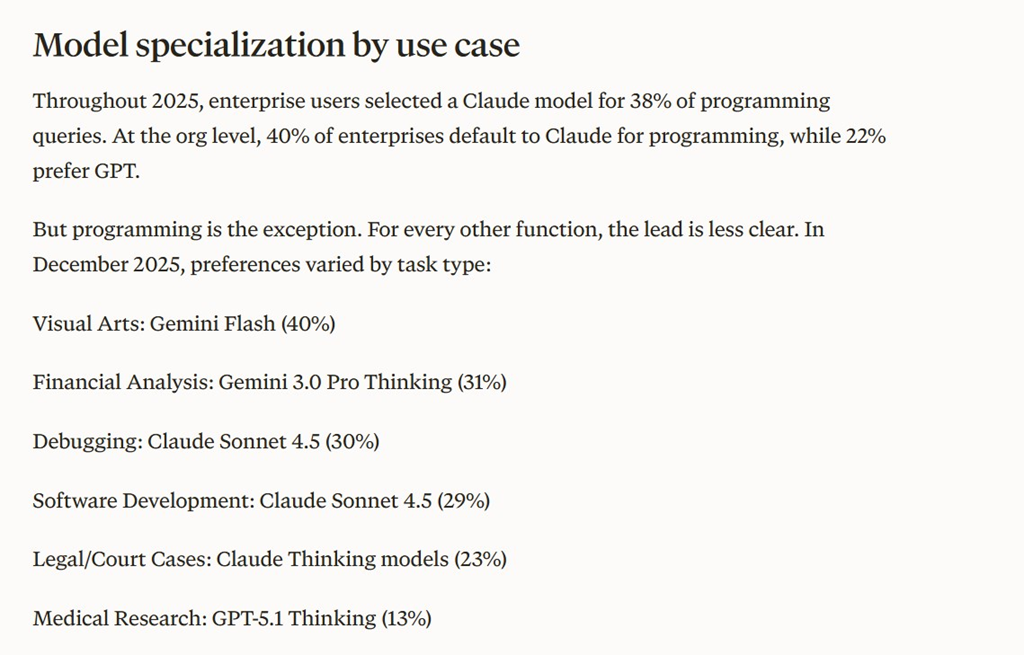
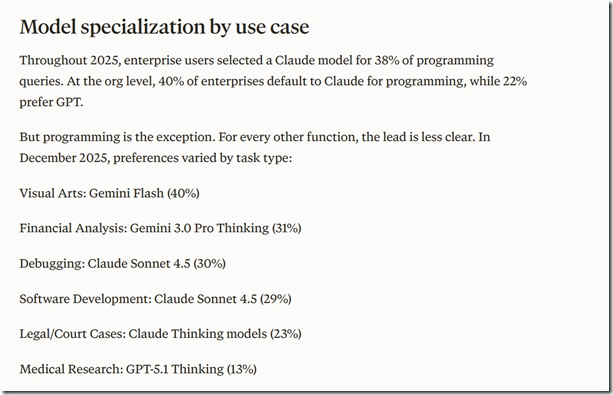
Programiranje najbolj izstopa po naklonjenosti modelom Claude. Pri drugih vrstah dela, od finančne analize do medicinskega raziskovanja, ni enako izrazitega vodilnega modela.
Dostop do več ponudnikov v enem vmesniku zaposlenim po navedbah Perplexityja olajša menjavanje modelov brez ločenih prijav in pogodb. To je hkrati osrednji argument podjetja za lastno platformo.
Priljubljenost novega modela lahko po izdaji hitro naraste in nato upade. Avtorji zato sklepajo, da je za podjetja prilagodljiv dostop do modelov koristnejši od trajne zaveze današnjemu »zmagovalcu«.
DEJSTVA
Po navedbah Perplexityja njegovo storitev uporablja 92% podjetij s seznama Fortune 500, med njimi šest podjetij iz skupine »Magnificent 7«. Članek ne podaja metodologije za preverjanje te trditve.
Januarja 2025 sta modela Claude Sonnet 4 in GPT-4o skupaj predstavljala 91,5% obravnavanih poslovnih poizvedb: prvi 47,5%, drugi 44%. Proti koncu leta so deleži vodilnih modelov znašali 23,3% za Gemini 3.0 Pro Thinking, 20,6% za Claude Sonnet 4.5, 10,7% za Claude Sonnet 4.5 Thinking in 7,9% za GPT-5.
Več kot en model je v letu 2025 vsaj enkrat uporabilo 43,6% poslovnih organizacij. Več modelov v istem dnevu je uporabljalo 9,1% poslovnih uporabnikov.
Med uporabniki, ki sami izbirajo posamezne modele, jih je 53% v letu 2025 vsaj enkrat zamenjalo model znotraj istega delovnega dne. Delež ne velja za vse uporabnike platforme.
Pri programskih poizvedbah so uporabniki v 38% primerov izbrali model Claude. Decembra 2025 je bil pri odpravljanju napak najpogostejši Claude Sonnet 4.5 s 30%, pri finančni analizi pa Gemini 3.0 Pro Thinking z 31%.
CITATI
“Enterprise usage data shows employees are now treating models as a menu of options, not a single default tool.” — Osrednja teza članka: zaposleni modele obravnavajo kot nabor možnosti.
“The top 50 enterprise accounts use 30 models on average versus seven for typical accounts.” — Največje stranke v povprečju uporabljajo precej več modelov kot običajne.
“But programming is the exception. For every other function, the lead is less clear.” — Izrazita prednost modelov Claude pri programiranju se ne ponovi pri vseh nalogah.
“New models typically spike above 50% of enterprise usage for a few days following their release” — Nove izdaje začasno pritegnejo velik delež uporabe.
“When the landscape shifts this quickly, access to every option matters more than choosing today’s best one.” — Zaključni argument avtorjev daje prednost možnosti izbire pred enim stalnim modelom.
Sep 24, 2026 | Magento
Varnish pri zadetku predpomnilnika izrazito skrajša odzivni čas, vendar je za odločitev pomembnejše, kolikšen delež zahtevkov v vaši trgovini sploh doseže predpomnilnik. Mirasvit zato priporoča merjenje deleža zadetkov in obremenitve, ne izbire zgolj na podlagi velikosti kataloga.
Po podatkih Googla lahko ena sekunda nalaganja strani zmanjša konverzijo spletnega mesta za do 20 %. Če je odzivni čas strežnika predolg, lahko uporabnik obupa in se odloči za drug vir. Vsak trenutek šteje, še posebej pri spletnih trgovinah. Predpomnjenje strani pomaga optimizirati ta proces.
VIR: https://mirasvit.com/blog/magento-2-full-page-cache-vs-varnish.html
VIR: https://mirasvit.com/blog/magento-2-cache-management-benefits-problems-solutions.html
BISTVO
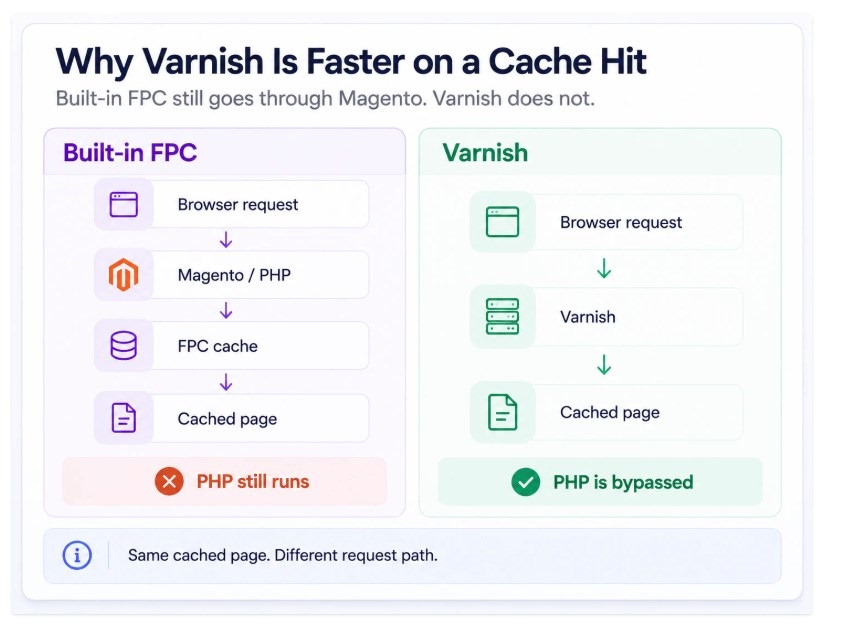
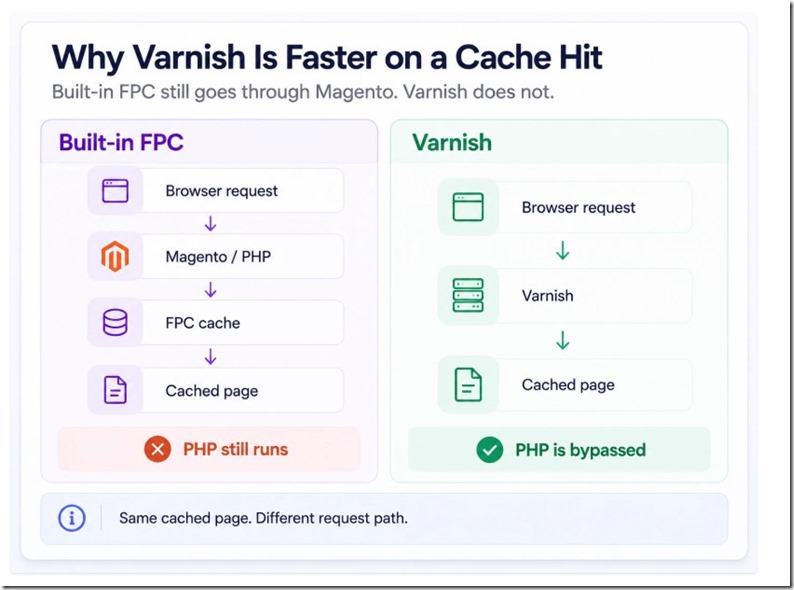
Magentojev vgrajeni predpomnilnik celotnih strani (FPC) tudi ob zadetku zažene PHP; Varnish kot povratni posredniški strežnik lahko odgovor vrne, ne da bi zahtevek dosegel PHP.
Varnishova prednost je zato največja pri že predpomnjenih straneh in večji sočasni obremenitvi; če večina zahtevkov predpomnilnik zgreši, sama zamenjava rešitve ne odpravi vzroka počasnosti.
Avtor na podlagi preverjenih trgovin zavrača tri pogoste posplošitve: da Varnish sam po sebi bolje obravnava zasebno vsebino, zanesljivo prepreči naval zahtevkov po izpraznitvi predpomnilnika ali hitreje razveljavlja strani ob spremembah izdelkov.
Pri uvedbi največ dela po navedbah članka ne povzroča osnovna konfiguracija Varnisha, temveč zaključevanje povezav HTTPS, pravilno posredovanje dejanskega naslova IP obiskovalca in obvladovanje množičnih zahtevkov za čiščenje predpomnilnika.
Če Magento teče na več aplikacijskih vozliščih, vozlišča potrebujejo skupen predpomnilnik: članek navaja Redis za FPC ali Varnish pred vozlišči, sicer lahko obiskovalci vidijo različne podatke o ceni oziroma zalogi.
DEJSTVA
Članek je 24. septembra 2026 objavil Andriy Kovalenko iz podjetja Mirasvit.
Avtorji navajajo primerjavo na 12 trgovinah Magento s katalogi od 3.000 do 100.000 izdelkov; za meritve na dejanskih trgovinah navajajo Magento 2.4.9, PHP 8.3 ter test s 1.000 zahtevki pri 10 sočasnih povezavah.
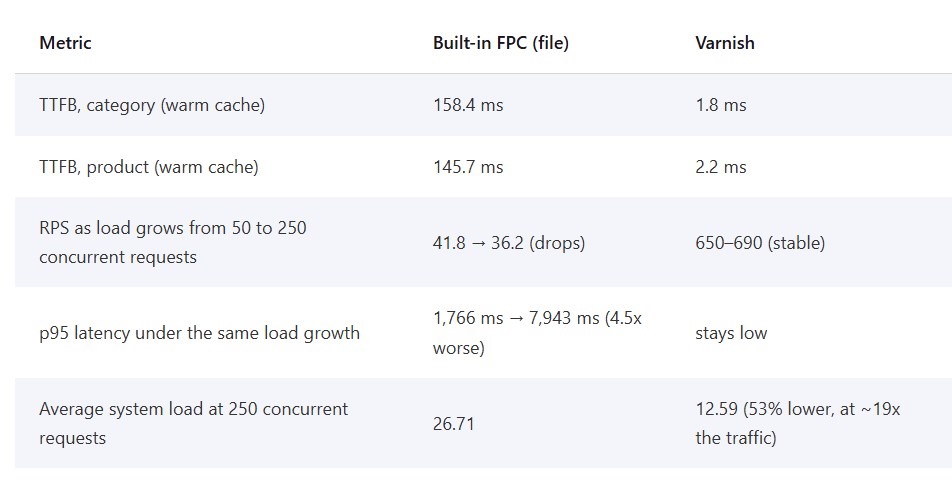
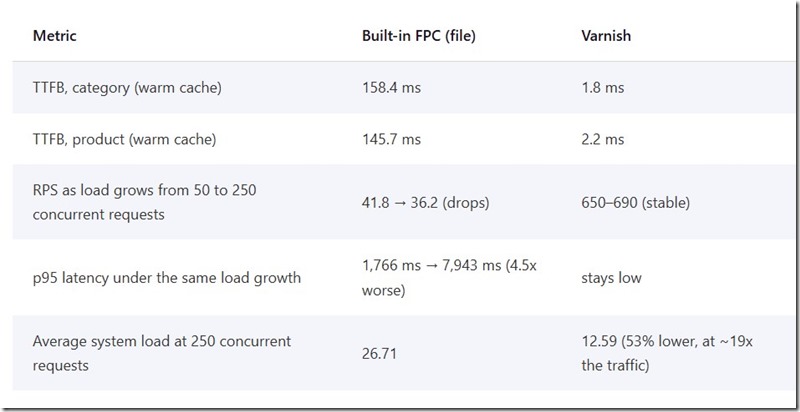
V ločenem internem preizkusu je bil odzivni čas do prvega bajta pri že predpomnjeni kategoriji 158,4 ms za datotečni FPC in 1,8 ms za Varnish, pri strani izdelka pa 145,7 ms oziroma 2,2 ms.
V istem preizkusu je datotečni FPC ob povečanju števila sočasnih zahtevkov s 50 na 250 dosegal od 41,8 do 36,2 zahtevka na sekundo, Varnish pa od 650 do 690; avtorji opozarjajo, da je odjemalec za obremenitveno testiranje pri Varnishu dosegel svojo mejo.
Poročila Mirasvitovega orodja Cache Warmer so za del obravnavanih trgovin pokazala delež zadetkov med 5% in 67%. To ni podatek za vseh 12 trgovin, zato razpona ni mogoče razlagati kot porazdelitve celotnega vzorca.
Sep 24, 2026 | Ecommerce
Kupci lahko izdelke odkrijejo in primerjajo v zunanjem pomočniku, še preden obiščejo trgovino; zato postanejo kakovost podatkov o izdelkih, zaupanje in odnos s kupcem pomembnejši. To je strateška ocena avtorice članka, ne napoved, da bodo spletna mesta izginila.
VIR: https://www.williamscommerce.com/agentic-commerce-ecommerce/
Odkrivanje se seli tudi zunaj trgovine. Pomočnik lahko na podlagi kupčevih potreb in proračuna poišče izdelke, primerja možnosti in zoži izbor. Kupec lahko zato v trgovino pride z že oblikovano odločitvijo ali pa del nakupa opravi drugje.
Spletno mesto ohranja pomembno, vendar drugačno nalogo. Namesto da samo prikazuje katalog in vodi do blagajne, mora kupcu pokazati, zakaj je prodajalec vreden zaupanja: z uporabno vsebino, dobro storitvijo in prepoznavno izkušnjo.
Podatki o izdelkih postajajo pogoj za vidnost. Nepopolni opisi, neskladne lastnosti ter zastarele cene ali zaloge lahko vplivajo na to, ali pomočnik izdelek sploh pravilno razume in ga vključi med priporočila.
Treba je ločiti dve uporabi umetne inteligence. Pomočnik na lastnem spletnem mestu trgovcu omogoča več nadzora nad izkušnjo; zunanji pomočnik pa lahko usmerja odkrivanje izdelkov in morda tudi izvede nakup, pri čemer ima trgovec manj nadzora nad potjo kupca.
Prodajni kanal je tudi odločitev o odnosu s kupcem. Nakup prek zunanje storitve lahko poveča doseg in poenostavi postopek, vendar mora trgovec preveriti, katere podatke o kupcu obdrži in koliko vpliva ima po nakupu. Avtorica zato odsvetuje tako slepo uvajanje novosti kot ignoriranje sprememb.
DEJSTVA
Članek »Agentic Commerce: What It Actually Means For Your Website, Data and Business« je napisala Tanya Peasgood iz Williams Commerce, objavljen pa je bil 23. septembra 2026.
Izhodišče članka je pogovor na srečanju partnerskih agencij ponudnika plačil Mollie na njegovem sedežu v Amsterdamu.
Avtorica obravnava dve različni okolji: pomočnika na trgovčevem spletnem mestu in storitve umetne inteligence zunaj njega.
Po njeni oceni je Shopify trenutno pred drugimi pri razmišljanju o tej spremembi, vendar to ni razlog, da bi trgovec zgolj zaradi tega zamenjal platformo.
Avtorica pričakuje, da bodo povezave med trgovskimi platformami, ponudniki plačil in storitvami umetne inteligence dozorevale v naslednjih dveh do treh letih; hkrati poudarja, da hitrosti razvoja nihče ne more zanesljivo napovedati.
»The website is not dead« — spletno mesto ni mrtvo; avtorica zavrača predstavo, da pomočniki umetne inteligence samodejno pomenijo konec spletnih trgovin.
»product data still matters more than ever« — kakovost podatkov o izdelkih ostaja temeljna tudi takrat, ko jih kupci odkrivajo v drugih kanalih.
»clean product data as a basic business requirement« — urejenih podatkov ne obravnava kot občasnega notranjega opravila, temveč kot poslovno zahtevo.
»Ceding the transaction and the customer data around it should be a deliberate commercial decision« — prepuščanje nakupa in z njim povezanih podatkov drugi platformi mora biti zavestna poslovna odločitev.
»build around authority, experience and customer value rather than another redesign cycle« — pri prenovi naj imajo prednost verodostojnost, uporabniška izkušnja in vrednost za kupca, ne zgolj nova podoba strani.
Sep 7, 2026 | LLM (AI)
ChatGPT naj bi gradil lastno iskalno infrastrukturo z več specializiranimi indeksi, zato ga ni ustrezno opisati le kot uporabnika Googla ali Binga.
VIR:
https://x.com/TomekRudzki/status/2095886026363293717
BISTVO:
ChatGPT-jev sistem za pridobivanje virov se po objavi interno imenuje Labrador in obsega več ločenih indeksov, ne enega samega.
Omenjeni so indeksi za splet, PDF-je, YouTube, novice, arXiv, Wikipedijo, lokalne rezultate, finance, pravo, medicino, nakupovanje in slike.
Nick Turley, vodja ChatGPT, naj bi na protimonopolnem zaslišanju v ZDA leta 2025 pod prisego povedal, da je bil razvoj lastnega indeksa del načrta OpenAI od začetka.
OpenAI naj bi želel tudi Googlove podatke, ne zato, ker lastnega sistema nima, temveč za izboljšanje kakovosti rezultatov in lastnega indeksa.
Nedavni zaposlitveni oglasi za podatkovne sisteme v eksabajtnem merilu po navedbah avtorja kažejo, da OpenAI v to infrastrukturo še naprej intenzivno vlaga.
DEJSTVA:
Avtor objave je Tomek Rudzki (@TomekRudzki), povezan s podjetjem oziroma platformo Peec AI.
Objavljena je bila 4. septembra 2026.
Sistem je v objavi poimenovan Labrador.
Navedeno zaslišanje naj bi potekalo leta 2025.
Objava omenja obseg infrastrukture na ravni eksabajtov, kar pomeni vsaj 1 milijardo gigabajtov podatkovnega prostora na eksabajt. Prvi del navedbe izvira iz objave, pretvorba enote pa je standardna definicija.
CITATI:
“ChatGPT’s retrieval system, internally called Labrador, isn’t one index.”
“It’s a family of indexes: general web, PDF, YouTube, news, arXiv, Wikipedia, local, finance, legal, medical, shopping, images.”
“Building an in-house index was the plan from day one.”
“Job postings talk about exabyte-scale database systems.”
“We heavily underestimate ChatGPT … reducing its impact to ‘they use Google’, ‘they use Bing.’”
Aug 31, 2026 | LLM (AI)
Od 2. avgusta 2026 za določene sisteme UI veljajo nove obveznosti preglednosti iz 50. člena Akta EU o umetni inteligenci. Namen pravil je, da posameznik jasno prepozna stik z UI in umetno ustvarjeno oziroma prirejeno vsebino.
OZNAČEVANJE VSEBIN:


VIRI:
https://www.gov.si/novice/2026-08-03-zacela-so-se-uporabljati-pravila-o-preglednosti-sistemov-umetne-inteligence
https://digital-strategy.ec.europa.eu/en/policies/guidelines-transparency-ai-generated-content
https://digital-strategy.ec.europa.eu/en/library/guidelines-transparency-obligations-providers-and-deployers-ai-systems
https://eur-lex.europa.eu/legal-content/SL/TXT/HTML/?uri=OJ:L_202401689
https://www.akos-rs.si/umetna-inteligenca/raziscite/enotna-kontaktna-tocka
https://pisrs.si/pregledPredpisa?id=ZAKO9225
BISTVO
Ponudniki klepetalnih robotov, virtualnih pomočnikov in primerljivih interaktivnih rešitev morajo uporabnika obvestiti, da komunicira s sistemom umetne inteligence, razen kadar je to glede na okoliščine že očitno.
Sistemi, ki ustvarjajo sintetične zvočne, slikovne, video- ali besedilne vsebine, morajo izhod označiti v strojno berljivi obliki kot umetno ustvarjen ali prirejen.
Uporabljene metode označevanja morajo biti, kolikor je tehnično izvedljivo, učinkovite, interoperabilne, robustne in zanesljive.
Pri sistemih za prepoznavanje čustev in biometrično kategorizacijo morajo uvajalci obvestiti izpostavljene posameznike ter spoštovati predpise o varstvu osebnih podatkov.
Globoki ponaredki morajo biti razkriti kot umetno ustvarjene ali prirejene slikovne, zvočne oziroma video vsebine; za umetniška, satirična in ustvarjalna dela velja sorazmeren pristop, ki ne sme ovirati uživanja dela.
Pri besedilih, ustvarjenih ali prirejenih z UI za obveščanje javnosti o zadevah javnega interesa, je razkritje praviloma potrebno.
Izjema velja, kadar je vsebino preveril človek oziroma je bila uredniško pregledana in za objavo prevzema uredniško odgovornost določena fizična ali pravna oseba.
Informacije o uporabi UI morajo biti jasne, razločne, dostopne ter zagotovljene najpozneje ob prvi interakciji uporabnika s sistemom ali ob prvi izpostavljenosti vsebini.
Evropska komisija je objavila smernice, ki podrobneje pojasnjujejo obseg 50. člena, odgovorne subjekte, izjeme in praktično izvajanje obveznosti.
Slovenija
Za nadzor nad izvajanjem teh pravil v Sloveniji je pristojna Agencija za komunikacijska omrežja in storitve Republike Slovenije (AKOS), ki je tudi enotna nacionalna kontaktna točka za Akt o UI.
AKOS nudi vstopno točko za vprašanja in svetovanje malim in srednjim podjetjem, zagonskim podjetjem, uvajalcem, inovatorjem, občinam in javnosti.
Slovenski izvedbeni zakon za kršitve obveznosti preglednosti predvideva prekrškovne sankcije, zato morajo ponudniki in uvajalci pravočasno preveriti, katere obveznosti veljajo za njihove konkretne primere uporabe.
Če upravljate spletno trgovino, podporni chatbot ali generativna orodja za objave, uvedite vidno obvestilo o uporabi UI pri prvi interakciji.
Za slike, video, zvok in po potrebi besedila, ustvarjena z UI, vzpostavite tehnično označevanje in evidenco postopkov ustvarjanja ter objave.
Pri vsebinah javnega interesa določite človeški uredniški pregled, odgovorno osebo in dokumentiran potek odobritve, če se želite opreti na uredniško izjemo.
Aug 14, 2026 | LLM (AI)
VIR: https://www.nature.com/articles/s41586-024-08025-4
REFERENCA: https://ai.google.dev/responsible/docs/safeguards/synthid
BISTVO:
Članek predstavi SynthID-Text, sistem za označevanje besedil, ki jih ustvarijo LLM, z namenom izboljšati sledljivost in odgovorno uporabo generativne umetne inteligence.
Jedro rešitve je algoritem Tournament sampling, ki pri izbiri naslednjega žetona med več kandidati sistematično izbere takšnega, ki vsebuje šibek, vendar zaznaven signal vodnega žiga.
Sistem ima nedistorzijski način, namenjen ohranjanju kakovosti besedila, ter distorzijski način, ki okrepi zaznavnost za ceno možnega vpliva na kakovost.
V nedistorzijskem načinu testi z uporabniki, avtomatizirane meritve in standardni preizkusi sposobnosti niso pokazali statistično pomembnega poslabšanja kakovosti odgovorov.
Vodni žig ni univerzalni detektor AI-besedil: deluje le pri modelih, kjer je vgrajen, ter je ranljiv za obsežno urejanje, parafraziranje, krajo in ponarejanje signala.
DEJSTVA:
Članek je bil objavljen 23. oktobra 2024 v reviji Nature, zvezek 634, na straneh 818–823; prvi avtor je Sumanth Dathathri, med soavtorji sta Demis Hassabis in Pushmeet Kohli.
Produkcijski poskus je zajel približno 20 milijonov označenih in neoznačenih odgovorov sistema Gemini.
Stopnja odzivov »všeč mi je« je bila pri označenem modelu višja za 0,01 odstotne točke, stopnja odzivov »ni mi všeč« pa nižja za 0,02 odstotne točke; obe razliki sta bili statistično neznačilni.
Kontrolirana človeška primerjava je uporabila 3.000 vprašanj iz zbirke ELI5 in odgovore modela Gemma 7B-IT ter ni zaznala pomembnih razlik v slovnici, relevantnosti, pravilnosti, koristnosti ali splošni kakovosti.
Pri Gemma 7B-IT na štirih TPU v5e je 30-slojni Tournament sampling povečal zakasnitev z 15,527 ms na žeton na 15,615 ms na žeton, kar pomeni 0,57-odstotni pribitek.
Aug 14, 2026 | LLM (AI)
VIR: https://cdn.openai.com/pdf/how-organizations-use-chatgpt.pdf

BISTVO:
Študija analizira administrativne podatke ChatGPT Enterprise do marca 2026, povezane z informacijami o podjetjih, delovnih vlogah, hierarhiji zaposlenih in klasifikaciji nalog.
Osrednja ugotovitev je, da se uporaba v podjetjih ne povečuje le zaradi novih strank, ampak tudi zato, ker obstoječa podjetja orodje uporabljajo vse intenzivneje.
Zgodnji posvojitelji med ameriškimi javnimi podjetji so praviloma večji, vrednejši ter imajo več predhodnih vlaganj v raziskave in razvoj, programsko opremo ter organizacijske zmogljivosti.
Uporaba ni omejena na programerje: prisotna je v številnih funkcijah, od inženiringa, marketinga in financ do vodstva, pri čemer so mlajši zaposleni med aktivnimi uporabniki praviloma intenzivnejši uporabniki.
Najpogostejše naloge vključujejo pripravo dokumentacije in tehničnih besedil, digitalno oziroma tehnično delo, komunikacijo ter sintezo informacij; podjetja pa še vedno odkrivajo, kako AI sistematično vključiti v procese.
DEJSTVA:
Skupna količina ustvarjenih izhodnih žetonov ChatGPT Enterprise je med junijem 2025 in marcem 2026 zrasla približno sedemkrat.
Pri podjetjih, ki so ChatGPT Enterprise uvedla do junija 2025, se je poraba žetonov v istem obdobju povečala približno štirikrat; približno polovica rasti tako izhaja iz globlje uporabe pri obstoječih uporabnikih.
V vzorcu za analizo delovnih vlog je bilo 1.764 organizacij in 17.446.551 sporočil, medtem ko je vzorec za klasifikacijo nalog zajel 973 organizacij in 8.696.657 razvrščenih sporočil.
Med javnimi podjetji je znašal mediani prihodek posvojiteljev 2.275,1 milijona USD, pri ne-posvojiteljih pa 209,6 milijona USD; mediani stroški R&R so znašali 113,1 proti 9,9 milijona USD.
V povprečnem podjetju šest mesecev po uvedbi predstavljajo inženirske in tehnične vloge približno 11% tedensko aktivnih uporabnikov, vodilni pa približno 9%; menedžerji in direktorji predstavljajo približno 24%.
Večja podjetja imajo večjo verjetnost uvedbe, vendar imajo po uvedbi praviloma nižjo izmerjeno uporabo na zaposlenega, kar je skladno z zahtevnejšim organizacijskim skaliranjem.
Podjetja v zgornjem kvartilu prihodkov imajo za 6,9 odstotne točke večjo verjetnost uvedbe, podjetja v zgornjih 5% pa za 9,8 odstotne točke večjo verjetnost.
Analitiki ter zaposleni v marketingu in komunikacijah pošiljajo več sporočil od povprečnega aktivnega uporabnika znotraj istega podjetja, medtem ko jih vodilni pošiljajo manj.
Mlajši zaposleni in pripravniki pošljejo približno osem do devet sporočil tedensko več od povprečnega aktivnega uporabnika v istem podjetju.
Tehnične vloge nadpovprečno uporabljajo AI za tehnično digitalno delo in odpravljanje napak, finance za finančne in davčne naloge, prodaja ter marketing pa za prodajno-marketinške aktivnosti.
CITATI:
»ChatGPT Enterprise usage has grown rapidly« — rast izhaja hkrati iz novih uvedb in poglabljanja uporabe pri obstoječih organizacijah.
»Adoption is concentrated among firms with greater scale and intangible investment« — zgodnje uvajanje je povezano z velikostjo podjetja in že razvitimi nematerialnimi zmogljivostmi.
»Active use within adopting firms spans job functions and seniority levels« — uporaba se širi po organizacijski strukturi, ne le po tehničnih ekipah.
»The most common use cases are writing, communication, and information synthesis« — osrednja vrednost je trenutno predvsem podpora znanjskemu delu.
»Adoption is only the beginning of deployment« — nakup oziroma omogočen dostop do AI še ne pomeni avtomatične produktivnostne preobrazbe; potrebni so procesne spremembe, učenje in komplementarne naložbe.