Apr 28, 2026 | AI SAS
Paket Epismo Agent
Pretvori AI-workflow v “reusable pakete”
Odyssey-2 Max
Interaktivni AI-video svetovi v realnem času
️ Subgrapher
Lokalno usmerjen, P2P delovni prostor za znanje, namenjen raziskavam, sporočilom in izmenjavi idej med agenti.
VIDEO AI ME
Realistični videi z AI igralci iz scenarijev, selfijev, fotografij izdelkov ali kakršnega koli materiala
Replyless
AI upravljalec vaših email map, Telegram poročili ….
Apr 26, 2026 | SEO
-
Članek pokaže, da lahko povsem (ključno pri tem preizkusu je povsem) AI-generirana vsebina na novih domenah kratkoročno doseže indeksacijo in začetno vidnost v Googlu, vendar brez avtoritete, unikatnosti in signalov zaupanja večinoma izgubi uvrstitve v nekaj mesecih.
VIR

BISTVO
-
Avtor opisuje 16-mesečni eksperiment, v katerem so spremljali, kako se v Googlovem iskanju obnese vsebina, ki jo je v celoti ustvarila umetna inteligenca brez človeškega urejanja ali izboljšav.
-
Osrednja ugotovitev je, da Google takšno vsebino pogosto hitro preišče in indeksira, vendar začetna vidnost sama po sebi ne pomeni trajne organske uspešnosti.
-
Članek poudari, da so nove strani sprva dobivale prikaze in nekaj klikov predvsem zato, ker so ciljale na informativne, dolgorepe in manj konkurenčne poizvedbe.
-
Prelom se je zgodil približno po treh mesecih, ko je večina strani sicer ostala indeksirana, vendar je močno padla iz območja rezultatov, ki jih uporabniki dejansko vidijo.
-
Glavno sporočilo članka je, da AI lahko pospeši produkcijo vsebine, ne more pa nadomestiti SEO osnove, kot so avtoriteta domene, E-E-A-T, notranje povezovanje, izvirni vpogledi in jasna struktura spletnega mesta.
DEJSTVA
-
Raziskovalci so kupili 20 novih domen brez povratnih povezav, brez avtoritete, brez pretekle zgodovine v iskanju in za vsako pripravili po 100 AI-člankov, kar skupaj pomeni 2.000 objav v 20 različnih nišah.
-
Po 36 dneh je bilo indeksiranih 70,95% vseh člankov oziroma 1.419 od 2.000 strani, pri čemer je 11 od 20 domen doseglo indeksacijo vseh 100 objavljenih strani.
-
V prvem mesecu so vsa testna spletna mesta skupaj ustvarila 122.102 prikaza in 244 klikov, 80% spletnih mest pa se je uvrščalo za vsaj 100 ključnih besed.
-
Do približno dveh mesecev in pol so se kumulativni rezultati povečali na 526.624 prikazov in 782 klikov, obenem pa je 12 spletnih mest rangiralo za več kot 1.000 ključnih besed.
-
Med tretjim in šestim mesecem je prišlo do zloma uvrstitev, saj je v top 100 ostalo le še 3% strani, do 16. meseca pa so skupni rezultati dosegli 1.092.079 prikazov in 1.381 klikov, z začasnim izboljšanjem po Googlovem spam posodobitvenem valu avgusta 2025, ko je delež strani v top 100 zrasel na 20%.
CITATI
-
Avtor uvodno tezo povzame zelo neposredno: “Google indexed most pages quickly, but without authority, unique insight, or trust signals, rankings collapsed within months.”
-
Namen raziskave je jasno opisan v stavku: “The goal was simple: test how far AI content — with no human editing, rewriting, or enhancement — could go in search.”
-
Za kratkoročni učinek članek izpostavi: “Overall, these results show AI-generated content can gain traction quickly.”
-
Za dolgoročni padec je ključna formulacija: “Without stronger signals — authority, E-E-A-T, unique insights — those rankings are hard to sustain.”
-
Končna poanta članka je strnjena v naslovu zaključnega razdelka: “AI can speed up content creation, but not replace SEO.”
Apr 25, 2026 | LLM (AI)
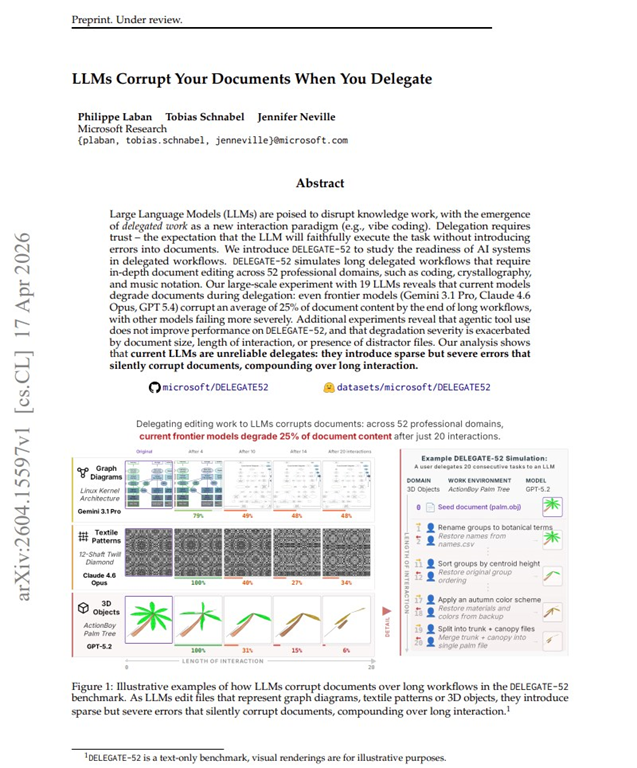
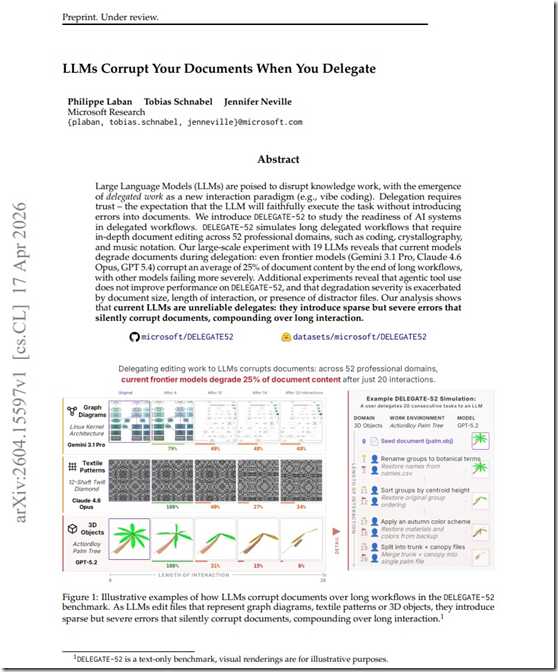
Članek trdi, da današnji LLM-i še niso zanesljivi za delegirano urejanje dokumentov, ker skozi daljše zaporedje nalog tiho vnašajo napake in sčasoma kvarijo vsebino. Avtorji zato predstavijo nov benchmark DELEGATE-52, s katerim merijo, kako dobro modeli ohranjajo pravilnost dokumentov skozi dolge delovne tokove v 52 različnih strokovnih domenah. Najpomembnejše praktično sporočilo je, da dober rezultat v kratkem ali enkratnem testu še ne pomeni, da bo model varen pri dolgotrajni uporabi na istih datotekah. LLM-i danes pri delegiranem delu pogosto ne odpovedo z mnogimi majhnimi napakami, temveč z redkimi, a hudimi okvarami, ki se nato seštevajo skozi več interakcij.
https://github.com/microsoft/DELEGATE52
BISTVO
-
Članek uvede benchmark DELEGATE-52, ki simulira dolge delovne tokove urejanja dokumentov v 52 profesionalnih domenah, od programiranja in kristalografije do glasbene notacije in računovodstva.
-
Osrednja ugotovitev je, da tudi najboljši preizkušeni modeli po daljšem zaporedju delegiranih nalog opazno poslabšajo dokumente, namesto da bi jih zanesljivo ohranili ali pravilno povrnili v prvotno stanje.
-
Metodologija temelji na “round-trip” pristopu: model najprej izvede spremembo, nato njeno obratno različico, raziskovalci pa izmerijo, koliko prvotne vsebine je po tem ciklu še pravilno ohranjene.
-
Rezultati kažejo, da so modeli praviloma boljši v strogo strukturiranih ali programskih domenah, precej slabši pa v naravnojezikovnih in nišnih formatih, kjer je semantična natančnost težje vzdržna.
-
Avtorji iz tega sklepajo, da sedanji LLM-i še niso pripravljeni na zanesljivo delegirano znanstveno, poslovno ali ustvarjalno delo brez tesnega človeškega nadzora.
DEJSTVA
-
Benchmark zajema 52 domen, 310 delovnih okolij in skupaj 2.125 nalog urejanja, razporejenih v pet skupin: Science & Engineering, Code & Configuration, Creative & Media, Structured Records in Everyday.
-
V glavnem eksperimentu so avtorji preizkusili 19 modelov; med vodilnimi so navedeni Gemini 3.1 Pro, Claude 4.6 Opus in GPT 5.4.
-
Po 20 interakcijah so frontier modeli v povprečju izgubili približno 25% vsebine dokumenta, povprečna degradacija čez vse modele pa je bila približno 50%.
-
Python je edina domena od 52, v kateri je večina modelov dosegla prag “ready”, ki ga avtorji definirajo kot vsaj 98% ohranjenosti po 20 interakcijah.
-
Avtorji pokažejo še tri pomembne učinke: večji dokumenti poslabšajo rezultat, daljši potek interakcije dodatno kopiči napake, prisotnost distraktorskih datotek pa zanesljivo škodi uspešnosti.
CITATI
-
“current models degrade documents during delegation” pomeni glavno tezo članka: problem ni le nepopolnost, ampak sistematična degradacija med delegiranjem dela.
-
“corrupt an average of 25% of document content” je najbolj neposredna številčna ocena škode, ki jo avtorji pripišejo tudi najmočnejšim modelom v dolgih potekih.
-
“agentic tool use does not improve performance” poudari, da preprosta dodana orodja sama po sebi ne rešijo problema zanesljivosti pri urejanju dokumentov.
-
“sparse but severe errors” dobro povzame naravo odpovedi: napake niso stalne, vendar so takrat, ko se pojavijo, dovolj velike, da resno poškodujejo artefakt.
-
“Python is the only domain” izpostavi, kako omejena je dejanska pripravljenost modelov za delegirano delo zunaj kodiranja.
Apr 24, 2026 | AI SAS
Yutori Delegate
Agent za raziskave, administrativna opravila, spremljanje in rutinska spletna dela.
Bansi AI by Writesonic
Naložite posneto “talking heads” videoposnetke in dobite pametne shorte, poudarjene povečave, podnapise, dodatne posnetke ter izpopolnjen zvok.
DeepSeek-V4
Serija odprtokodnih modelov MoE s kontekstom 1 milijona tokenov za sklepanje in kodo.
☎️ Amotions AI
Trener za prodajne klice v živo, ki bere čustvene signale, obravnava ugovore in prodajnim predstavnikom pove, kaj naj rečejo, preden se z improvizacijo zapletejo v izgubljeno poslovno priložnost.
Ask Product Hunt AI
Vprašajte po orodjih, primerjajte možnosti in iščite podatke Product Hunta, ne da bi morali neskončno brskati po 47 straneh z novostmi.
Apr 23, 2026 | RAG & SLM
VIR
BISTVO
-
Članek izhaja iz osnovnega dejstva, da je veliki jezikovni model brez trajnega notranjega stanja, zato vsaka API-zahteva začne “od začetka”, kar je dovolj za enkratne naloge, ne pa za več fazne agente.
-
Avtorica zato definira problem spomina kot problem, kako stateless sistemu dati občutek trajnega, poizvedljivega znanja o preteklosti, da lahko sledi odločitvam, preferencam, neuspelim poskusom in zbranim dejstvom.
-
V drugi ravni članka razloži delovni oziroma in-context spomin, kjer model v trenutnem kontekstnem oknu vidi zgodovino pogovora, rezultate orodij, sistemski poziv in relevantne dokumente.
-
Ker kontekstno okno ni neskončno in z dolžino vhodov rasteta strošek ter latenca, članek predstavi zunanji spomin, kjer agent relevantne informacije prikliče iz ločenega sistema šele takrat, ko jih potrebuje.
-
Tretja raven članka pokaže, da v praksi ni dovolj samo hraniti podatke, ampak je treba odločiti tudi, kaj shraniti, kdaj zapisati, kako priklicati pravo informacijo, kako obravnavati zastaranje in kako uskladiti več agentov, ki pišejo v isti spominski sistem.
DEJSTVA
-
Članek z naslovom “AI Agent Memory Explained in 3 Levels of Difficulty” je napisala Bala Priya C in je bil objavljen 22. aprila 2026 v kategoriji Artificial Intelligence.
-
Avtorica članek razdeli na 3 ravni: razumevanje problema spomina, vrste agentnega spomina in arhitekturo spomina pri produkcijski skali.
-
Pri delovnem spominu navede, da trenutni modeli podpirajo približno od 128K do 1M tokenov konteksta, vendar stroški in latenca naraščajo z dolžino vhodnega besedila.
-
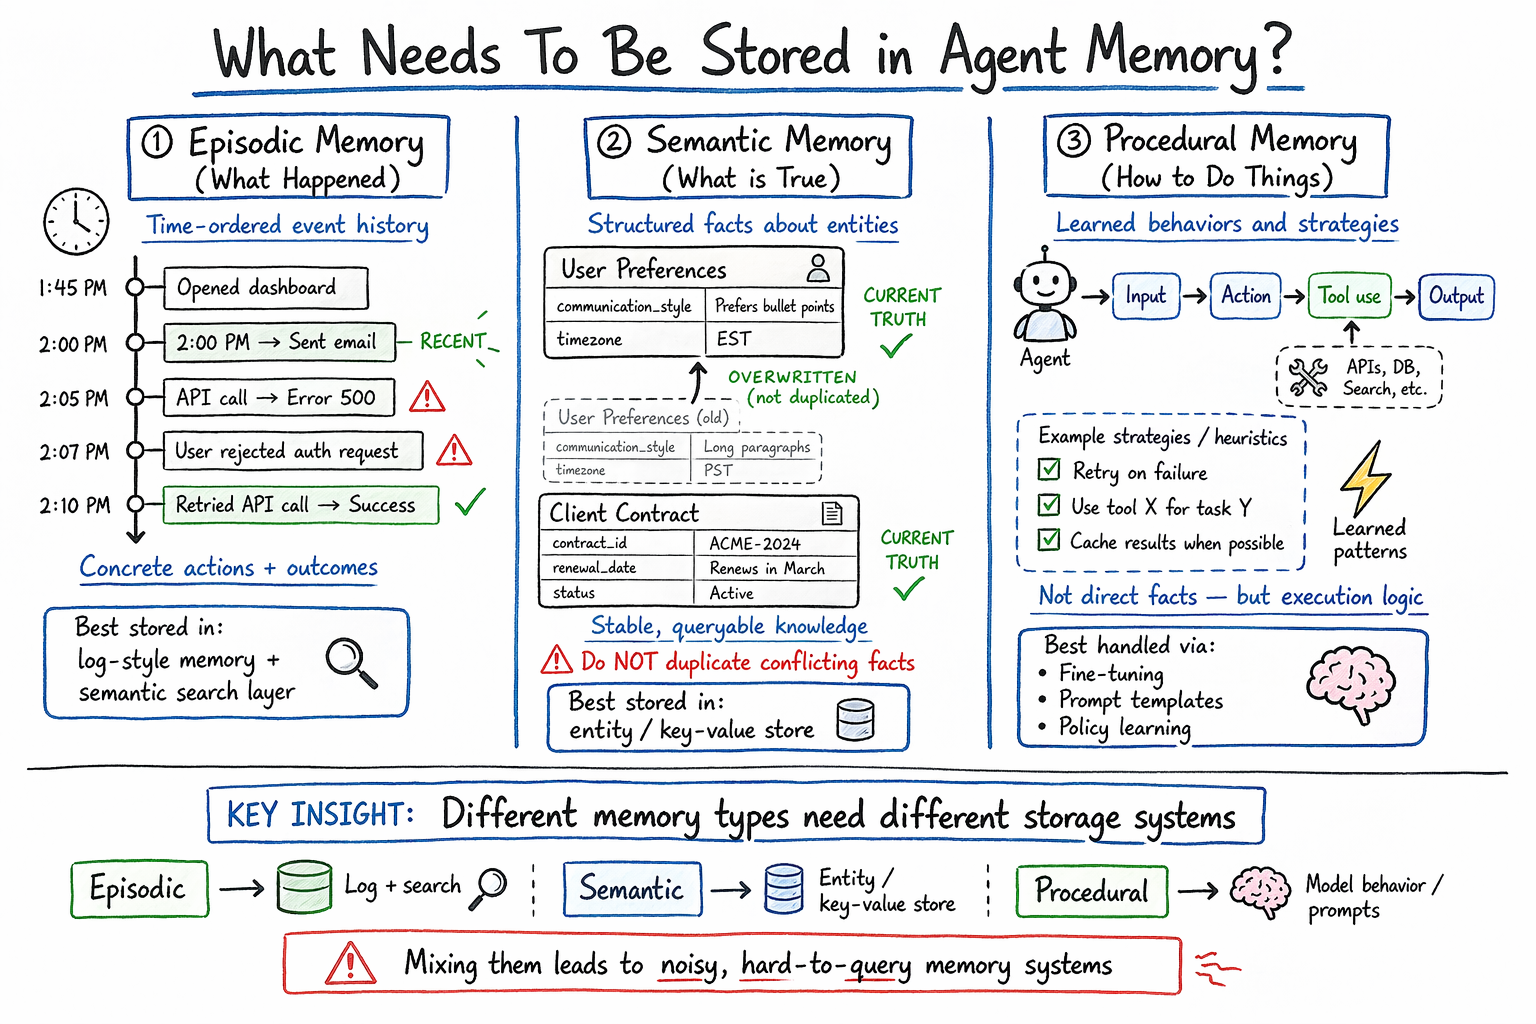
Med glavne tipe agentnega spomina izrecno uvrsti epizodični spomin za dogodke in izide, semantični spomin za dejstva in preference ter proceduralni spomin za uspešne strategije, vzorce delovanja in znane načine odpovedi.
-
Za vrednotenje kakovosti spomina predlaga 4 metrike: retrieval recall, retrieval precision, faithfulness in staleness rate, ker lahko sistem napačen priklic izvede tiho in nato iz njega sklepa povsem verjeten, vendar napačen odgovor.
CITATI
-
“Every request starts from scratch.” Ta kratek stavek povzema jedrni problem stateless agenta, ki brez dodatnega mehanizma ne ohrani nobene operativne kontinuitete med klici.
-
“The memory problem is the problem of giving an inherently stateless system the ability to behave as if it has persistent, queryable knowledge about the past.” To je osrednja definicija članka in najbolj natančen opis, kaj avtorica sploh razume pod agentnim spominom.
-
“Memory has to be selective.” Ta stavek poudari, da dobro zasnovan sistem ne zapisuje vsega, ampak samo tisto, kar vpliva na prihodnje vedenje agenta.
-
“Memories become stale.” S tem avtorica opozori, da je dolgoročni spomin lahko tudi škodljiv, če agent priklicuje zastarele preference, spremenjene entitete ali opuščene tehnične podatke.
-
“Agent memory functions like a stack.” Zaključna metafora članka poveže delovni spomin za trenutno stanje in zunanji priklic za zgodovino ter dejstva v enoten praktični model delovanja.
Apr 22, 2026 | AI SAS
️ ChatFolders
Uredite AI-kaos v pregledne mape za ChatGPT, Claude, Gemini in Grok
ml-intern
AI agent poskrbi za rutinsko delo po usposabljanju, da bodo vaši modeli dejansko res prišli na trg
FusedFrames
Spremenite znanje vašega tima v strukturirane podatke, ki jih AI agenti lahko dejansko uporabijo
⚙️ Story copilot
Oblikujte in izvajajte zapletene workflow zgolj s klepetanjem (podobno kot pri Zapierju)
Nomie v2
Zamenjajte doomscrolling z gamified svetom, ki spremlja vaše razpoloženja, gradi navade in pomiri vaš živčni sistem.
Apr 21, 2026 | SEO
„4 SEO koncepti, ki vam ne pomagajo” — avtor Mike Friedman razgrinja štiri pogosto napačno razumljene SEO prakse, ki po nepotrebnem jemljejo čas in energijo.
VIR: https://theseopub.com/4-seo-concepts-that-arent-helping-you/

BISTVO — 5 ključnih ugotovitev:
-
Google že dolgo ne temelji na štetju ključnih besed, temveč razume entitete, kontekst in namen iskanja, zato optimizacija gostote ključnih besed ni smiselna
-
Ocena PageSpeed Insights (Lighthouse) je laboratorijsko orodje za diagnostiko napak, ne merilo za rangiranje — Google dejansko uporablja podatke iz resničnih uporabniških sej (Core Web Vitals)
-
Daljša vsebina ne rangira bolje sama po sebi; rangira bolje, ker pogosto pokriva več entitet in odgovori na več vprašanj — a besedna dolžina brez vsebinske vrednosti ne pomaga
-
Orodja tretjih strani, ki označujejo “toksične” povezave, pogosto niso usklajena z Googlovimi dejanskimi kriteriji; Google v večini primerov sam ignorira nizkokakovostne povezave
-
Skupni vzorec napak je, da se optimizatorji osredotočijo na konkretne, merljive številke namesto na dejavnike, ki dejansko vplivajo na to, kako Google ocenjuje stran
DEJSTVA — 5 podatkovnih dejstev:
-
Lighthouse oceni tri Core Web Vitals metrike: LCP (hitrost nalaganja največjega elementa), INP (odzivnost na interakcijo) in CLS (nestabilnost postavitve)
-
Stran z oceno 65 v Lighthouse ima lahko odlične Core Web Vitals, stran z oceno 98 pa slabe — ker laboratorijsko in terensko merjenje nista enaka
-
Primer: stran z 3.000 besedami polnila se obnese slabše od strani z 1.200 besedami globinskega znanja
-
Orodje za disavow je namenjeno izrecno dvema primeroma: manualnim kaznim in zavestni udeležbi v shemah plačanih povezav
-
Avtor je Mike Friedman, članek je bil objavljen 21. aprila 2026
CITATI — 5 dobesednih citatov:
-
“There is no target percentage. There hasn’t been one for a very long time.” — o gostoti ključnih besed
-
“The Lighthouse score you see in PageSpeed Insights is a lab-based diagnostic tool… It’s a debugging tool.”
-
“More words is not more information gain. More novel, specific information is more information gain.”
-
“Google has said repeatedly that its algorithms are very good at identifying and ignoring low-quality links on their own.”
-
“The fix is always the same question. Does this thing I’m spending time on directly influence how Google evaluates my site?”
Apr 21, 2026 | SEO
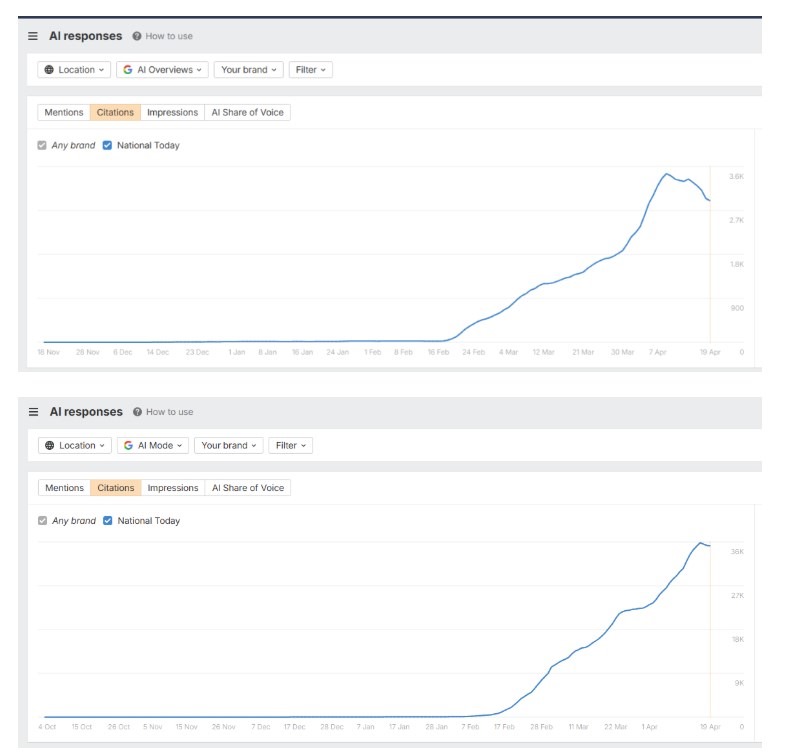
Članek opozarja na sistemsko tveganje: agresivno in nepremišljeno skaliranje z AI-vsebino za SEO ne prinaša le Google kazni (v tem primeru ročne, sicer pa v obliki padca v serp-u – praviloma kmalu po začetnem vrhu), temveč se posledice kaskadno razširijo na vse AI iskalne platforme, ki temeljijo na Googlovem indeksu. Primer NationalToday.com je jasen dokaz, da »Mt. AI« strategije delujejo le začasno, nato pa se sesuljejo na vseh frontah hkrati.
BISTVO
-
Spletišče NationalToday.com je v direktoriju /us/ objavilo več kot 850.000 100% AI-generiranih lokalnih novic, ki so se uvrščale v Google Top Stories, News in Discover
-
Google je po razkritju portala Futurism izdal ročni ukrep za »scaled content abuse« in celoten direktorij odstranil iz indeksa
-
Odstranitev iz Googlovega indeksa je neposredno povzročila izpad v AI Overviews, AI Mode in posledično v ChatGPT citatih
-
ChatGPT pri iskanju z utemeljitvijo na spletu delno uporablja Googlov indeks, zato spletišče, ki je odstranjeno iz Googla, izgubi tudi večino CitGPT citatov
-
Izjema so redki primeri, kjer ChatGPT za utemeljitev uporablja Bing ali drug vir in citati ostanejo
DEJSTVA
-
850.000+ URL-jev v /us/ direktoriju — vse 100% AI-generirane vsebine
-
Vidnost spletišča se je po ročnem ukrepu takoj strmoglavila — tipičen vzorec, ki ga Gabe imenuje »Mt. AI«
-
Preverjanje je potekalo na več ChatGPT računih (plačljivi in brezplačni) prek orodja Brand Radar (Ahrefs)
-
Večina citatov za /us/ direktorij je izginila; le redki so ostali (verjetno prek Bing indeksa)
-
Ukrep je prizadel izključno /us/ direktorij — preostala vsebina NationalToday.com v Googlu in ChatGPT-u ostaja nedotaknjena
CITATI
-
“A recent manual action provides a great view of how scaling via AI-generated content can yield a huge drop in Google’s 10-blue links, AI Overviews, and AI Mode.”
-
“When ChatGPT searches the web to ground answers, it can leverage Google’s index (which has been documented many times).”
-
“If you receive a manual action from Google… then you will drop in AIOs, AI Mode, and then downstream in AI search (which includes ChatGPT).”
-
“Do not implement risky and spammy tactics just to rank in AI search.”
-
“It works until it doesn’t. It’s just another example of ‘Mt. AI’. Beware.”
Apr 21, 2026 | AI SAS
Dune
Tipkovnica za Mac, ki se prilagaja kontekstu in v realnem času spreminja vaše bližnjice
Claude Desktop Buddy
Spremenite Clauda v fizičnega sodelavca tako, da ga povežete s strojno opremo, ki se odziva, signalizira in usklajuje z vašo umetno inteligenco.
The New Waydev
Preverite, ali se vaša koda, napisana z umetno inteligenco, dejansko izvede
Pegasus 1.5 od TwelveLabs
Pretvori dolge videoposnetke v podatke z možnostjo iskanja in časovnimi oznakami, tako da lahko pregledujete posnetke, kot da gre za preglednico.
Granter
Agent, ki poišče, napiše in upravlja s sredstvi za subvencije
Apr 21, 2026 | PPC
Članek razkriva, kako StackAdapt aktivno gradi mostove med trenutnim oglaševanjem in generativnimi AI platformami. Oglaševanje znotraj ChatGPT ni zgolj kontekstualno – temveč je usmerjeno glede na relevantnost poziva, kar pomeni, da se oglasi prikazujejo na podlagi tega, kaj uporabnik išče ali sprašuje v realnem času. To predstavlja novo paradigmo v digitalnem oglaševanju, kjer se premika od ključnih besed (SEO/SEM) k nameri izraženi v naravnem jeziku. Minimalna poraba $50.000 nakazuje, da je pilot za zdaj namenjen večjim oglaševalskim proračunom, ne malim podjetjem.
VIR: https://www.adweek.com/media/exclusive-leaked-deck-reveals-stackadapts-playbook-for-chatgpt-ads/
BISTVO
-
StackAdapt, neodvisna platforma na strani povpraševanja (DSP), tiho pristopa oglaševalcem z možnostjo testiranja oglasov znotraj ChatGPT
-
Program je zasnovan kot zgodnji dostop do novega »odkritvenega sloja« (discovery layer), ki cilja uporabnike med fazo raziskovanja in primerjave izdelkov
-
Pitch deck z naslovom “OpenAI x StackAdapt Limited Pilot Program” je bil dne 27. marca poslan izbranim kupcem in ga je pregledal Adweek
-
CPM (cena na tisoč prikazov) se giblje med $15 in $60, pri čemer StackAdapt ponuja znižane platformske in upravljavske provizije
-
Vstop v pilotni program zahteva minimalno porabo $50.000, kar program umešča med premium ekskluzivne ponudbe
DEJSTVA
-
CPM razpon: $15–$60 glede na relevantnost poziva (prompta)
-
Minimalna poraba: $50.000 za vstop v pilotni program
-
Datum pošiljanja decka: 27. marec 2025 (izbranim kupcem)
-
Avtor članka: Trishla Ostwal, poročevalka Adweeka za AI in tehnologijo
-
Platforma: ChatGPT je opredeljen kot »ena od najhitreje rastočih potrošniških platform na svetu«
CITATI
-
“StackAdapt has partnered with OpenAI to enable advertising within ChatGPT, one of the fastest growing consumer platforms in the world.” — iz pitch decka
-
Opis umestitve: zajemanje uporabnikov »in the middle of researching and comparing products on ChatGPT«
-
Program je opredeljen kot »early-stage test inside a still-developing ad system«
-
Pozicioniranje: StackAdapt program opisuje kot dostop do novega »discovery layer«
-
Adweek ekskluzivno poroča: deck je bil »shared with select buyers on March 27 and reviewed by ADWEEK«