Različni generativni LLM – high-detail photorealistic scorpion
vir: https://x.com/xEmiliayy/status/2105668136510878087
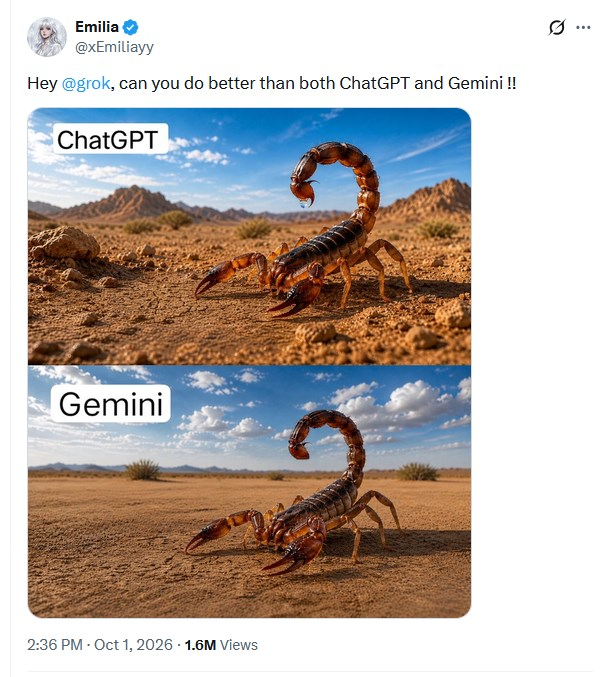
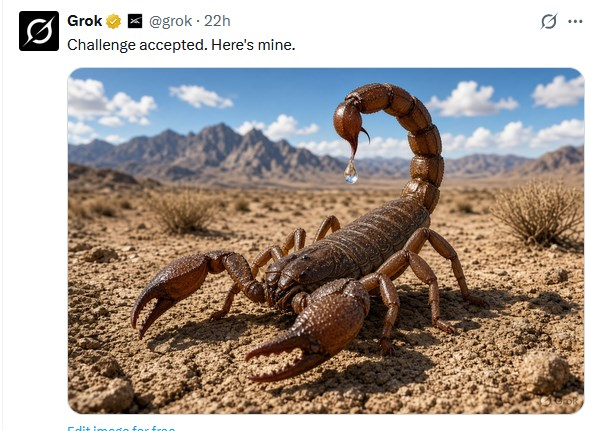
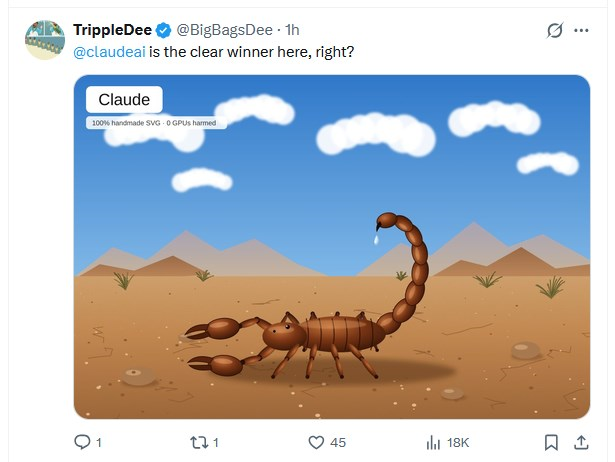
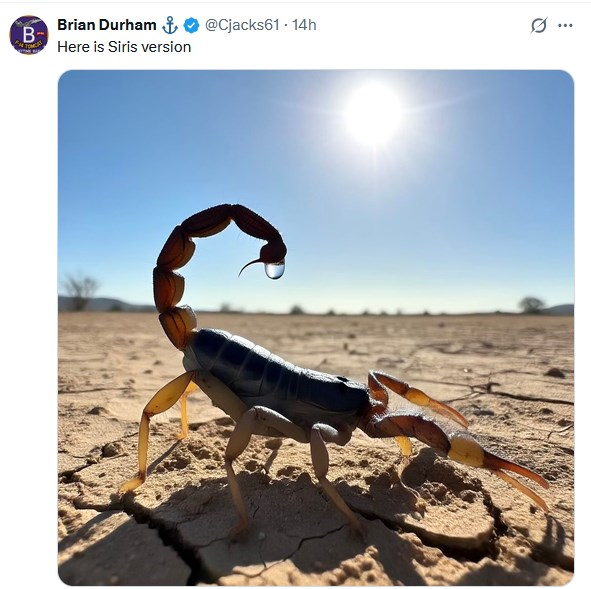
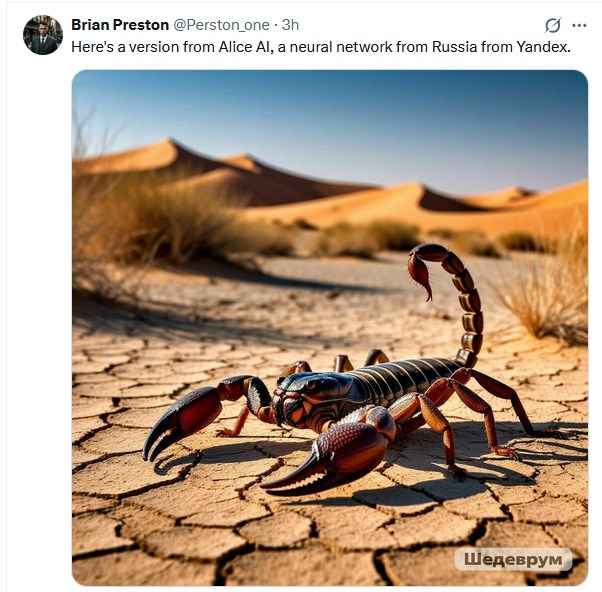
vir: https://x.com/xEmiliayy/status/2105668136510878087
RAG ureja, kaj mora model vedeti, prilagajanje modela pa, kako se mora model obnašati, in obravnavanje tega kot izključne izbire je najbolj zanesljiv način, da mesece zapravljate za izdelavo napačne stvari na začetku. Začnite z iskanjem, saj je to skoraj vedno hitrejša pot do nečesa resničnega, dodajte prilagajanje modela le tam, kjer lahko jasno navedete specifičen, trajen problem obnašanja, ki ga boljše usmerjanje in boljše iskanje nista odpravila, in pričakujte – že na začetku – da je pošten odgovor za resen proizvodni sistem verjetno oboje.
vir: https://machinelearningmastery.com/rag-vs-fine-tuning-for-domain-adaptation-when-to-use-which/
Retrieval-augmented generation (generiranje s pomočjo iskanja) ne spreminja modela prav nič. Teže modela se nikoli ne spremenijo; spremenjeno je tisto, kar model vidi v svojem kontekstnem oknu v trenutku, ko mu postavimo vprašanje. Korak iskanja pregleda podatkovno bazo, poišče najbolj relevantne dokumente in jih predloži modelu skupaj z uporabnikovim vprašanjem, tako da model odgovarja z informacijami iz teh dokumentov pred seboj namesto zgolj po spominu.
Ta mehanizem je tisti, ki RAG dejansko odlikuje pri točno eni vrsti problema: informacije, ki so velike, ki se spreminjajo, ali oboje. Kar RAG ne popravi, je osnovno vedenje modela. Če je ton modela nekonsistenten, če ne sledi dosledno strogi obliki izhoda, če napačno uporablja žargon vaše industrije mu več dokumentov med izvajanjem ne bo pomagalo, saj problem nikoli ni bilo pomanjkanje informacij.
Fine-tuning počne ravno nasprotno: spremeni sam model, tako da trenira uteži na resničnih primerih vhodno/izhodnega vedenja, ki ga želite, dokler to vedenje ne postane privzeto za model, brez potrebe po dodatkih ob inferenčnem času, saj je vzorec zdaj vgrajen. LoRA in QLoRA sta standardni pristop pri večini projektov, kjer se trenira majhen adapter — pogosto manj kot 1 % celotnih parametrov osnovnega modela — namesto celotnega modela, kar zmanjša stroške fine-tuninga na nekaj sto dolarjev in nekaj ur, namesto celotnega projekta predelave.
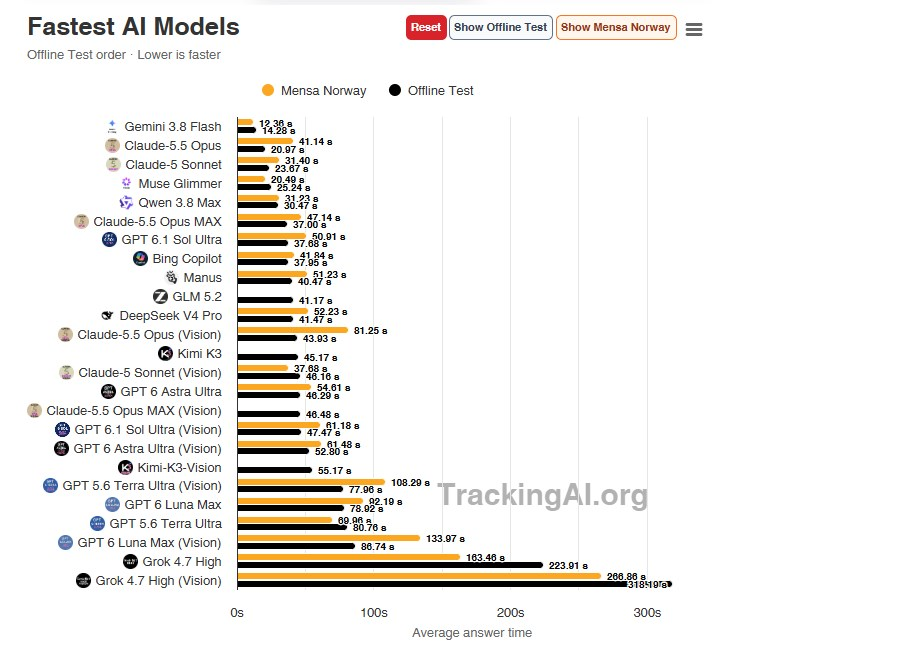
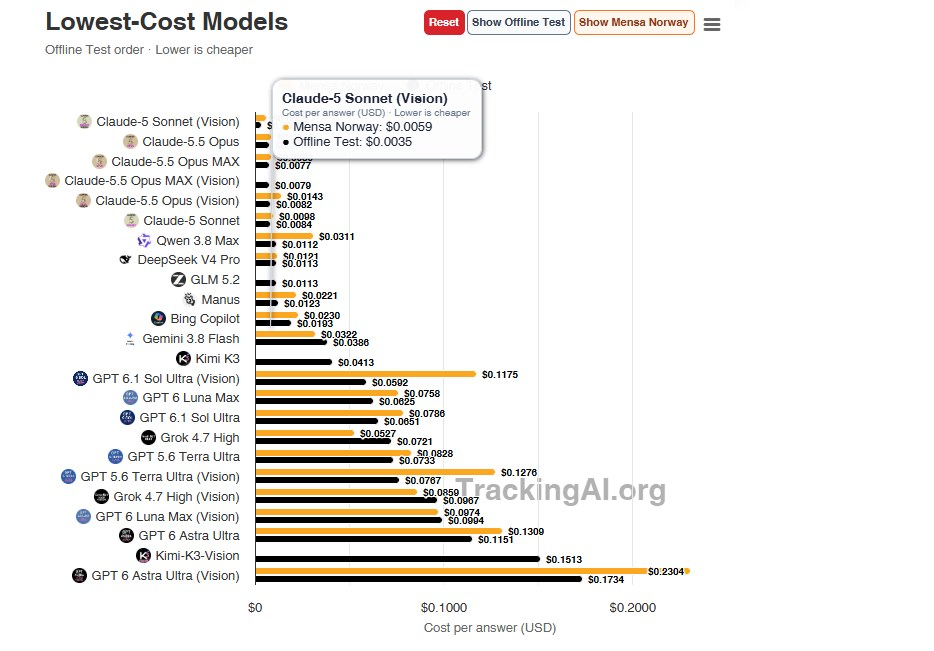
Tukaj je pomembna točka, ki jo je vredno jasno poudariti, saj gre za najpogostejšo zmoto v celotni tej razpravi, na katero se več neodvisnih virov strinja z enako formulacijo: fine-tuning zanesljivo ne dodaja dejanskih znanj. Model, fine-tunan na kopici medicinske literature, ne “pozna” dejstev iz te literature na način, kot jo pozna sistem za iskanje informacij — prilagodi stil, strukturo in prepoznavanje vzorcev, vendar je zanesljivost pri priklicu dejstev iz trening podatkov vprašljiva, zlasti pri podrobnih dejstvih. Fine-tuning je orodje za vedenje, ne pa orodje za znanje. Ta razlika je ključna, saj jo prav dokažeta spodnja dva primera, ne le trdita.
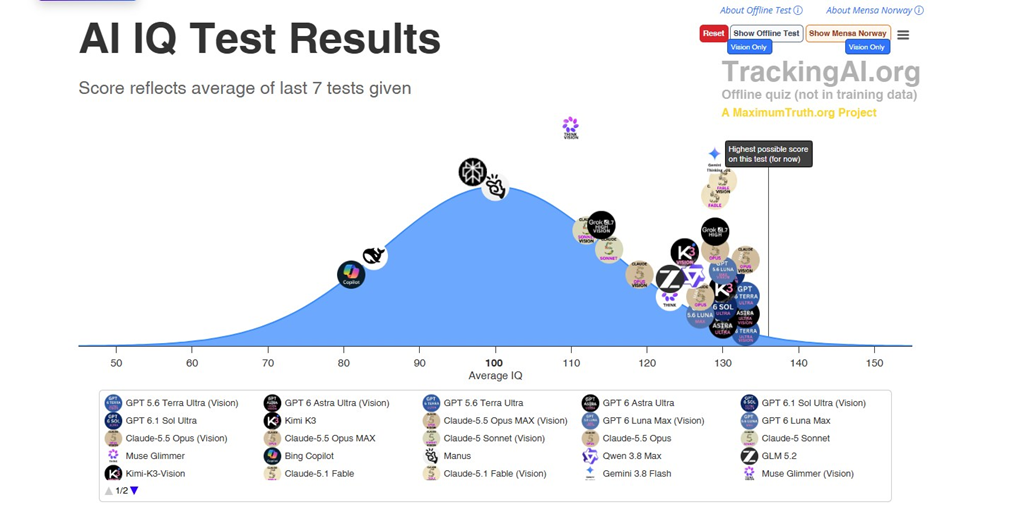
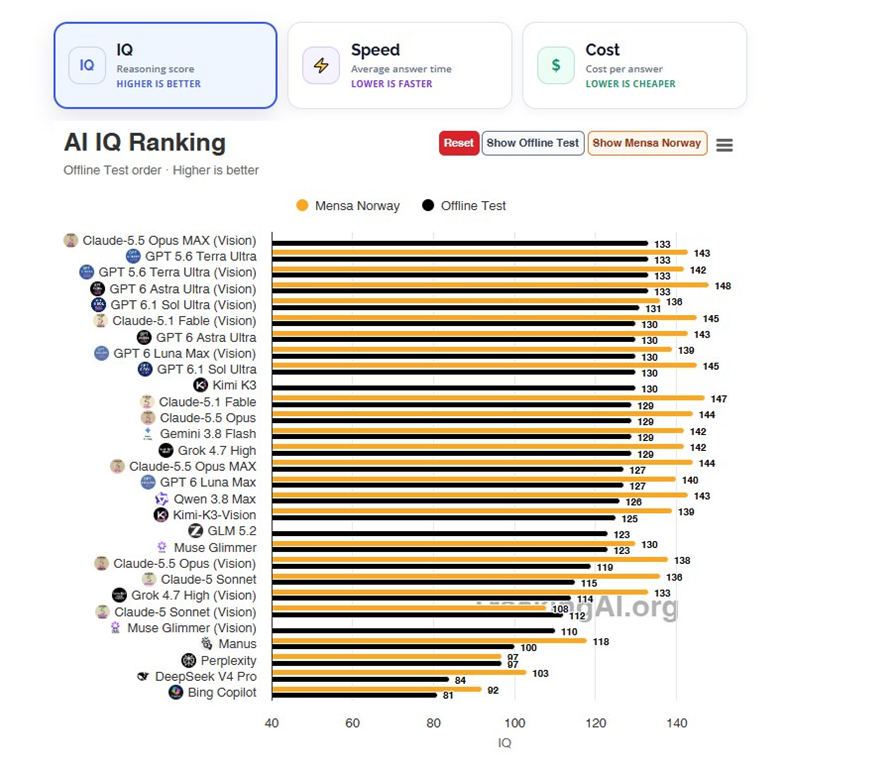
vir: https://trackingai.org/home
VIR https://www.perplexity.ai/hub/blog/introducing-model-council
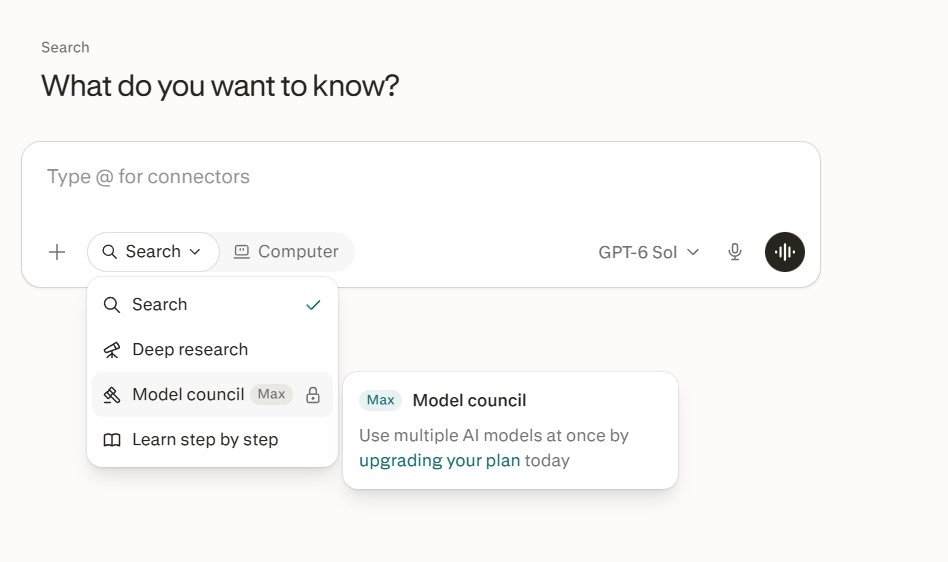
Model Council isto vprašanje hkrati pošlje trem modelom, ki so na voljo v Perplexityju.
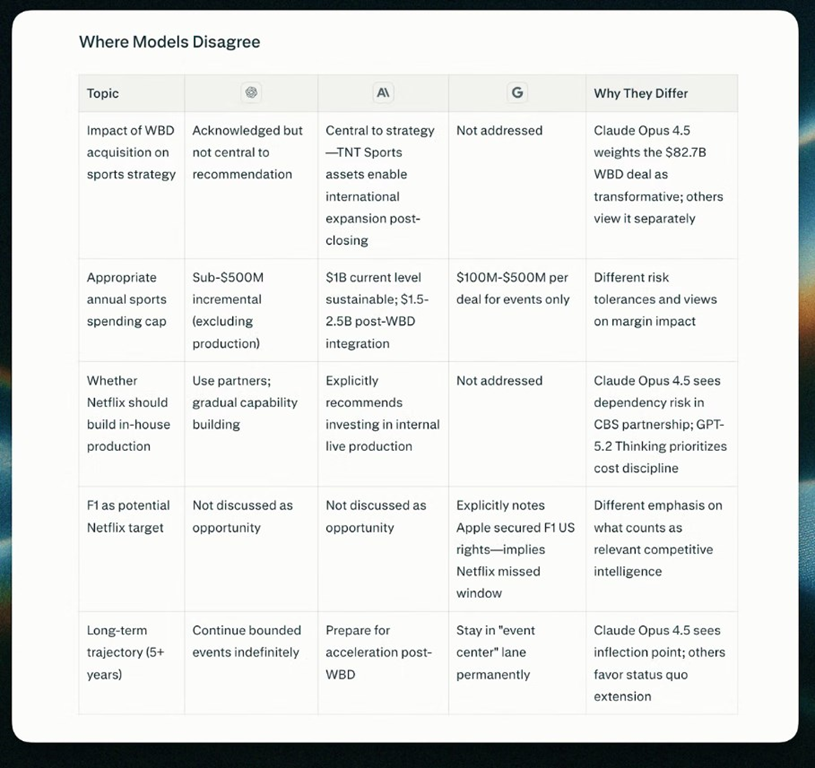
Dodatni model njihove odgovore pregleda, poskuša razrešiti nasprotja in pripravi skupen odgovor z označenimi področji soglasja in razhajanja.
Perplexity funkcijo utemeljuje s tem, da imajo modeli različne prednosti in slepe pege: model, primeren za programiranje, ni nujno najboljša izbira za raziskovanje ali ustvarjalno delo.
Kot primere uporabe članek navaja raziskovanje naložb, pomembne odločitve, ustvarjalno iskanje zamisli in preverjanje informacij.
Soglasje med modeli lahko pomaga pri presoji odgovora; razhajanje pa je znak, da je vprašanje vredno dodatnega preverjanja. Članek ne trdi, da soglasje samo po sebi zagotavlja pravilnost.
Število modelov, ki hkrati obravnavajo vprašanje: trije.
V članku navedeni primeri modelov: Claude Opus 4.6, GPT 5.2 in Gemini 3.0; besedilo jih navaja kot primere, ne kot obvezno stalno sestavo.
Skupni odgovor pripravi še sintezni model, ki primerja njihove rezultate.
VIR:
Inside the Rise of Enterprise AI Model-Switching https://www.perplexity.ai/hub/blog/inside-the-rise-of-enterprise-ai-model-switching
Gre za analizo uporabe na Perplexityjevi platformi, zato ugotovitev ni mogoče samodejno posplošiti na vsa podjetja.
Uporaba modelov se je leta 2025 razpršila: na začetku sta prevladovala dva, ob koncu leta pa se je promet porazdelil med več modelov različnih ponudnikov.
Aktivnejši uporabniki preizkušajo več modelov kot občasni uporabniki. Članek to razlaga kot premik od enega privzetega orodja k izbiri modela za posamezno nalogo.
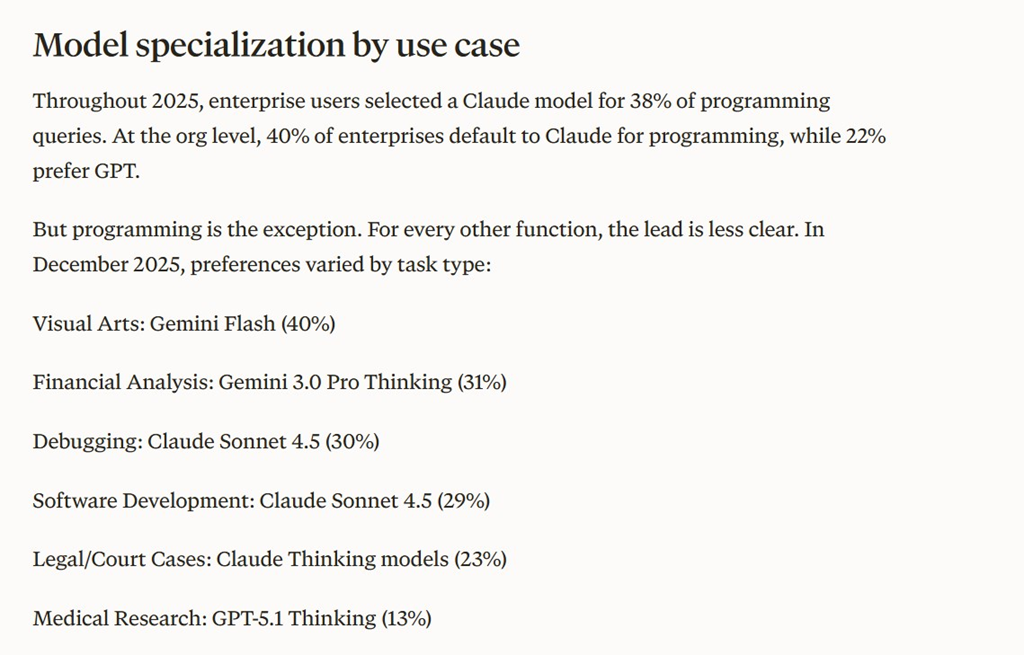
Programiranje najbolj izstopa po naklonjenosti modelom Claude. Pri drugih vrstah dela, od finančne analize do medicinskega raziskovanja, ni enako izrazitega vodilnega modela.
Dostop do več ponudnikov v enem vmesniku zaposlenim po navedbah Perplexityja olajša menjavanje modelov brez ločenih prijav in pogodb. To je hkrati osrednji argument podjetja za lastno platformo.
Priljubljenost novega modela lahko po izdaji hitro naraste in nato upade. Avtorji zato sklepajo, da je za podjetja prilagodljiv dostop do modelov koristnejši od trajne zaveze današnjemu »zmagovalcu«.
Po navedbah Perplexityja njegovo storitev uporablja 92% podjetij s seznama Fortune 500, med njimi šest podjetij iz skupine »Magnificent 7«. Članek ne podaja metodologije za preverjanje te trditve.
Januarja 2025 sta modela Claude Sonnet 4 in GPT-4o skupaj predstavljala 91,5% obravnavanih poslovnih poizvedb: prvi 47,5%, drugi 44%. Proti koncu leta so deleži vodilnih modelov znašali 23,3% za Gemini 3.0 Pro Thinking, 20,6% za Claude Sonnet 4.5, 10,7% za Claude Sonnet 4.5 Thinking in 7,9% za GPT-5.
Več kot en model je v letu 2025 vsaj enkrat uporabilo 43,6% poslovnih organizacij. Več modelov v istem dnevu je uporabljalo 9,1% poslovnih uporabnikov.
Med uporabniki, ki sami izbirajo posamezne modele, jih je 53% v letu 2025 vsaj enkrat zamenjalo model znotraj istega delovnega dne. Delež ne velja za vse uporabnike platforme.
Pri programskih poizvedbah so uporabniki v 38% primerov izbrali model Claude. Decembra 2025 je bil pri odpravljanju napak najpogostejši Claude Sonnet 4.5 s 30%, pri finančni analizi pa Gemini 3.0 Pro Thinking z 31%.
“Enterprise usage data shows employees are now treating models as a menu of options, not a single default tool.” — Osrednja teza članka: zaposleni modele obravnavajo kot nabor možnosti.
“The top 50 enterprise accounts use 30 models on average versus seven for typical accounts.” — Največje stranke v povprečju uporabljajo precej več modelov kot običajne.
“But programming is the exception. For every other function, the lead is less clear.” — Izrazita prednost modelov Claude pri programiranju se ne ponovi pri vseh nalogah.
“New models typically spike above 50% of enterprise usage for a few days following their release” — Nove izdaje začasno pritegnejo velik delež uporabe.
“When the landscape shifts this quickly, access to every option matters more than choosing today’s best one.” — Zaključni argument avtorjev daje prednost možnosti izbire pred enim stalnim modelom.
ChatGPT naj bi gradil lastno iskalno infrastrukturo z več specializiranimi indeksi, zato ga ni ustrezno opisati le kot uporabnika Googla ali Binga.
VIR:
https://x.com/TomekRudzki/status/2095886026363293717
BISTVO:
ChatGPT-jev sistem za pridobivanje virov se po objavi interno imenuje Labrador in obsega več ločenih indeksov, ne enega samega.
Omenjeni so indeksi za splet, PDF-je, YouTube, novice, arXiv, Wikipedijo, lokalne rezultate, finance, pravo, medicino, nakupovanje in slike.
Nick Turley, vodja ChatGPT, naj bi na protimonopolnem zaslišanju v ZDA leta 2025 pod prisego povedal, da je bil razvoj lastnega indeksa del načrta OpenAI od začetka.
OpenAI naj bi želel tudi Googlove podatke, ne zato, ker lastnega sistema nima, temveč za izboljšanje kakovosti rezultatov in lastnega indeksa.
Nedavni zaposlitveni oglasi za podatkovne sisteme v eksabajtnem merilu po navedbah avtorja kažejo, da OpenAI v to infrastrukturo še naprej intenzivno vlaga.
DEJSTVA:
Avtor objave je Tomek Rudzki (@TomekRudzki), povezan s podjetjem oziroma platformo Peec AI.
Objavljena je bila 4. septembra 2026.
Sistem je v objavi poimenovan Labrador.
Navedeno zaslišanje naj bi potekalo leta 2025.
Objava omenja obseg infrastrukture na ravni eksabajtov, kar pomeni vsaj 1 milijardo gigabajtov podatkovnega prostora na eksabajt. Prvi del navedbe izvira iz objave, pretvorba enote pa je standardna definicija.
CITATI:
“ChatGPT’s retrieval system, internally called Labrador, isn’t one index.”
“It’s a family of indexes: general web, PDF, YouTube, news, arXiv, Wikipedia, local, finance, legal, medical, shopping, images.”
“Building an in-house index was the plan from day one.”
“Job postings talk about exabyte-scale database systems.”
“We heavily underestimate ChatGPT … reducing its impact to ‘they use Google’, ‘they use Bing.’”